酵母双杂交筛库的质量控制:从诱饵可用性到阳性克隆归一化的实战判据
筛库做不出互作克隆,问题往往不在"有没有互作",而在四道前置闸门是否被逐一验证。本文不谈原理,只谈判据:每一个质量节点该测什么、阈值取多少、失败时往哪个方向退。
做过酵母双杂交筛库的人都熟悉那个经典场景:四重缺陷培养基上挑出几百个菌落,PCR 之后回收质粒、测序、BLAST 一遍,最后能经得起回转验证的只剩下两三个。有的实验室此时会归因于"这个互作比较弱",然后草草收场。但把问题拆开看,真正决定成败的其实是筛库之前那几天的质控动作——诱饵是否对酵母有毒、是否自带报告基因泄漏、融合蛋白是否真的表达出来、转化覆盖是否够数。这四项任意一项没做扎实,后续所有工作量都建立在流沙上。
本文把筛库流程拆成一条带质量闸门的流水线。每一道闸门都给出可量化的判据、明确的通过标准,以及不通过时的退路选择。这不是综述式的原理复述,而是一份可以在实验记录本上逐条打勾的核查清单。
01、闸门思维:为什么顺序不能颠倒
双杂交体系里,诱饵(bait)融合蛋白承担着全部的不确定性。它要被酵母翻译出来、要被运进细胞核、要在一个开放的三羧酸循环体系里稳定存在、还不能自己把报告基因点亮。这几个要求互相牵制,一个环节出问题会伪装成另一个环节的症状。所以质控的关键不是"检查得全",而是"检查得按能定位故障的顺序排"。
这个顺序是:毒性 → 自激活 → 表达量 → 文库覆盖。理由很直接。毒性如果没排除,后面所有的生长对照都失去可比性——你分不清菌落少是因为诱饵抑制了细胞,还是因为互作没发生。自激活如果没压住,你挑到的每一个"阳性克隆"都可能只是背景泄漏加随机漂移。表达量没确认,你面对的"无阳性"可能是融合蛋白压根没生成。文库覆盖不够则是最后一道数学关卡,前面全都做对了也可能因为抽签没抽中而空手而归。
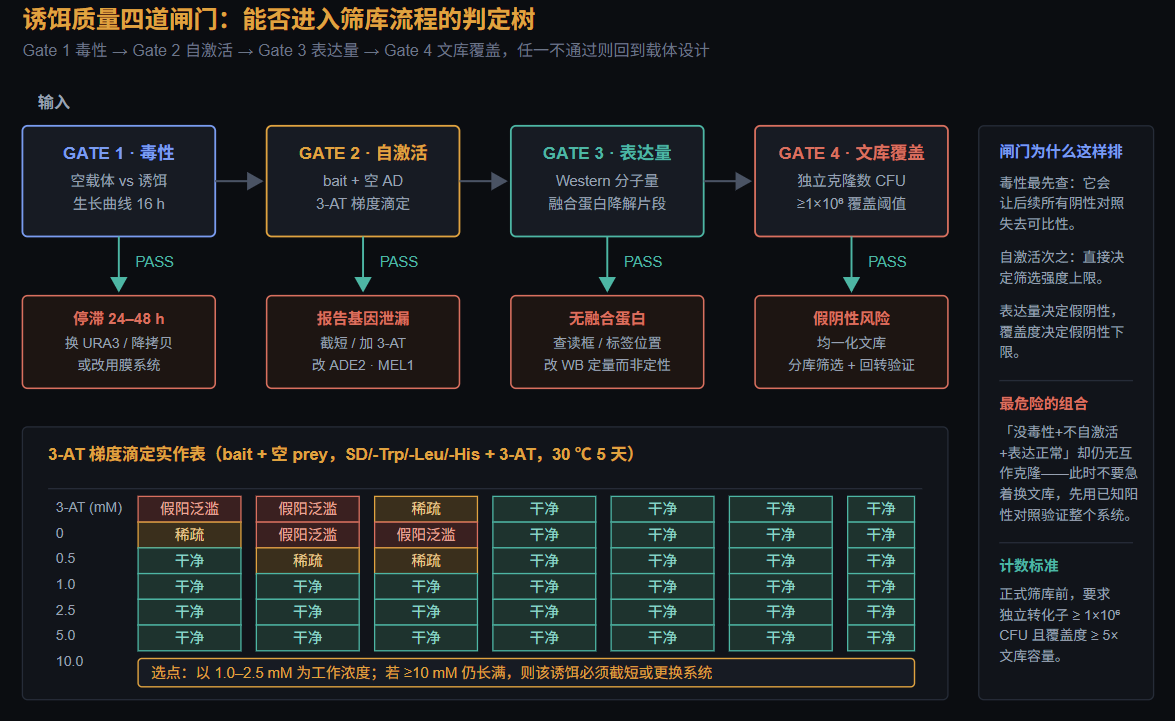
图 1 · 诱饵四道闸门与 3-AT 滴定左侧为进入筛库前的四道强制闸门及各自的失败表现与退路;右下为一份 3-AT 梯度滴定的实作记录表,用于确定工作浓度。经验上以「假阳刚好被压住、且高于此浓度的下一个梯度仍有稀疏生长」作为取值区间。
闸门一:毒性检测要看生长曲线,不是看平板
毒性检测最常被简化成"挑一个单克隆,接液体培养基,测 OD"。这个做法能发现问题,但发现得太晚——等到 OD 明显偏低,整套实验的转化效率基线已经被拉低了。更有信息量的做法是同步生长曲线:把含空载体和含诱饵载体的两份菌液在同一天、同体积、同转速下培养,每隔 2 小时测一次 OD600,连续 16–24 小时,把两条曲线画在同一张坐标上。
判读标准比"是否生长"精细得多。健康菌在 YPDA 里的典型双相曲线是 6–8 小时进入对数期、12 小时前后 OD 触及平台。如果诱饵菌的延滞期比对照晚 3 小时以上,或者平台 OD 低 30% 以上,说明诱饵蛋白给细胞带来了显著负担。还有一种更隐蔽的表现:两条曲线最终平台几乎一样,但对数期的斜率明显不同——这种情况说明细胞在生长早期付出了额外代价,后期通过提高存活率弥补回来了,转化环节却正好落在对数期早期,受害最重。
毒性来源通常有三个,按排查顺序处理。第一是融合蛋白错误折叠形成包涵体,对细胞产生毒性;第二是诱饵本身与酵母内源通路存在功能互作,干扰了宿主代谢;第三是标签位置不当,例如把 GFP 或大标签放在 N 端且正好挡住核定位信号,导致蛋白被错误定位到细胞质并被降解。
处理手段按侵入性从低到高排列:先换标签位置(把标签移到 C 端,同时在诱饵 N 端补一段核定位信号);再考虑换选择标记(把 TRP1 换成 URA3 或 HIS3,降低因标记弱导致的表达量下降);最后才考虑截短。对于超过 750 个氨基酸的大分子蛋白,直接做全长筛库的成功率本来就低,更务实的做法是先做结构域片段的分库筛选,把全长留到后期验证阶段。
判据速查 · 毒性闸门
- 通过线:延滞期差值 ≤ 2 h,平台 OD 差值 ≤ 20%,对数期斜率差 ≤ 15%
- 警戒线:任一指标超标但菌仍能生长 —— 可筛库,但必须在数据解释时对弱互作留出余量
- 弃用线:诱饵菌在 YPDA 中无法进入对数期,或 24 h 仍停留在低 OD 平台
- 禁止做法:仅凭平板上"能长出单克隆"就判定无毒性
闸门二:自激活的量化,而不是"有或没有"
自激活检测的经典做法是把诱饵载体和空猎物载体共转化,然后涂布缺组氨酸培养基,看长不长。但这个二元判断信息量太低:漏检的那些"弱自激活"诱饵,会在筛库进行到第三天、菌落铺满整块板子的时候才暴露,此时已经浪费了大量筛库成本与人力。真正有用的做法是3-AT 梯度滴定——把报告基因的竞争性抑制剂浓度做成梯度,画出一条"浓度-生长"曲线,从曲线上读出压制所需的阈值。
为什么 3-AT 能起作用,需要理解它的作用位点。HIS3 编码组氨酸生物合成途径中的咪唑甘油磷酸脱氢酶,催化咪唑甘油磷酸到组氨酸的最终一步。3-AT 是这个酶的竞争性底物类似物,会占据活性中心但不能被转化,从而把酶的表观活性拖低。当诱饵本身只泄漏一点点 HIS3 时,外加一定浓度的 3-AT 就能把这点泄漏彻底压住,让背景菌落消失;而真互作激活的报告基因表达量远高于泄漏量,对 3-AT 有更强的抵抗力——这就是"用竞争性抑制剂拉开差距"的原理。
实作上做九梯度:0、0.5、1、2.5、5、10、20、50、100 mM。每一梯度至少三个平行培养皿,30 ℃ 培养 5–7 天后计数。判读逻辑不是"哪个浓度不长就选哪个",而是找菌落数开始急剧下降的拐点区间,取拐点后第一个仍有稀疏生长的浓度作为工作浓度。这样设置的作用是:既保证背景被压住,又不给真实弱互作留太紧的门。如果选最低的"完全不长"的浓度,弱互作会被一并压掉,后续就永远不知道自己漏掉了什么。
一个容易被忽略的细节:3-AT 只压制 HIS3 报告基因,对 ADE2、MEL1、lacZ 这类报告基因无效。如果菌株同时携带多个报告基因,3-AT 的浓度优化就必须与另一条独立的筛选路线交叉验证,不能只盯着缺组氨酸平板。
3-AT 的浓度上限经验值是 80 mM。超过这个浓度仍能长满的诱饵,说明泄漏量已经大到竞争性抑制无法处理,此时截短是唯一出路——目标是切掉自激活结构域。这两个结构域在转录因子类蛋白中尤其常见:酸性激活区(比如 Gal4 的最后 112 个氨基酸)、谷氨酰胺富集区,以及某些锌指蛋白的转录激活片段。截短时务必保留完整的互作结构域,Western blot 确认截短后融合蛋白仍正常表达,且分子量符合预期。
如果诱饵的某个片段自激活强烈而全长蛋白并不如此(这在全长筛选中被泄漏掩盖了),可以把已知互作域单独切出来做成"结构域诱饵"直接进入筛库。代价是可能漏掉依赖全长构象的弱互作,收益是能真正筛出东西——在项目推进的现实压力下,这笔交易往往划算。
02、文库覆盖:把"转化了多少"换算成"抽签有没有抽中"
筛库最令人沮丧的结局不是假阳性爆炸,而是零阳性克隆。这个结果通常被误解为"没有互作蛋白",但更多时候是覆盖率不足导致的统计性漏检。要把直觉换成计算,需要三个数字:文库的总容量(以独立克隆数计)、实际获得的独立转化子数(CFU)、以及目标互作蛋白在文库中的丰度。
计算基于泊松分布。文库中某个特定基因被至少命中一次的期望覆盖率可以这样估算:把独立转化子数除以文库容量,得到该基因平均被抽中的次数;再套用泊松分布,至少命中一次的概率 = 1 − e−λ(λ 为平均命中次数)。实际操作中还要乘一个丰度因子——如果目标蛋白在源组织中表达丰度极低,其在文库中的拷贝数远低于 1,有效 λ 会显著下降。
| 独立转化子 CFU | 文库容量 | 有效 λ | 至少命中一次概率 | 解读 |
|---|---|---|---|---|
| 1×10⁵ | 1.5×10⁶ | 0.067 | 6.5% | 几乎必然漏检,不足以筛库 |
| 5×10⁵ | 1.5×10⁶ | 0.33 | 28% | 仅适合已知强互作的验证性筛查 |
| 1×10⁶ | 1.5×10⁶ | 0.67 | 49% | 可接受下限,实际项目应再翻倍 |
| 3×10⁶ | 1.5×10⁶ | 2.0 | 86% | 常规筛库工作区间 |
| 1×10⁷ | 1.5×10⁶ | 6.7 | 99.9% | 追求低丰度互作时的目标值 |
这张表的意义在于把"我转化了 200 个菌落"和"我获得了多少独立转化子"区分开。转化效率常以 cfu/μg DNA 报告,但真正的分母是独立克隆数:同一次转化中多个细胞获得同一质粒不算独立事件。电穿孔条件下的转化效率常能到 3.7×10⁵ 到 4.8×10⁵ cfu/μg 这个量级,配合 7 μg 文库质粒,得到的独立转化子数足以让每个潜在互作蛋白被独立覆盖多次。锂醋酸法虽然效率低一个数量级,成本低、污染少,对于绝大多数点对点验证和小规模筛库完全够用。
提高覆盖率有三条路,按性价比排序。第一条是分库筛选:把文库按物种、组织或表达谱拆成若干子库依次筛,每个子库只需 1/3 到 1/5 的转化量就能达到同等覆盖,整体上反而更快出结果,还顺带获得了"互作的组织特异性"这一额外信息。第二条是提高转化量:简单粗暴但有效,文库质粒从 20 μg 加到 50 μg,电穿孔用更高浓度的细胞悬液。第三条是文库均一化:用核酸酶剪切把文库打成随机分布的短片段,消除高表达基因的强优势,让低丰度 cDNA 得到富集。这条路成本最高,但对低丰度互作的提升最明显。
交配效率:一个被普遍低估的变量
把诱饵菌和文库预转化的猎物菌混合,在液相中培养让其融合成二倍体,这个过程叫 mating。交配效率直接决定后续二倍体筛选平板上的菌落数量。很多实验室把"菌落太少"归咎于转化失败,实际上有一半概率问题出在交配上——因为 mating 之后二倍体还要经历一次筛选压力,效率低的那些就彻底消失了。
影响交配效率的因素中,菌株的接合型(mating type)匹配是第一位的,必须是 MATa 与 MATα 配对,这一点在菌株表型标注里要提前确认。液体交配时的细胞浓度比更微妙:太浓会形成团块降低接触面积,太稀则二倍体数量不足,实践上把两份菌液都调整到 OD600 约 1.0–1.5 混合是比较稳的区间。交配时间在 4–6 小时足够,超过 12 小时后杂合生长开始占据优势,反而拖慢后续筛选。
二倍体的筛选依赖营养互补:诱饵载体带 TRP1,文库载体带 LEU3 或 LEU2,两个标记在单倍体中都不完整,只有融合成二倍体才能同时表达。所以 -Trp/-Leu 双缺平板上的菌落数就是二倍体的真实数量,而这个数应该接近两个单菌转化量的乘积下界。如果明显偏低,需要回头查:PEG 残留是否过多(会降低融合效率)、离心是否太猛(损伤细胞壁)、以及是否在交配后做了过度洗涤。
03、阳性克隆的漏斗淘汰:每一级剪掉什么
初筛阳性的克隆里,超过 90% 的信号在重复检验时会消失。这个数字听起来夸张,但它是双杂交工作者的共识经验——原因在于报告基因泄漏、随机碰撞、质粒拷贝数波动这些机制产生的信号"不可复现"。因此,漏斗式淘汰不是可选的质量优化,而是必须执行的标准流程。
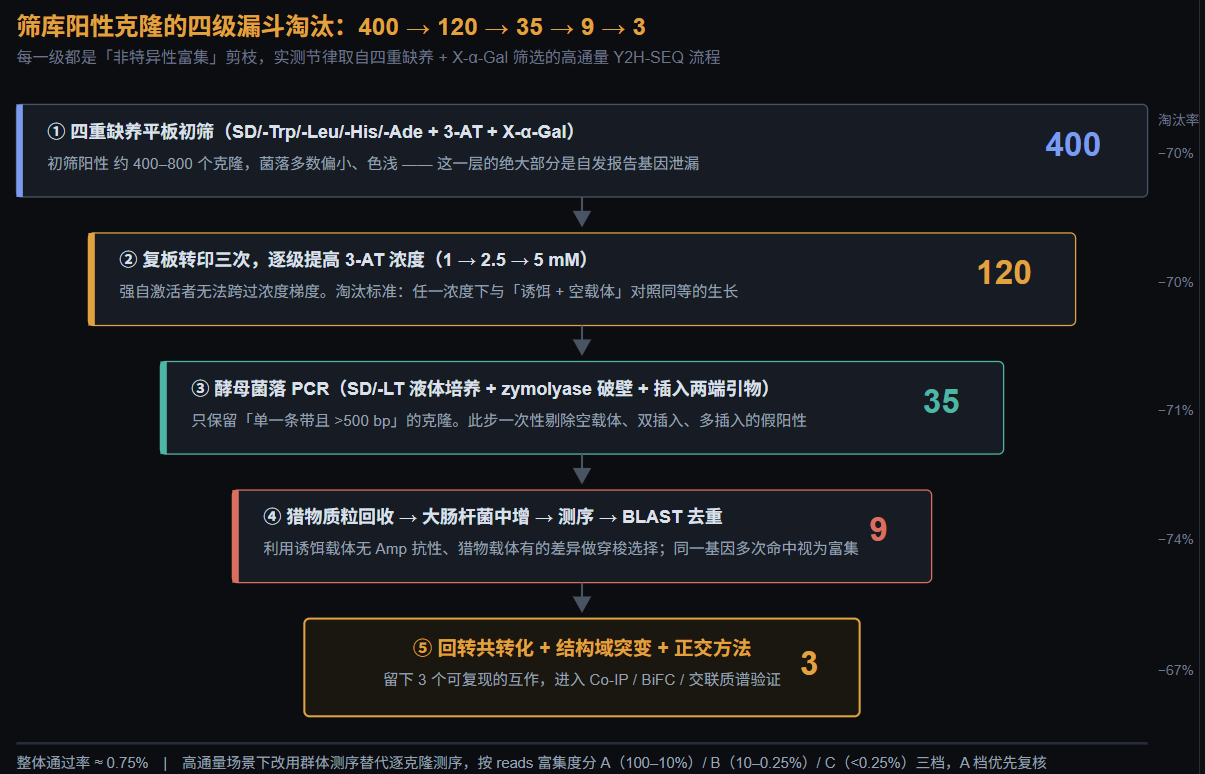
图 2 · 阳性克隆的四级漏斗淘汰每一级的判定动作与剪枝效果。四级处理后整体通过率通常在 1% 以内,剩下 3–5 个克隆才值得投入正交验证。若某一级剪枝率异常偏高(如菌落 PCR 阶段砍掉七成以上),往往提示前面某道闸门没做扎实。
第一级:复板转印与 3-AT 递增
初筛平板上的菌落直接转移到含更高 3-AT 浓度的新平板上,通常做 1 → 2.5 → 5 mM 三级递增。淘汰标准不是"在哪一级不长",而是"在哪一级开始与对照同等地长"。这里必须同时保留"诱饵 + 空猎物"在同一浓度梯度上的对照板,否则没有参照就无法判断强弱。
高通量场景里这一步还有个更省事的选择:把初筛板用 replica plating 工具一次性转到多个浓度的 3-AT 板上,菌落位置一一对应。有一类特殊现象值得注意:某些文库会自身携带"粉红草坪"式的背景生长——整块板呈现均匀的淡粉红色而非离散菌落,这是文库载体本身携带的背景导致的,处理办法是继续提高 3-AT 浓度,浓度合适时草坪消失,此前被淹没的互作克隆会重新显现出来。这是个典型的"假阴性被假阳性掩盖"的案例。
第二级:酵母菌落 PCR —— 一次操作剪掉三分之二
这一步的技术含量集中在两个细节。破壁:酵母细胞壁对 PCR 抑制因子高度敏感,直接把菌液加进 PCR 体系基本无效,需要先用 zymolyase(或溶菌酶、玻璃珠)处理到菌体变成透明状态。处理不足会导致扩增不出来,处理过度会损伤 DNA。经验起点是 zymolyase 在 30 ℃ 作用 30 分钟左右,观察菌液是否从浑浊转为清亮。引物设计:引物落在插入片段两端,可以一次性排除空载体克隆(无扩增产物)和多插入克隆(多条带),这是这一级剪枝效率高的关键。
判定标准是"单一条带且长度大于约 500 bp"。长度下限不是硬性标准,但如果你的文库插入片段普遍在 0.5–3 kb,那么小于 500 bp 的产物大概率是引子二聚体或非特异扩增,而不是真实插入。实际操作中常把这批短条带的克隆也送去测序——它们有时对应真实的短ORF,只是概率较低,测序成本已经足够低,没有必要在判读阶段过度自信。
PCR 产物在送测序前需要用 Exonuclease I 去除残余引物、Shrimp Alkaline Phosphatase 去除残余 dNTP。这一步的原理是未去除的引物会在测序起始位点形成叠加峰,读出的前 20–30 个碱基全部是双峰混合,从第 20 位之后才开始清晰——很多"测序失败、峰图乱"的返工案例实际只差这一步。
第三级:猎物质粒回收与穿梭技巧
PCR 合格的克隆进入液体培养后提取质粒。这里有一个巧妙的操作要点:从酵母提取出来的质粒是诱饵质粒和猎物质粒的混合物,但两者携带的抗生素抗性标记不同——通常诱饵载体带 Kan 抗性,猎物载体带 Amp 抗性。把酵母质粒直接转化进大肠杆菌 XL1-blue,只在含 Amp 的 LB 平板上选择,就能只拿到猎物质粒,跳过繁琐的酶切分离。这一步利用的是抗性标记的差异而非引物设计,是双杂交实验里最实用的技巧之一。
易错点 · 三框文库与移码
三框文库的设计目的是不移码——文库表达的目的蛋白群里,总有一个正确读框的产物,而不是保证每个克隆都不移码。因此出现移码克隆是正常现象,理论上只有读框正确的克隆才会进入报告基因激活通路。真正需要警惕的是测序峰图上某个位点缺失导致序列移码——这种情况必须回到原始测序文件手动校正序列,而不是只看数据库比对结果就下结论。
第四级:回转验证与结构域突变
回收的猎物质粒重新与诱饵质粒共转化,进入新鲜的酵母细胞。这一步排除了"自发突变导致的表型"——如果不用回转,酵母在初筛平板上生长过程中可能积累了某个突变,使得报告基因异常激活,这类克隆回转后会消失。回转验证要求至少重复两次,四重缺养 + X-α-Gal 的条件下结果一致才能判定为可复现互作。
结构域突变是加分项操作。把诱饵按预测的互作结构域切成若干片段,分别与同一猎物共转化。如果只有含有特定结构域的片段能激活报告基因,互作位点的证据强度会上一个台阶。这项实验的额外成本不高,但对审稿人来说是很有说服力的补充。
失败模式的归因速查:把现象翻译成动作
筛库过程中出现的每一种异常表现,几乎都能在少数几个成因里找到对应。与其从头排查,不如从现象反查——这张表是从现象出发的归因路径,每一行给出的第一个动作,都是"区分真假"性质的动作,而不是"修改条件"性质的盲目尝试。
| 观察到的现象 | 最可能的成因(按概率排序) | 第一个应做的动作 | 不要立刻做的事 |
|---|---|---|---|
| 初筛板菌落数极多、呈粉红草坪 | 诱饵自激活未被压住;文库载体自身背景;3-AT 浓度过低 | 取同一块板做 3-AT 递增转印,确定草坪消失的临界浓度 | 不要直接把板丢弃重做,也不要盲目提高 3-AT 到 20 mM 以上 |
| DDO 板菌落少,QDO 板完全不长 | 诱饵毒性;诱饵未表达;猎物文库转化效率低;交配效率低 | 用空猎物载体与诱饵共转化,单独验证诱饵的转化与生长能力 | 不要先怀疑"没有互作蛋白",此时系统本身未通过验证 |
| DDO 正常,QDO 零生长 | 互作确实弱或不存在;核定位缺失;折叠错误;报告基因灵敏度不足 | 先跑阳性对照确认本批次系统可用,再考虑更换高灵敏度菌株 | 不要连续更换三个不同文库,这条路径的成本收益极差 |
| 菌落 PCR 大量空载体(无扩增产物) | 引物设计位置不对;破壁不足;PCR 体系抑制 | 取 3 个克隆做梯度稀释 PCR,确认是破壁还是引物问题 | 不要放弃菌落 PCR 这一级——它是剪枝效率最高的一步 |
| PCR 多条带普遍 | 克隆未纯化(多细胞克隆共存);引物二聚体 | 重新划线纯化 2–3 次后复测;同时检查引物浓度与退火温度 | 不要把多条带样品直接送测序,测序成本会被浪费在无信息读段上 |
| 回转验证结果与初筛不一致 | 酵母在初筛过程中积累了自发突变;质粒在扩增中重排 | 从原始菌落重新提质粒再次回转,区分"表型丢失"与"质粒改变" | 不要据此直接判定互作为假,除非重复三次以上均不复现 |
| 同一诱饵在两次筛库中结果差异极大 | 融合蛋白表达不稳定;质粒在酵母中丢失;3-AT 浓度未真正标定 | Western blot 比较两批次的融合蛋白量差异 | 不要简单归因于"文库不同",先排除表达量这个变量 |
这张表里最值得强调的是倒数第二行。双杂交实验中,融合蛋白的表达量在不同批次之间可以有数十倍波动,而表达量直接决定互作信号的输出强度。如果不把 Western blot 的定量结果和筛库批次关联起来,任何"两次结果不一致"的讨论都是在讨论一个未受控的变量。记录的表达量数据不是附属信息,而是解释后续所有信号的前提。
融合方向与标签位置:一处极易忽略的干扰源
点对点验证时,诱饵与猎物的融合方向值得单独说明一次。GAL4 的 DNA 结合域在 N 端、激活域在 C 端,把目标蛋白融合到 BD 下游意味着它在融合蛋白的 C 端——这一侧通常不影响原有的核定位信号,因为核定位信号多在蛋白自身的 N 端附近。如果目标蛋白的核定位序列在 C 端,它在融合后就失去了定位能力,会被滞留在细胞质,无法参与报告基因激活。
解决办法有三种,按优先级:给融合蛋白补一段外源核定位信号(如 SV40 的 NLS 序列,PKKKRKV),这是最省事也最常用的;在诱饵构建时保留目标蛋白 N 端的天然 NLS 序列不被标签遮挡;如果目标蛋白天然没有 NLS,则考虑把整个诱饵做反向融合,同时把激活域换到另一侧以维持空间关系。
标签位置还会带来读框问题。设计引物时必须保证目标基因的终止密码子被去掉,读框一直通读到融合标签,否则 Western blot 上会出现"标签正常但融合蛋白不见"的现象——因为抗体识别的是标签,而标签根本没有被翻译出来。这也是为什么 Western blot 验证要用标签抗体和目标蛋白抗体两套:前者确认标签表达,后者确认融合完整。两者信号不一致时,几乎必然是读框或剪接出了问题。
假阳性排查四组对照:唯一不能省的四支试管
双杂交的对照组设置不是形式主义,而是数据可信度的数学基础。完整的一套需要四组,缺一不可。
| 对照 | 构成 | 预期表现 | 排除的干扰 |
|---|---|---|---|
| 阳性对照 | p53 诱饵 + LargeT prey | 四重缺养板上正常生长、lacZ 变蓝 | 验证整套系统、报告基因、3-AT 浓度本身可用 |
| 阴性对照 | Lam 诱饵 + T prey | 三/四重缺养板上均不生长 | 排除酵母本身的报告基因噪声 |
| 空载体对照 | 你的诱饵 + 空 AD | 不生长(或在指定 3-AT 浓度下不生长) | 检测诱饵自身的自激活与泄漏 |
| 反向对照 | 你的猎物 + 空 BD(或互作对互换位置) | 与正向结果一致 | 排除融合方向、读框、标签遮挡带来的位置特异性假象 |
当筛库零阳性克隆时,第一个要问的问题不是"我的蛋白有没有互作对象",而是"阳性对照 p53/LargeT 在本批次条件下能不能长出来"。如果阳性对照也不长,说明是 3-AT 浓度过头、菌株状态不对或报告基因被抑制,此时更换文库是浪费,只有把系统修好才可能拿到结果。
05、高通量场景:Y2H-SEQ 如何改变筛库逻辑
当筛库规模从几十个克隆扩大到几百组诱饵—文库组合时,逐克隆测序的成本和时间都不再可行。Y2H-SEQ 的思路是把最后一级"菌落 PCR + 测序"改成"群体收获 + 群体 PCR + 测序",用读段数(reads)作为定量指标替代单克隆鉴定。
流程上的差别在于:把最后一个筛选板上的所有阳性克隆整板刮下收进一个孔里,直接提取总的猎物片段并做 PCR,然后用 300 bp 双端测序。这样每个样品平均能拿到一万条以上的读段,足以对猎物分布做定量刻画。
数据处理的关键是富集度分级:把归一化后的读段数占比分成三档——A 档(100–10%)优先复核,通常对应真实强互作;B 档(10–0.25%)需要回转验证确认;C 档(<0.25%)多为背景。这类分析里有一个非常实用的信号:读段显著偏向与 GAL4-AD 基因处于同一读框的片段。如果数据呈现这个富集模式,说明筛选的特异性良好,筛出的片段大概率是真的;反之,如果读段分布弥散、没有读框偏好,说明这批数据以背景为主,不宜直接采信。
读帧偏好作为内建质控指标
读帧富集分析之所以好用,是因为它不依赖任何外部对照——数据自己就说明了筛选是否具有序列特异性。相比之下,靠挑菌落、看颜色、算菌落数得到的"阳性"本质上都是间接证据。这个思路可以迁移到手头的传统筛库上:如果条件允许,对克隆池做一次群体 PCR + 测序,用读帧偏好评估整批数据质量,往往比多挑二十个克隆做单克隆 PCR 更有信息量。
06、从信号到结论:证据强度阶梯
筛库产出的从来不是"结论",而是一个需要被推进或被淘汰的候选。正因如此,对结果的诚实表述方式是说明证据位于哪一级。L1 级是"提示互作存在":仅有酵母体系内的报告基因激活,加上可复现的回转验证。这一级足以支撑"我们发现了一个候选互作"的表述,但不足以支撑功能推断。L2 级要求在生理相关的哺乳动物细胞中得到独立验证——Co-IP、BiFC 或 PLA 都算。L3 级要求把互作与表型建立因果联系,通常通过功能获得/缺失的双向实验完成。
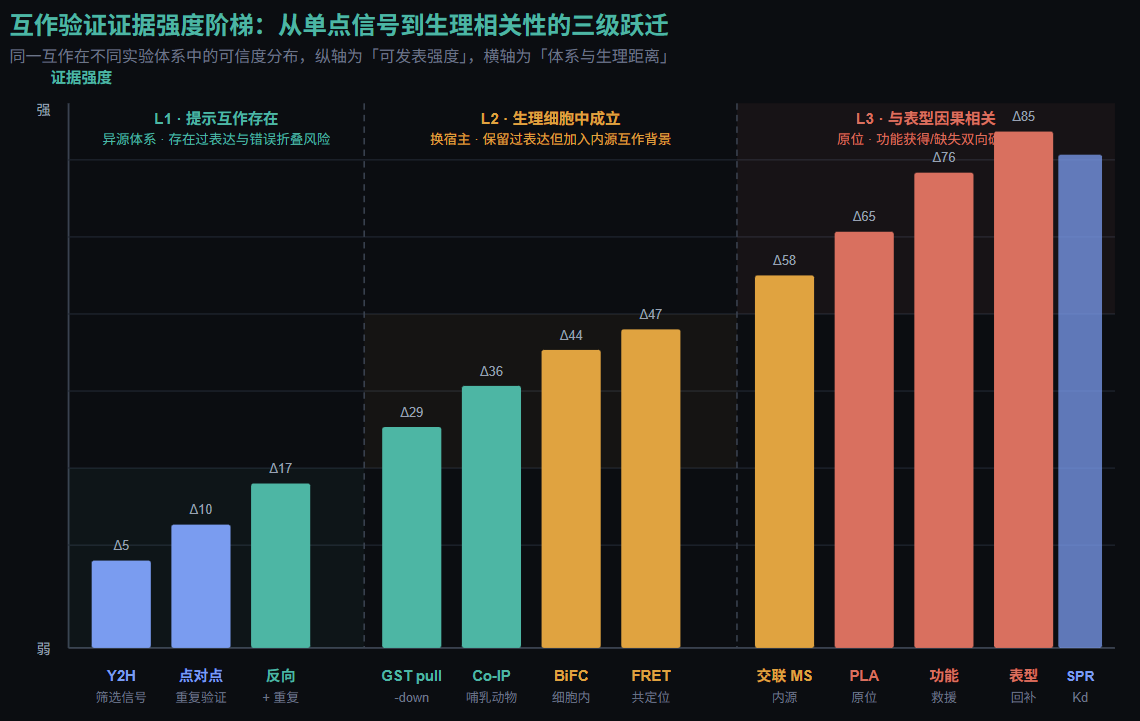
图 3 · 互作验证的证据强度阶梯横轴为体系与生理距离的远近,纵轴为证据强度。同一互作从 L1 推到 L3 需要跨越两次本质跃迁:从"能长出菌落"到"能拉下复合物",再到"改变这个互作会改变细胞命运"。审稿意见中反复出现的"功能相关性证据不足",指向的就是 L2 到 L3 的缺失。
每种验证方法都有它自己的天花板,选错方法比不做更糟。GST pull-down是体外重构,对标签蛋白的折叠依赖很强,阴性结果说服力有限,但阳性结果可信。Co-IP能证明同一复合物,但无法区分直接结合与间接桥接;如果互作较弱,内源表达量是主要瓶颈。BiFC的原理是不可逆的荧光互补,信号一旦产生就锁死,因此瞬时转染时容易积累背景,阴性对照必须严格。PLA是原位方法,空间分辨率高,适合验证共定位,但需要优化抗体组合。SPR能给出 Kd 定量,但要求两侧蛋白都能高纯度制备,对很多细胞内互作蛋白不现实。
还有一类特殊情况必须提前规划:膜蛋白互作。经典核体系 Y2H 无法处理它们,因为融合蛋白进不去细胞核。这类靶标应当一开始就切换到分裂泛素体系(MbYTH),而不是先在核体系里耗三个月再发现全是假阴性。同理,胞内信号通路的强负调控蛋白、组成型大分子复合物组分、翻译后修饰依赖的蛋白,都有较高的假阴性风险,需要提前设计退路。
07、一份可执行的收尾清单
把前面所有内容压缩成一张表,可以在筛库启动前逐条打勾。任何一条打不上勾,就先解决它再动手。
- 毒性曲线
空载体 vs 诱饵载体同步培养 16–24 h,每 2 h 测 OD600。延滞期差 ≤ 2 h、平台差 ≤ 20% 方可放行。
- 3-AT 滴定
0 至 100 mM 九梯度,三平行,取"完全压住背景后第一个仍有稀疏生长"的浓度。超过 80 mM 仍长满 → 截短或换系统。
- 表达确认
Western blot 检测融合蛋白,分子量符合理论值。检测方法优先用标签定量而非定性——无标签时用抗原固定或染色的方法测不可靠。
- 四组对照就位
阳性对照必须在本批次 3-AT 浓度下验证通过,才能确认筛选条件的严格度合理。
- 覆盖率核算
按独立转化子数 ÷ 文库容量算 λ,λ ≥ 2(3×10⁶ CFU 对 1.5×10⁶ 文库)为工作下限。
- 交配效率确认
-Trp/-Leu 双缺板菌落数应接近两单菌转化量乘积的下界,明显偏低需排查 PEG 与离心条件。
- 筛选条件预跑
先用低浓度 3-AT 试板确认报告基因会被真互作激活,避免全量铺板后发现条件过严。
- 菌落 PCR 前置
把引物设计、zymolyase 处理浓度、条带判读标准在开筛前全部走通,不要等到挑完 400 个克隆才发现 PCR 全是假阳性。
- 漏斗预排
为每一级淘汰预留缓冲:PCR 合格样本的预期比例、穿梭转化的抗生素选择、测序样品数。
- 正交方法预研
在拿到候选克隆之前就确认 L2 验证路线可行(抗体可用性、细胞系、转染效率),不要等三个月后才开始找。
双杂交筛库的技术门槛并不高,高的是纪律要求。绝大多数"筛不出结果"的案例复盘下来,问题都出在开工前的三四周:毒性没测就上样、自激活没压就铺板、覆盖率没算就转化。技术手段是现成的,判断依据也是明确的,唯独需要的是在诱惑着"先做了再说"的时候,把该测的东西测完。
把上面的闸门顺序和漏斗动作固化进标准操作流程,筛库就从一件依赖运气的手工活,变成一个有确定通过率的可预测实验。这大概是分子生物学里投入产出比最高的质量改进之一。
说明:本文数据区间与阈值来自公开试剂盒说明书、厂商技术文档与已发表筛库文献的常见做法汇总,具体数值需按所用菌株、载体与体系自行标定。所有流程建议在贵实验室 SOP 体系下完成并留档。
最新动态
-
10.15
酵母双杂交筛库的质量控制:从诱饵可用性到阳性克隆归一化的实战判据
-
10.15
酵母质粒小提的性能边界:破壁效率、纯度诊断与下游用途匹配
-
10.15
凝胶电泳迁移实验的判据体系:从泳道表达到单变量排查
-
10.15
细胞凋亡检测的证据链设计: 象限、时间窗与假阳性来源
-
10.14
LCA实验技术,连接酶介导的核酸扩增体系与生命周期评估方法学的双轨实践
-
10.14
荧光定量检测技术 | 定量体系的工程实现、多重探针设计与跨平台归一化
-
10.14
等温滴定微量热技术 | C值窗口设计、热力学解读与超强结合体系方案
-
10.13
噬菌体展示平台技术-文库构型、淘选策略与测序驱动候选挖掘
-
10.13
【分子检测技术平台白皮书】数字PCR、靶向测序与 ctDNA监测的分层架构
-
10.10
点对点验证试剂盒:读懂蛋白互作一对一验证的体系选择与证据链闭环
 X