噬菌体展示文库筛选策略与假阳性控制
一、噬菌体淘选流程中的关键参数调控
噬菌体展示文库的淘选(biopanning)看似流程简单,"吸附、洗脱、扩增"三步循环,但每一步的参数调控都会直接影响筛选结果的质量。先说第一步:抗原包被。抗原在固相上的固定方式决定了筛选的方向。直接包被到酶标板或免疫管是最常用的方式,操作简单,但有个隐患,直接吸附可能使抗原的部分构象表位被遮蔽,筛选到的抗体只识别吸附后的构象而不识别天然构象。如果最终应用是检测天然状态的抗原,这个问题就会暴露出来。
溶液筛选(solution panning)是针对这个问题的替代方案。将生物素化抗原与噬菌体文库在溶液中孵育,让两者在自由状态下结合,然后通过链霉亲和素磁珠捕获抗原-噬菌体复合物。这种方式保留了抗原的天然构象,筛选到的抗体识别天然表位的概率更高。但操作上需要多一步磁珠分离,且生物素化效率影响筛选效果,生物素标记过多可能遮蔽关键表位,标记过少则捕获效率低。建议每分子抗原标记2-4个生物素分子。
抗原用量也是一个需要优化的参数。第一轮筛选建议用较高抗原浓度(10-100 μg/mL),目的是尽可能多地捕获特异性结合的噬菌体,保证库容的多样性。后续轮次逐步降低抗原浓度(5-10 μg/mL甚至更低),增加筛选压力,淘汰低亲和力克隆。但浓度降低要循序渐进,如果第二轮就降到极低浓度,可能导致特异性噬菌体群体太小,文库多样性坍缩,后续无法获得多样化的候选克隆。
每轮筛选的投入噬菌体量建议控制在10^11-10^12 cfu。第一轮投入量可以大一些,覆盖文库的10-100倍以确保每个克隆都有机会结合。但投入量不是越大越好,过量投入会增加非特异结合的绝对数量,使后续洗脱群体中非特异克隆的比例升高。从第二轮开始可以适当减少投入量,因为第一轮扩增后的噬菌体群体已经富集了特异性克隆。
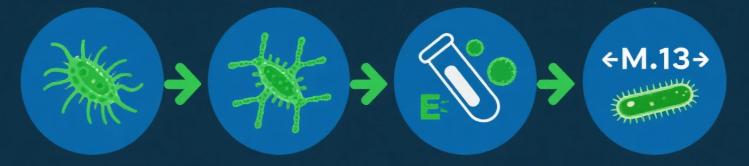
图1:噬菌体展示文库淘选(Biopanning)流程示意图
二、文库多样性评估与库容质量把控
噬菌体文库的质量直接决定了筛选的上限,一个多样性不足的文库,筛选策略再好也只能得到有限的候选克隆。文库质量评估有几个关键指标:库容大小、多样性、插入率和序列正确率。
库容大小通常用转化子数(cfu)来衡量。一个合格的scFv文库库容应该在10^8以上,肽文库至少10^9。但库容只是数量指标,更重要的是多样性,这些克隆中到底包含了多少不同的序列。评估多样性的方法是随机挑取50-100个单克隆测序,计算独特序列占比。如果50个克隆中有40个以上不同的序列,多样性较好;如果大量重复序列,说明文库在构建过程中发生了严重的偏倚或扩增瓶颈。
插入率检测用菌落PCR即可完成。随机挑20个克隆,用文库两侧的通用引物(如M13的前向和反向引物)做PCR,跑琼脂糖凝胶电泳看插入片段大小。插入率低于90%说明文库质量存在问题,需要排查电穿孔效率或连接效率。scFv文库的插入片段通常在700-800bp,肽文库(如7肽或12肽)约30-50bp(加上linker和框架序列总共约100-150bp)。如果PCR产物大小不一致,有几种可能:不完整插入、内含子残留(如果起始材料是基因组DNA而非cDNA)、或者载体自连产生的空载体。
序列正确率通过测序验证。随机挑10-20个克隆送测序,检查插入序列是否完整、有无移码突变、有无终止密码子提前出现。移码突变率低于5%是可接受的,如果移码率超过10%,需要回溯到建库阶段排查,最常见的原因是引物设计不当(同源臂长度不够或酶切位点设计不合理)或者PCR扩增时高保真酶的保真度不够。
文库保存也是一个容易被忽略的环节。构建好的文库应该在50%甘油中分装冻存于-80°C,每管100-200μL。每次筛选取一管使用,避免反复冻融。甘油终浓度不要低于20%,否则冻存过程中冰晶会杀死细菌。文库的有效期在-80°C条件下通常可以维持2-5年,但建议每6个月做一次库容滴度检测,确认文库没有显著降解。
三、假阳性克隆的来源分析与系统防控
噬菌体筛选中最让人头疼的问题就是假阳性,筛了三四轮,ELISA检测阳性,测序也拿到了序列,结果这个序列与靶标根本没有特异性结合。假阳性的来源是多方面的,必须系统性地分析才能有效防控。
第一类假阳性来源:噬菌体壳蛋白的非特异吸附。M13噬菌体的pIII和pVIII壳蛋白本身具有疏水性和电荷特性,容易非特异地吸附到塑料板壁、管壁甚至靶标蛋白表面。这种非特异吸附在低洗涤强度下会被保留,经过扩增后持续富集,最终成为优势克隆。防控手段:增加洗涤强度(延长洗涤时间、增加Tween-20浓度到0.5-1%),设置阴性靶标反向淘选(用不相关蛋白包被板做反向筛选,去除与塑料/基质非特异结合的噬菌体),逐轮提升筛选严谨度。
第二类假阳性来源:靶标不相关克隆(target-unrelated phage, TUP)。这类噬菌体不结合靶标蛋白,而是结合了靶标上的标签部分(如Fc-tag、His-tag、GST-tag等),或者结合了包被板上残留的BSA或封闭蛋白。排查方法:用标签蛋白单独做一轮反向淘选,去除与标签结合的克隆。另一种验证方法是:将筛选到的克隆用不同的标签系统重新表达(比如从His-tag换成GST-tag),如果结合消失,说明之前结合的是标签而非靶标本身。
第三类假阳性来源:大肠杆菌扩增偏好性。不同插入序列对宿主菌的感染和增殖效率不同,有些序列(特别是富含某些密码子的序列)在大肠杆菌中扩增更快,经过多轮"感染-扩增"循环后成为优势克隆,而这些克隆可能根本不具备靶标结合能力。防控手段:减少扩增轮数(一般3-4轮即可),每轮扩增后做滴度检测确保投入量一致,避免某一轮扩增过度导致偏倚放大。
第四类假阳性来源:靶标变性导致的表位暴露。如果靶标蛋白在包被过程中发生部分变性,原本埋藏在内部的疏水区域暴露出来,噬菌体结合这些"变性表位"的克隆会被富集。这些克隆在后续功能性实验中可能无法识别天然构象的靶标。防控手段:优先使用溶液筛选法,或者降低包被条件下的变性风险(4°C包被过夜代替37°C包被2小时,避免干燥)。
对全部候选克隆开展ELISA复筛是排除假阳性的最后一道防线。ELISA复筛应设置三组对照:靶标蛋白阳性组、无关蛋白阴性组、空白孔背景组。只有靶标组信号显著高于阴性组和背景组的克隆才算真阳性。建议每个候选克隆做3个重复孔,计算信噪比(S/N),S/N>3为阳性标准,S/N>10为高亲和力候选。
图2:噬菌体展示文库构建流程与多样性评估
四、洗脱条件优化:避免高亲和力克隆丢失
洗脱是淘选过程中容易被低估的环节。常规做法是用甘氨酸-盐酸(Glycine-HCl, pH 2.2)洗脱,原理是低pH破坏抗原-抗体之间的非共价结合。但这个方法有个致命问题,如果某些克隆的亲和力非常高(亚纳摩尔级别),pH 2.2的洗脱可能不足以将它们完全洗脱下来。这些高亲和力克隆被留在板子上,后续扩增中丢失,筛选结果偏向于中低亲和力的克隆,完全背离了筛选高亲和力抗体的初衷。
解决这个问题的第一个策略是提高洗脱强度。可以用更低的pH(如pH 1.8甚至pH 1.5),但过低的pH可能使噬菌体失活,感染效率下降。一个折中方案是:先用Glycine-HCl pH 2.2洗脱8-10分钟,再用Tris碱溶液(pH 11)洗脱5分钟作为补充。碱性洗脱可以作为酸性洗脱的补充,捕获极端高亲和力的克隆。但要注意pH 11以上的洗脱液对噬菌体的感染力有损害,洗脱后需要立即用Tris-HCl pH 7.5中和。
第二个策略是用特异性竞争洗脱。如果靶标蛋白是可溶的,可以用高浓度可溶性靶标蛋白(1-10 mg/mL)作为洗脱剂,与板上的靶标竞争性结合噬菌体。这种竞争洗脱方式只洗脱特异性结合的克隆,非特异吸附的噬菌体不被洗脱,洗脱群体的质量明显优于通用低pH洗脱。但需要大量可溶性靶标蛋白,成本较高。
第三个策略是直接感染法。不强求洗脱,而是把包被靶标的板/管直接加入对数生长期的大肠杆菌(OD600=0.5-1.0),37°C慢速振荡1-2小时。结合在板上的噬菌体可以直接感染大肠杆菌,不需要先洗脱下来再感染。这种方式避免了洗脱步骤的损失,对于高亲和力克隆的回收率最高。但非特异结合的噬菌体也会感染细菌,需要在后续轮次通过增加洗涤强度来去除。
洗脱后必须立即用Tris-HCl(pH 7.5, 1M, 50-100μL)中和,将pH拉回中性。中和后的洗脱液取1μL做滴度测定(10倍梯度稀释涂LB+抗生素平板),计算洗脱回收的噬菌体总量。第一轮洗脱回收量通常在10^4-10^6 cfu,后续轮次随着富集程度提高可以到10^6-10^8 cfu。如果某一轮洗脱回收量突然暴增(比如从10^5跳到10^9),很可能是非特异结合群体扩增导致的假富集,需要警惕。
五、单克隆鉴定的ELISA验证体系搭建
经过3-4轮淘选后,噬菌体群体已经富集了特异性结合克隆。但从群体到单克隆的鉴定需要一套可靠的ELISA验证体系。很多人在这步偷懒,只挑了10-20个克隆做ELISA,结果候选多样性不足,或者漏掉了真正的强结合克隆。
单克隆鉴定的第一步是挑克隆。从最后一轮筛选的平板上随机挑取48-96个单克隆,接种到96孔深孔板中,每孔含200μL 2xYT培养基+相应抗生素+M13 KO7辅助噬菌体(或IPTG诱导,取决于载体系统)。37°C 220rpm振荡培养过夜(12-16小时),离心取上清作为ELISA检测的噬菌体来源。过夜培养时注意不要超过16小时,否则噬菌体感染力下降,上清效价变低。
ELISA板包被靶标蛋白,浓度1-5 μg/mL,4°C过夜包被。第二天用3% BSA或5%脱脂牛奶封闭1小时。加入50μL噬菌体上清+50μL封闭液(1:1稀释),37°C孵育1小时。洗板4-5次后加入HRP标记的抗M13抗体(1:5000稀释),37°C孵育1小时。再洗板4-5次后加TMB底物显色,2M硫酸终止反应,450nm读数。
ELISA结果的判读标准需要预先设定。阳性阈值一般设为:OD450值>阴性对照平均值+3倍标准差,且OD450绝对值>0.5。有些实验室用信噪比S/N>3作为标准。建议每孔做2-3个重复,取平均值计算,排除孔间操作差异。同时设置一组不相关蛋白包被孔作为特异性对照,如果靶标孔阳性但不相关蛋白孔也阳性,说明该克隆不是特异性结合靶标,可能是结合了塑料基质或封闭蛋白。
ELISA阳性克隆需要进一步做亲和力排序。可以用不同浓度的靶标蛋白包被(0.1、0.5、1、5、10 μg/mL梯度),看哪些克隆在低浓度下仍能保持强信号,这些通常是高亲和力克隆。也可以做一系列噬菌体上清稀释度(1:2、1:5、1:10、1:50),比较不同克隆在稀释后的信号衰减速度,衰减慢的克隆亲和力更高。这种半定量ELISA排序虽然不如BIACORE精确,但成本低、通量高,适合在大量候选克隆中做初筛。
阳性克隆的序列分析同样重要。测序后做序列比对(用Clustal Omega或MegAlign),分析CDR区域的序列特征。如果多个克隆的CDR序列高度相似或完全相同,说明它们来自同一谱系,可以考虑合并或只保留信号最强的代表克隆。如果CDR序列差异较大但都特异性结合靶标,说明靶标上可能存在多个不同的表位,这对于开发抗体对(识别不同表位的配对抗体)是很有价值的信息。
六、NGS测序在噬菌体文库分析中的应用
传统的Sanger测序每次只能测几十个克隆,对于百万级多样性的文库来说只是冰山一角。NGS(高通量测序)技术的引入改变了噬菌体展示文库分析的方式,一轮测序就能获得数千到数万个克隆的序列信息,全面分析文库多样性和筛选动态。
NGS分析噬菌体文库的实验流程:从淘选各轮的洗脱产物中提取噬菌体DNA(也可以直接从洗脱产物做PCR扩增插入序列),用特异性引物扩增插入片段(scFv约700-800bp,肽约100-150bp),加测序接头后上机测序。对于scFv文库,建议用MiSeq平台做2×300bp双端测序,read拼接后覆盖完整scFv序列。对于肽文库,HiSeq或NovaSeq的PE150足够覆盖。
NGS数据分析的关键步骤包括:质量控制(去除低质量reads和接头序列)、序列去重(计算独特序列数量)、多样性评估(计算Shannon熵或Simpson指数)、克隆丰度排序(计算各序列的相对丰度)、以及CDR区域提取和分析。一个高质量的文库在淘选前的NGS数据应该显示高Shannon熵值(说明序列分布均匀),经过3轮淘选后Shannon熵显著下降(说明富集了特异克隆)。
NGS在筛选监控方面的价值尤为突出。通过对比各轮淘选的NGS数据,可以追踪特定克隆的富集轨迹,某克隆在第一轮占0.01%,第二轮上升到1%,第三轮到10%,这种持续上升的轨迹强烈提示该克隆具有靶标特异性。而某些克隆在某轮突然暴增但不持续,可能是扩增偏好性导致的非特异富集。这种动态监控是Sanger测序无法实现的,后者只能看到某一轮的静态切片。
NGS还能发现"沉默"的优质克隆。传统Sanger测序只挑48个克隆,如果某个高亲和力克隆恰好没被挑到就漏掉了。NGS可以分析数千个克隆的丰度排序,把丰度排名前100的克隆全部提取出来做进一步验证,大幅提高发现高亲和力克隆的概率。但要注意,丰度高不等于亲和力高,扩增偏好性可能导致低亲和力但高增殖力的克隆丰度虚高。NGS丰度数据需要结合ELISA验证结果来综合判断。
一种结合NGS和ELISA的优化策略是:先通过NGS获得各轮淘选的丰度排名前50序列,合成这些序列对应的肽或scFv,用可溶性形式做ELISA或BIACORE检测,直接验证亲和力。这种策略被称为"NGS to function",省去了传统单克隆鉴定的繁琐步骤,从序列到功能验证一气呵成,适合大规模筛选项目。
图3:噬菌体文库NGS测序与富集分析
七、亲和力成熟的策略选择与多轮筛选设计
从原始文库筛选到的抗体亲和力通常在纳摩尔到微摩尔级别,对于治疗性抗体或高灵敏度诊断试剂来说往往不够。亲和力成熟(affinity maturation)就是在这个基础上进一步提高亲和力的过程,噬菌体展示技术在这方面有天然优势。
亲和力成熟的核心逻辑是:在已获得候选序列的基础上,通过引入随机突变或定向突变增加文库多样性,然后用更严格的筛选条件(更低抗原浓度、更长时间洗涤、竞争洗脱等)施加选择压力,筛选出更高亲和力的变体。突变策略有几种选择:易错PCR(error-prone PCR)引入全基因组范围的随机突变;DNA shuffling将多个候选序列的片段重新组合;定点饱和突变在CDR区域引入全部20种氨基酸的随机化。
易错PCR是最简单的方式,通过调节PCR条件(降低dATP浓度、加入Mn2+替代Mg2+)引入随机突变。突变率控制在每kb 1-5个碱基替换比较合适,突变率太低多样性增加有限,太高则大量克隆丧失结合能力。易错PCR的产物需要重新克隆到噬菌体载体中,重新转化大肠杆菌构建成熟文库,库容要求与原始文库相当(10^8以上)。
CDR定向突变是更精细的策略。分析已有的抗体-抗原复合物结构数据发现,亲和力的提升往往来自CDR区域少数几个关键残基的变化。因此可以在6个CDR区域(L1-L3, H1-H3)中选定1-2个做饱和突变(用NNK密码子引入全部20种氨基酸),而保持框架区不变。这种策略产生的文库多样性集中在最可能改善亲和力的区域,有效克隆比例更高。但NNK饱和突变引入32种密码子,覆盖全部20种氨基酸,对于单个CDR(约10-15个残基)的突变文库库容要求就达到32^10以上,实际无法完全覆盖。解决方法是聚焦在CDR中最关键的3-5个残基做突变,将库容控制在可操作范围。
筛选条件的设计对于亲和力成熟至关重要。第一轮成熟文库筛选用与原始文库相当的抗原浓度(10-100 μg/mL),保证回收足够的多样性。第二轮开始施加选择压力:降低抗原浓度到1-5 μg/mL,延长洗涤时间从5分钟到30分钟甚至1小时,加入过量可溶性抗原做竞争洗脱(让低亲和力克隆在竞争中脱落)。第三轮进一步加压:抗原浓度降到0.1-1 μg/mL,甚至可以在溶液中做超低浓度筛选。多轮筛选后比较各轮洗脱产物的ELISA信号,信号逐轮增强说明富集有效。
验证亲和力提升的最终手段是表面等离子共振(SPR)或生物膜干涉技术(BLI)。将纯化的scFv或全抗体做浓度梯度检测,测定解离常数Kd。亲和力成熟前后的Kd对比是评判成熟效果的金标准。一般认为Kd提升一个数量级(比如从100nM到10nM)算是成功的亲和力成熟。如果经过两轮成熟仍未看到显著提升,可能是当前序列已经接近该框架的结构极限,需要考虑换用不同的抗体框架或者用更激进的突变策略。
 X