CUT&Tag的真实门槛:从"一万个细胞起"到"可信图谱"之间那些没人写在protocol里的失败
CUT&Tag 被称为"10 万个细胞的 ChIP-seq",但把 pA-Tn5 加到抗体后面只是这门技术最容易的一步。真正决定成败的是核膜能不能在不破坏表位的前提下被打透、Tn5 的剪切密度是不是让相邻片段挤在一起、还有你最信赖的那个抗体在原生条件下到底认不认得它的靶点。这篇文章不谈原理,只谈那些在论文补充材料里被"按protocol操作"一笔带过、却能让你白烧三个月细胞的细节。
01、核膜透化:整个实验的单点故障
CUT&Tag 的起点是"活细胞或分离的细胞核",不是交联的组织。这个转变听起来只是省了一步交联,实际后果是把 ChIP-seq 里最宽容的一个环节换成了最不容忍的一个环节。
交联的作用之一是把蛋白在原位固定住,于是后续所有粗暴操作——超声、反复洗涤、长时间离心——对"蛋白还在不在原位"这件事影响很小。原生条件下没有这层保险。抗体孵育结束后你做的每一个机械动作,都是在直接冲击蛋白与 DNA 的结合。洗涤一次太强,结合就松了;离心一次太快,核内结构就散架。这就是为什么 CUT&Tag 的优化工作有 70% 集中在"如何在不破坏复合物的前提下把细胞洗干净"。
去垢剂的窗口比 ChIP 窄得多
透化用 Digitonin。它的机制是结合胆固醇形成孔洞,浓度过低孔太小,抗体进不去核;浓度过高,核膜上其他脂蛋白被一并抽走,染色质三维结构解体,核骨架依赖的结合位点丢失。这个窗口在细胞类型之间差异巨大:
| 细胞类型 | 建议 Digitonin 起始浓度 | 特点 |
|---|---|---|
| 悬浮哺乳动物细胞(K562、THP-1) | 0.05% – 0.1% | 膜通透性好,窗口宽,最容易入门 |
| 贴壁细胞(HCT116、HeLa) | 0.1% – 0.25% | 需要离心-去上清的反复操作,剪切风险更高 |
| 原代细胞 / 外周血单核细胞 | 0.05% – 0.15% | 细胞脆弱,过度离心即破裂 |
| 神经元与脑组织 | 需要优化,部分需物理破膜 | 细胞数量少,是主要难点 |
| 植物细胞 | 需先去除细胞壁 | 细胞壁是物理屏障,酶解损伤表位 |
关键判断方法不是"浓度多少"而是"抗体能不能进来"。最直接的做法是做一次抗体孵育后的洗涤流失实验:透化后加入标记过的抗体,洗涤后收集洗液测信号,如果洗液里有大量抗体,说明透化不足。或者更简便——延长透化时间与提高浓度的结果做对比实验,FRiP 通常呈现单峰关系:不足时加量会提升,足够后再加量会让 FRiP 下降(因为结构被破坏,背景上升)。找到那个峰值。
离心是隐形杀手
原生条件的细胞核经不起反复的 300–500 g 离心。有实验室改用 100 g 短时离心配合更多次洗涤,信号反而更干净。判断标准很简单:如果你的 CUT&Tag 数据 FRiP 上不去但 Input 信号异常高(Input 的 FRiP 应该极低,通常 0.5% 以下),这说明背景弥散、染色质完整性已受损,问题多半出在洗涤与离心强度,而不是抗体。
为什么 Input 在 CUT&Tag 里更关键
ChIP-seq 的 Input 常常被省略,因为 ChIP 的特异性足够高,Input 主要是用于 CNV 校正。但在 CUT&Tag 里,Input 变成了诊断工具而非可选项。健康的 CUT&Tag Input 应该有极高的信噪比:绝大多数区域接近零,只有开放染色质处有微弱信号。如果你的 Input 曲线和 H3K4me3 曲线形状相似,说明转座酶在"无目标"的情况下也在乱切,也就是反应体系或抗体桥接出了问题。这种情况下,靶标抗体的数据基本不可信,哪怕 FRiP 看起来不错。
02、pA-Tn5 怎么装配,决定了你能不能做 CUT&Tag
转座酶蛋白不是从大肠杆菌表达系统里直接表达的——原因不复杂:Tn5 转座酶结合到 DNA 底物上之后就很难再解离,柱子纯化会全军覆没。替代方案是用体外偶联法把酶和接头接在一起,组装好的复合物称为 转座酶体(transposome)。这个"体外装配"过程是整个 CUT&Tag 技术链条中最脆弱的一环,也是商业化试剂盒最核心的技术壁垒。
Mozingo / Gibson 组装的两步法
主流做法是化学偶联:用特定试剂把 protein A 融合的 Tn5(pA-Tn5)与 预装载接头的转座酶体(adapter-loaded Tn5)在溶液中交联成整体。关键的化学细节是——接头与酶的连接数是随机的,一个酶分子上可能接 0 个、1 个或 2 个接头。
这个随机性是有后果的。接了两个接头的酶分子可以双向插入并在两端都留下接头序列;接了一个的分子只能单向插入,另一端靠 PCR 阶段补上;接了零个的分子是纯粹的"剪切机器",它会切断 DNA 但不留任何接头,产生无法被测序检出的信号。三种摩尔比例必须被精确调控。
pA-Tn5 转座酶体装配 → 剪切与接头插入STEP 1 · 体外偶联组装转座酶体pATn5Protein A 端+Tn5带接头—→转座酶体双接头 / 单接头 / 无接头比例决定剪切效率STEP 2 · Mg²⁺ 激活的原位剪切与插入抗体▲ Tn5 就位未被保护的 DNA 被切除并替换为接头剪切位点距离靶蛋白约数十bp失败模式转座酶体未洗涤干净 → 游离酶随机插入 → Input 弥散升高,FRiP 骤降;Protein A 与二抗结合不足 → 剪切位点远离峰中心。
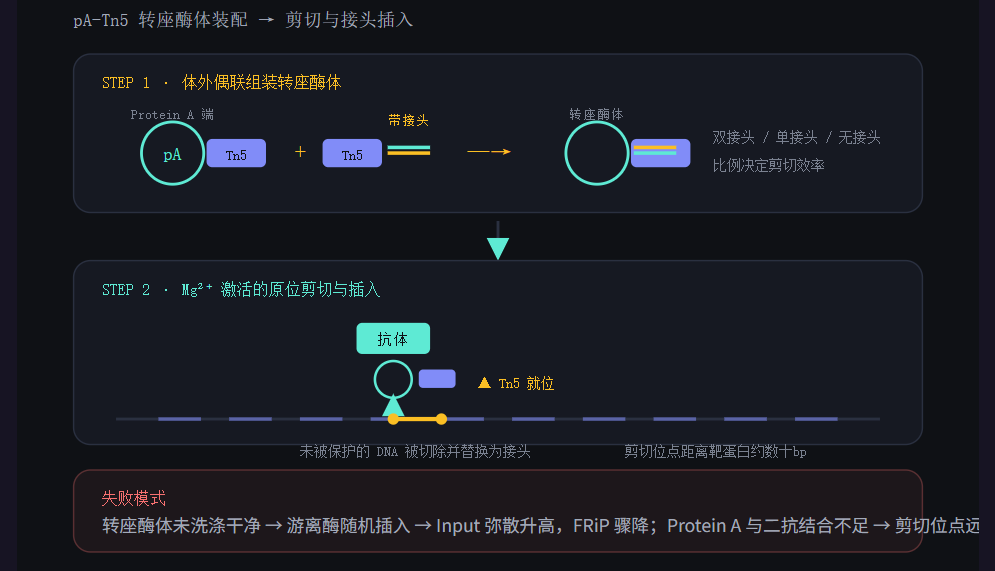
图1:转座酶体装配与 CUT&Tag 反应原理。Protein A 结构域负责识别抗体的 Fc 区域,把 Tn5 转座酶精确锚定在靶蛋白结合位点附近;加入 Mg²⁺ 后酶被激活,切割邻近 DNA 并同步插入测序接头。每一步的失败都指向不同的可观测后果,这构成了后文质控判据的依据。
为什么"洗涤掉未结合的转座酶体"这一步不能省
最常见的灾难性失败是:孵育了 pA-Tn5 之后洗涤不充分,残留的游离转座酶体在激活后随机插入基因组任意位置。结果是 Input 曲线几乎与靶标曲线相似,FRiP 看似很高但信息量为零。这类失败在测序前完全看不出来(没有任何可见的失败信号),只有测完序才恍然大悟。
严格洗涤的做法是:至少 3 次洗涤,每次 10 分钟,低温、静置、避免任何涡旋或快速离心,最后一次洗涤延长到 30 分钟并彻底换液。有实验室倾向于延长最后一步到 1 小时,牺牲约 1 小时时间换取干净背景,这在低丰度转录因子的实验中几乎总是划算的。
Tn5 的"剪切距离偏好"影响定位精度
Tn5 在插入时会偏离转座位点一个特征性的距离——它的转座酶体会做一次"跳跃",插入位置与最初的酶结合位点之间存在偏移。对 pA-Tn5 来说,这个偏移大约是几十 bp。这意味着 CUT&Tag 峰的中心相对真实结合位点有系统性的偏移。虽然偏移量在实验间大致稳定,但对于要求精确到几十 bp 的场景(比如足迹分析、motif 精确定位),需要把这个偏移作为校准项考虑进去。这也是为什么组 CUT&Tag 与对应 ChIP-seq 数据做峰中心比较,往往能观察到一个稳定的位移量——这个位移量是可以被测出来并用于校正的。
03、剪切密度:一个被严重低估的参数
CUT&Tag 的原理决定了它有一个内在矛盾:转座酶只在"没有被蛋白保护"的 DNA 位置插入。但如果剪切太密,相邻的酶分子在 DNA 上排得太近,导致释放出来的片段互相交叠、大片段无法回收;如果剪切太疏,信号不足、灵敏度下降。
控制这个密度的主要旋钮有三个:
(1)Tn5 转座酶体的浓度。最直接的控制手段,但要与细胞数匹配——细胞数少时酶相对过量,剪切必然失控。这也是为什么 100 个细胞做 CUT&Tag 看起来很美、而同样细胞数加 100 万个细胞时就需要重新优化酶的比例:酶与细胞数的比值才是真正的变量。
(2)Mg²⁺ 浓度与激活时间。常用 10 mM MgCl₂。降低浓度或缩短激活时间会减少剪切数量,但也降低信号强度。这是一个可以精细调节的连续变量,代价是需要多次优化实验来找到最优点。
(3)抗体的交联与否。部分改良协议使用轻度甲醛交联(例如 0.1%–0.15% 短时)来固定抗体,随后洗涤去除交联剂,再加入 pA-Tn5。这能显著提高剪切效率并减少非特异背景,代价是重新引入了交联带来的表位掩蔽风险与"这算不算 CUT&Tag"的定义争议。使用这类改良方案时必须在论文中明确报告,因为它影响数据的可比性。
怎么判断剪切密度是太高还是太低
有一个非常实用的判据:看 Input 的 FRiP 与片段分布。
- Input FRiP 明显偏高(> 3%)→ 剪切过密或洗涤不彻底。
- 片段分布主峰过度集中在 60–100 bp → 剪切过密,"互相打脸"导致片段过短,文库复杂度低。
- 片段分布出现明显的高分子量拖尾(> 1 kb)→ 剪切不足,酶没切够,信号被稀释在无效片段里。
理想的 CUT&Tag 文库片段分布呈现双峰:一个小的主峰在 100–200 bp(这是被保护区域的 Tn5 插入位点切出来的片段),加上一个较小的高峰在 400–600 bp(这是从两个相邻的结合位点切出的片段,反映了结合位点之间的距离分布)。如果你只看到单峰且位置很靠后,说明剪切效率不足;如果单峰位置很靠前(60 bp 以下),说明剪切过度。
片段分布形态 → 剪切密度诊断理想 · 双峰60150400剪切过密 · 单一短峰片段交叠,复杂度下降剪切不足 · 拖尾>1 kb 拖尾由分布反推参数剪切过密 → 降低酶浓度 / 降低 Mg²⁺ / 缩短激活时间 / 增加细胞数摊薄剪切不足 → 提高酶浓度 / 提高 Mg²⁺ / 延长激活 / 检查二抗桥接是否充分伴随信号 → Input FRiP >3% 判为背景弥散,必须重做,不可解读文库复杂度 → 剪切过密时 unique reads / total reads 显著下降,测序深度被浪费
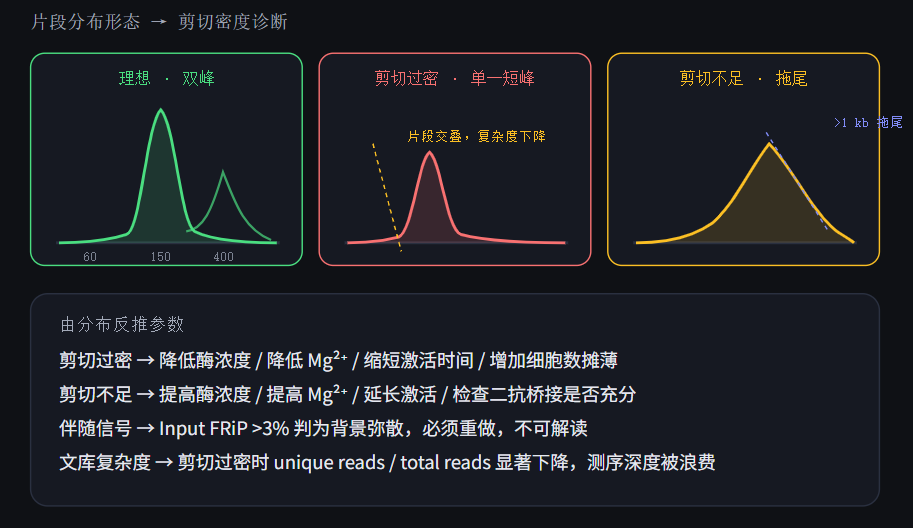
图2:片段大小分布的三种典型形态与对应的参数调整方向。主峰(100–200 bp)来自保护区的边界切割,肩峰(400–600 bp)来自相邻结合位点间的距离分布。这个分布形态是判断剪切密度最直接的实验室内指标,比 FRiP 更早给出诊断信息。
04、片段大小分布:为什么它必须是双峰
上面的图已经说明了这一点,这里补一个更深的视角:CUT&Tag 的片段分布携带生物学信息,而不只是质控参数。
考虑一个 ChIP-seq 无法回答的问题:某个转录因子是"在一个位点反复结合"还是"在多个相邻位点轮流结合"?在 ChIP-seq 里这两种情况会产生几乎相同的信号——都是一个宽峰。在 CUT&Tag 里它们有区别:前者只有主峰(一个保护点,周围全是随机插入),后者有明显的肩峰(两个保护点之间的距离集中)。
更进一步,对于组蛋白修饰,片段分布可以直接反映修饰的域长度。H3K4me3 通常在启动子上形成较长的连续区域,双峰间距约 600–800 bp;H3K27ac 在增强子上更集中;H3K36me3 分布在基因体,片段分布更宽。这种"通过片段空间结构反推修饰域"的分析已经开始出现在方法学论文中,是 CUT&Tag 相对 ChIP-seq 的一个信息增量。
需要注意的边界
这个优势的前提是剪切密度足够低。如果剪切过密,片段间交叠会把所有分布信息抹平——你只会看到一个 60 bp 的窄峰。所以"得到有生物学意义的双峰分布"和"得到高 FRiP"这两个优化目标之间存在张力,需要在实验设计时就明确你更想要哪一个。对于常规的"我需要一份可靠的 H3K27ac 图谱",优先保证 FRiP;对于"我在研究结合位点的空间排布",优先优化剪切密度以保留分布信息。
05、原生条件:抗体迁移的隐性成本
这是 CUT&Tag 目前最大的实验设计困境,也是大多数"从 ChIP 转到 CUT&Tag 失败"案例的根因。
抗体供应商为 ChIP 优化的抗体,几乎都在交联条件下验证过。交联会在蛋白表面引入亚甲基桥,这可能遮蔽也可能暴露表位,具体取决于抗体结合位点与交联位点的空间关系。于是出现一个反直觉的现象:一个在 X-ChIP 里表现完美的抗体,在 CUT&Tag 的原生条件下可能完全没有信号。
必须做的验证,且要验证特异性而不只是灵敏度
验证实验的设计要点是:不要只测"有没有信号",要测"信号在不在正确的位置"。具体做法是用已知阳性位点做判断——
(1)抗 H3K4me3:看信号是否出现在已知活跃启动子的位置,而不是随便哪里都高。
(2)抗 CTCF:看信号是否出现在已知的 CTCF motif 富集区域,且与 motif 位置有约 200 bp 的偏移。
(3)抗转录因子:用 motif 富集分析(富集出的 motif 是否是该 TF 预期的 DNA 结合域),这是最强的特异性证据。
只要一个抗体通过"有信号 + 位置正确 + motif 合理"三项检查,就可以放心用于 CUT&Tag。如果只通过第一项,你可能只是得到了一份噪声图谱——而这一点在没有正对照的情况下极难察觉。
原生条件友好型
组蛋白修饰抗体(H3K4me3、H3K27ac、H3K27me3、H3K9me3 等)大多表现良好,因为修饰表位在核小体表面暴露充分,暴露程度不依赖交联网络结构。CUT&Tag 的组蛋白修饰应用已经从"可以"变成了"默认首选"。
需要额外验证型
CTCF、NPAT 这类高丰度结构相关蛋白,原始 CUT&Tag 论文验证过的就属于这一类。中丰度转录因子需要个体化验证抗体。
风险较高型
低丰度转录因子、弱结合或间接结合的因子、共因子类蛋白(这些可能依赖交联才稳定在染色质上)。CUT&Tag 原始论文明确指出,这一类仍需要交联,此时应当直接用 ChIP 而不是硬上 CUT&Tag。
06、组蛋白修饰很友好,转录因子很麻烦
把上一节的分类再展开一层,因为它直接决定实验的可行性判断。
组蛋白修饰:CUT&Tag 的主场
组蛋白修饰具备三个对 CUT&Tag 极其友好的性质:丰度高(一个修饰标记在基因组上的拷贝数以万计,不存在抗体捕获效率问题);表位暴露(修饰基团伸向核小体表面,直接与溶剂接触);分布连续(修饰域内每个核小体都被标记,不需要精确的位点定位)。这三条合起来意味着,即使剪切密度不高、样本量不大,也能在 1000–5000 个细胞范围内获得稳定可靠的图谱。这也是目前 CUT&Tag 在植物、发育生物学、罕见细胞类型中应用最广的方向。
转录因子:CUT&Tag 的战场
转录因子的难度在于稀少。一个典型的人类转录因子在每百万细胞里可能只有几千个拷贝,但 CUT&Tag 的剪切是由抗体锚定的——如果抗体没能抓到足够比例的蛋白,剪切就会稀疏到无法形成可测的信号。
这里有一个重要的技术选项:敲入标签。用 CRISPR 把 FLAG、HA、V5 或 biotin 标签敲入转录因子的基因组位点,然后用高亲和力的标签抗体做 CUT&Tag。这解决了抗体的特异性问题,但引入了一个新问题:标签的存在本身可能改变蛋白功能。N 端标签干扰 DNA 结合、C 端标签干扰共因子招募的例子都不少见。稳妥做法是至少构建两个不同位置的敲入株系,并验证它们在 CUT&Tag 之外的功能(定位、表达水平)没有改变。
生物素化的 FLAG 是较新的选项,配合 B-CUT&Tag 可以在剪切后用链霉亲和素磁珠纯化标记片段,极大降低背景,对丰度极低的转录因子尤其有效。
07、二抗桥接不是可选的
这个简单机制导致的失败极其常见,值得单列一节。
Protein A 结合抗体的 Fc 区域。这里有一个关键的物种限制:Protein A 对兔 IgG 的结合最强,对小鼠 IgG 的结合中等偏弱,对大鼠 IgG 更弱,对羊 IgG 和人 IgG 的结合特性差异很大。而 pG(protein G 融合)是这个问题的补充方案。
如果你用的是小鼠单抗:直接用 pA-Tn5 可能结合不足,导致剪切效率低。解决办法是加入抗小鼠 IgG 的二抗(例如山羊抗小鼠 IgG),先让二抗结合一抗,再加 pA-Tn5。这样形成了"靶蛋白 — 一抗 — 二抗 — pA-Tn5"的三层结构。
但这引入了新的动力学问题:二抗是双价或多价的,它可能交联多个一抗分子,从而把多个靶蛋白位点连在一起。这样 Tn5 会被锚定到多个位点,剪切发生在所有这些位点周围,峰的分辨率因此下降、宽度变宽。如果你做的是需要精确位点的转录因子,这可能是不可接受的。折中方案是使用 Fab 片段形式的二抗(单价),或使用单克隆抗体识别 IgG 特定亚类(如抗小鼠 IgG1 的单抗,如果你的抗体是 IgG1 亚型)。
信号偏弱时的排查顺序
按顺序检查,每一步的成本递增:① 抗体宿主与 pA/pG 的兼容性 → ② 加二抗桥接后是否提升 → ③ 提高酶浓度与激活时间 → ④ 检查细胞核透化程度(用洗液抗体流失实验)→ ⑤ 验证抗体在原生条件下确实能识别 → ⑥ 增加细胞数。跳过前面几步直接加细胞数是最常见的浪费,因为前几步的问题不会随细胞数改变。
08、CUT&RUN 与 CUT&Tag:不是替代关系
CUT&RUN 与 CUT&Tag 常被并列讨论,但它们的关系不是"新的替代旧的"。
| 维度 | CUT&RUN | CUT&Tag |
|---|---|---|
| 剪切机制 | Protein A–MNase 融合蛋白,核酸酶切割 | Protein A–Tn5 转座酶,切割并插入接头 |
| 文库构建 | 需要单独的末端修复与接头连接步骤 | 剪切与插入一步完成 |
| 典型细胞数 | 500,000 左右(文献范围宽) | 5,000 – 50,000,修饰可达 100 |
| 测序深度 | 约 800 万 reads | 约 300 万 reads |
| 单细胞适配 | 困难(需从纯化染色质起步) | 较容易(反应全在细胞内完成) |
| 剪切密度控制 | 依赖 MNase 浓度与反应时间,敏感 | 依赖酶浓度与 Mg²⁺,更可控 |
| 片段特征 | 以 MNase 核小体尺度为主 | 有明确的双峰分布信息 |
选择逻辑很直接:需要保留片段空间信息、需要单细胞、需要最低细胞量 → CUT&Tag;需要核小体尺度的精确切分、已有成熟 CUT&RUN 平台 → 继续用 CUT&RUN。两者的数据不能直接合并分析,因为它们的片段定义不同。
与 ChIP-seq 的关系同样值得说清:CUT&Tag 与 ChIP-seq 的数据相关性很高(在同一抗体、同一细胞系下,峰的重叠率通常可达 70%–85%),因此 CUT&Tag 数据通常不能与 ENCODE 的 ChIP-seq 数据直接合并——反应原理不同导致片段定义不同,虽然峰位置相近,但信号含义不可比。做跨方法比较时应使用 peak-based 的关联分析(如用各自的峰定义区域算 Jaccard 指数),而不是直接读 track 相减。
09、scCUT&Tag 的分箱问题
单细胞 CUT&Tag 的原理很优雅:整个反应都在细胞内完成(从抗体孵育到剪切),然后把细胞分散到纳孔板里加上细胞特异 barcode 做扩增。听起来只是工程化封装,但它踩到了一些统计上的深坑。
稀疏数据的峰识别问题
单细胞里每个位点平均只有零点几条到几十条 reads。在这个深度下,"峰"这个概念本身变得模糊——你无法区分"这个位点有 3 条 reads"是真实的弱结合还是噪声。因此 scCUT&Tag 的分析主流做法是不做单细胞层面的峰识别,而是:
(1)用 bulk CUT&Tag 或 ChIP-seq 定义的峰集合作为参考区间,把单细胞 reads 计数汇总到这些区间上;
(2)对每个区间计算跨越细胞的检出率(多少比例的细胞中该区间有 ≥N 条 reads);
(3)用二项混合模型把这个检出率分解为"细胞异质性成分"与"dropout/技术成分",只有异质性成分显著可检出的区间才被视为真正的异质位点。
这个流程里的关键参数是 N(检出阈值)。N=1 对高丰度区间过于宽松(技术噪声贡献大),N=3 或 5 更稳健但会丢掉弱结合位点。做敏感性分析(换 N 重跑,看结论是否稳定)是这类分析的标配。
单细胞检出率的分解:异质性 vs 技术 dropout检出率 vs 区间信号强度025%50%75%检出率观测检出率技术 dropout 基线异质性检出阈值 N 的影响N=1 → 高丰度区间假异质性严重N=3 → 平衡点,推荐起点N=5 → 稳健但丢失弱位点必做:敏感性分析更换 N 后,异质位点数的变化幅度是否 < 30%?若变化剧烈 → 结论不稳健需回到测序深度与阈值联合优化报告时必须写明 N 与细胞数
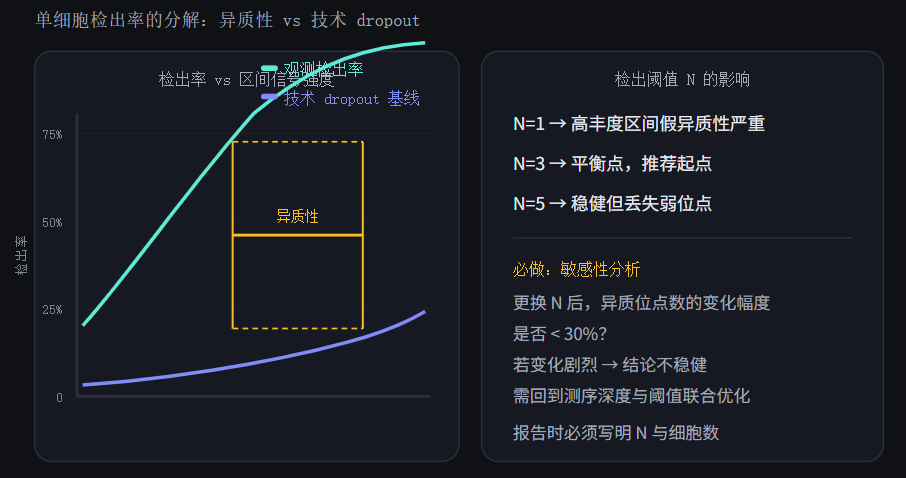
图3:单细胞 CUT&Tag 的检出率分解。观测检出率由技术性 dropout 基线与真实异质性成分叠加构成,只有显著高于基线的部分才是生物学信号。检出阈值 N 的选择会直接决定异质位点的数量,因此敏感性分析是这类分析的必需环节,而非可选项。
10、B-CUT&Tag 与 biotin 化改造
常规 CUT&Tag 的一个结构性限制是:剪切完成后,全部被标记的 DNA 片段与大量未标记的完整染色质混在一起。文库构建时,未标记的完整染色质片段也会被随机打断并进入文库——它们贡献了绝大多数 reads,是背景的来源。文库复杂度被大量无效片段占据,实际用于目标信号的深度远低于总测序量。
B-CUT&Tag 的思路非常直接:让转座酶与接头都带上生物素修饰,剪切完成后用链霉亲和素磁珠只捞出带生物素的标记片段,其余染色质在磁珠上被洗掉。文库只包含被标记的 DNA,复杂度大幅提升,信噪比改善。
这个改造在两个场景下价值最高:转录因子丰度低(标记片段在总 DNA 中占比极小时,纯化的收益最明显)和样本量极少(在低细胞数下,省下的深度等于省下的细胞)。
需要注意的技术细节:链霉亲和素对双链 DNA 末端的亲和力低于对蛋白结合形式,因此磁珠纯化步骤的条件(洗涤次数、盐浓度)需要优化,过度洗涤会丢失片段;同时磁珠操作本身增加了一轮液液/固液转移,在低细胞量时会带来可观的损失。所以建议先用常规 CUT&Tag 验证抗体可用性,确认信号存在后再上 B-CUT&Tag 争取灵敏度。
11、质控:一套不依赖抗体的判据
最后把所有质控点汇总成一张可以在实验过程中实时执行的检查单。关键原则是:每一项都能在花掉测序费用之前给出判断。
| 检查节点 | 指标 | 健康范围 | 异常指向 |
|---|---|---|---|
| 透化后 | 洗液中抗体信号 | 接近零 | 透化不足,抗体未进核 |
| 酶体孵育后 | 洗涤次数与时长 | ≥3 次,最后一次 ≥30 min | 洗涤不足将造成弥散背景 |
| 建库后 | 片段分布形态 | 双峰,主峰 100–200 bp | 见 §03 的密度诊断 |
| 建库后 | unique reads 占比 | > 60% | 偏低提示剪切过密或扩增过度 |
| 测序后 | Input FRiP | < 1% | 偏高即背景弥散,数据不可用 |
| 测序后 | 靶标 FRiP | 修饰 > 20%;TF 视丰度 | 偏低时按 §07 排查顺序逐项检查 |
| 测序后 | motif 富集合理性 | 检出预期 TF 的结合域 | motif 缺失即提示抗体非特异 |
| 测序后 | 与同条件 ChIP-seq 的峰重叠 | > 60% | 偏低需排查特异性或剪切设置 |
| 单细胞 | 每细胞 reads / FRiP 分布 | 双峰分布,离群细胞剔除 | 失败细胞被平均掩盖,需逐细胞检查 |
表格里最后两行是实践中最有价值的、也是最少被执行的。前者用一个客观参照物(你已经做过的同条件 ChIP-seq)来锚定 CUT&Tag 的可信度,成本只是一行代码;后者提醒你单细胞数据的失败模式是隐性的,必须逐细胞检查而不是看平均值——一个实验室里有 30% 的细胞"废掉"但整体 FRiP 看起来正常,是完全可能发生的事。
关于 CUT&Tag 的定位
CUT&Tag 不是一个"更好的 ChIP-seq",它是一个针对特定约束条件的最优解:当你的细胞数量受限、当你需要组蛋白修饰的高信噪比图谱、当你需要单细胞分辨率时,它是明显更优甚至唯一可行的选择。反过来,当你面对的是丰度极低、弱结合、依赖间接互作的靶蛋白时,强力交联加超声的 ChIP-seq 仍然是更可靠的工具。承认这一点比试图把 CUT&Tag 强行推广到所有场景更有价值。
最新动态
-
10.16
当Cq值不能直接比:荧光定量PCR中被误用的六个假设
-
10.16
噬菌体展示的工程学真相:库容、遗传漂移与淘洗压力之间的三角关系
-
10.16
CUT&Tag的真实门槛:从"一万个细胞起"到"可信图谱"之间那些没人写在protocol里的失败
-
10.16
ChIP-seq实验设计的六道关口:从交联参数到生物学结论之间的断层带
-
10.15
酵母双杂交筛库的质量控制:从诱饵可用性到阳性克隆归一化的实战判据
-
10.15
酵母质粒小提的性能边界:破壁效率、纯度诊断与下游用途匹配
-
10.15
凝胶电泳迁移实验的判据体系:从泳道表达到单变量排查
-
10.15
细胞凋亡检测的证据链设计: 象限、时间窗与假阳性来源
-
10.14
LCA实验技术,连接酶介导的核酸扩增体系与生命周期评估方法学的双轨实践
-
10.14
荧光定量检测技术 | 定量体系的工程实现、多重探针设计与跨平台归一化
 X