噬菌体展示技术:从文库工程到药物发现
一、噬菌体展示文库构建的高级策略
M13噬菌体展示系统的基因工程架构中,衣壳蛋白的展示位点选择直接决定了文库的功能边界与筛选行为。pIII蛋白定位于丝状噬菌体末端,其N端结构域(NTD)介导对大肠杆菌F菌毛的识别与感染过程,每颗粒仅携带3至5个拷贝,天然适合单价展示场景,能够有效规避多价结合导致的表观亲和力放大效应。pVIII作为主要衣壳蛋白,每颗粒约2700个拷贝,适用于多价展示,但在亲和力筛选中容易产生亲和力高估的问题,克隆的结合信号被多拷贝阵列放大,使得真正高亲和力的克隆被淹没在多价结合的噪声中。pVII和pIX位于噬菌体极性尾部,近年来被发现可作为大分子融合展示的替代位点,尤其是在双组分展示系统的设计中展现出独特价值,使得同一噬菌体颗粒能够同时展示两种不同功能域。
在M13噬菌体展示文库构建中,单价展示与多价展示的选择本质上是一个热力学与动力学平衡的问题。当采用pIII N端融合策略时,辅助噬菌体系统提供野生型pIII蛋白与融合型pIII竞争组装,通过调控感染时辅助噬菌体的MOI(感染复数)可以精确控制每颗粒展示的外源蛋白数量。M13K07是最经典的辅助噬菌体,但其pIII蛋白与融合蛋白竞争组装效率不均一,导致展示拷贝数波动较大。VCSM13在M13K07基础上优化了pIII表达水平,展示均一性有所改善。超噬菌体(hyperphage)系统则采用pIII基因缺失的辅助噬菌体,迫使所有pIII均来自融合表达载体,实现完全多价展示,这一特性在低亲和力克隆的初步富集阶段极为有用,但在精细亲和力筛选时需要切换回常规辅助噬菌体以恢复单价展示条件。
scFv文库构建的基因设计对展示效率具有深远影响。VH-(G4S)3-VL与VL-(G4S)3-VH两种构型的选择不仅关乎空间折叠,更影响VH与VL的配对稳定性。研究表明,VH-linker-VL构型在多数框架组合中展示效率更高,原因在于VH位于N端时其疏水界面更容易与共翻译折叠的VL形成正确配对。连接肽的长度同样关键:15残基的(G4S)3连接肽是最常用的设计,但在某些框架组合中,20残基甚至25残基的延长连接肽能够改善结构域间柔性,降低聚集体形成。噬菌体展示文库类型的选择依据靶标特性与项目阶段而定:天然抗体文库(naive library)源自健康供体外周血B细胞,多样性覆盖广但亲和力通常处于微摩尔级别;免疫文库(immune library)从免疫动物或康复患者B细胞构建,亲和力高但多样性受限且存在伦理来源问题;合成文库(synthetic library)通过人工设计V(D)J基因组合与CDR区随机化,在容量和可设计性上具有最大优势,目前已成为主流路线。
文库多样性的质量控制是文库可用性的基石。有效文库容量应达到10^8至10^11范围,插入率需高于90%,开放阅读框(ORF)完整性通过Sanger测序或NGS验证需达到95%以上。TRIM技术(三核苷酸定向突变)在合成文库CDR区精确突变中解决了简并密码子带来的氨基酸偏差问题,传统NNK或NNS简并密码子在编码20种氨基酸时存在32种密码子组合,导致氨基酸分布不均一(如色氨酸只有1个密码子而丝氨酸有6个),TRIM通过预合成三核苷酸磷酸亚胺单体,直接控制每个位置的密码子组成,实现氨基酸的等摩尔分布。在大容量合成抗体文库设计中,种系基因(germline gene)的选择策略至关重要:优先选择在人类外周血中高频率使用的VH3家族成员(如VH3-23、VH3-30),因其具有优越的稳定性和展示效率;轻链方面,VK1(如VK1 O12)和VLambda1家族成员因框架区疏水性低、折叠效率高而被广泛采用。文库保存与扩增过程中,遗传漂移(genetic drift)是多样性流失的主要风险因素,控制策略包括:大规模电转化后立即分装冻存、避免连续传代扩增、每次扩增从原始库出发、使用重组缺陷型宿主菌(如TG1的recA+表型需切换至TG1ΔrecA或SS320)以抑制同源重组事件。此外,电转化效率是文库容量达成的物理瓶颈,高浓度质粒DNA(10-50微克每毫升电穿孔缓冲液)配合0.1厘米电转杯、1.8千伏电场强度、200欧姆电阻和25微法电容的标准参数,可在大肠杆菌TG1中实现10^9至10^10转化子每微克DNA的效率。通过多次独立电转化合并策略,文库总容量可累积至10^11量级,满足极低丰度克隆的覆盖需求。文库均一性还需通过NGS深度测序评估CDR区的密码子分布偏离度,Shannon熵值应不低于15 bits以确保信息熵充分覆盖。
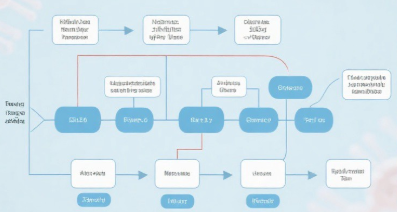
图1. 噬菌体展示文库构建与生物淘洗筛选全流程示意:从scFv基因克隆、电转化建库到多轮亲和筛选的完整工作流
二、生物淘洗筛选策略的深度优化
噬菌体展示生物淘洗筛选是连接文库多样性与功能克隆的核心桥梁,其策略设计直接决定了筛选结果的信噪比与克隆质量。固相淘洗将靶分子包被在免疫管或微量孔板表面,操作简便且重现性较好,但存在构象表位丢失的风险,部分靶蛋白在固相吸附过程中发生构象变化,使得原本存在于天然构象中的表位不可及。液相淘洗通过生物素-链霉亲和素系统在溶液相中完成结合过程,再通过磁珠捕获结合态噬菌体,最大程度保留了靶分子的天然构象,尤其在筛选构象敏感型表位抗体时优势显著。细胞淘洗直接以完整活细胞为靶标,无需纯化可溶性靶蛋白,能够筛选到识别天然膜蛋白构象表位的克隆,但背景结合噪声较高,需要更精细的阴性筛选策略配合。
靶分子固定化方法的选择影响筛选的灵敏度和特异性。直接包被法操作最简便,但靶蛋白随机吸附可能遮蔽关键表位。生物素-链霉亲和素捕获系统通过生物素化标签(如AviTag或体内生物素化)实现定向固定,保证靶蛋白功能域朝向溶液相,同时通过链霉亲和素磁珠的磁分离特性简化了洗涤操作。标签蛋白捕获(如His-tag-Ni-NTA或Fc-anti-IgG)提供了方向性固定的优势,且可在变性条件下洗脱。脂质体展示将膜蛋白重组到脂质体中,为跨膜受体的噬菌体展示筛选提供了更接近生理环境的展示平台。封闭策略方面,BSA是最通用的封闭剂但对某些靶标封闭不完全;脱脂奶粉成本低但成分复杂,可能导致靶蛋白变性;酪蛋白的封闭效果均匀且背景低,适合高灵敏度筛选;合成封闭剂(如Blocker Casein或专用的SuperBlock)提供批次间一致性,适用于标准化筛选流程。
洗涤强度的递进设计是多轮筛选中提高信噪比的关键手段。第一轮筛选采用低强度洗涤(0.1% Tween-20,洗涤3-5次,每次5分钟),目的是最大程度回收低亲和力克隆以保持多样性。从第二轮起逐步提高Tween-20浓度(0.3%至0.5%至1.0%)并增加洗涤次数至10-15次、延长洗涤时间至10-15分钟,以逐步富集高亲和力克隆。洗脱条件的精细优化同样至关重要:酸性洗脱(甘氨酸-HCl pH 2.2,孵育10分钟)是最常用的方法,通过质子化破坏氢键和盐桥实现解离,但可能损伤某些敏感型噬菌体;碱性洗脱(三乙胺pH 11.0)适用于对酸敏感的靶标体系;竞争性洗脱加入过量可溶性靶分子竞争结合位点,特异性洗脱结合态噬菌体,背景噪声最低;蛋白酶洗脱(如trypsin)直接消化融合蛋白释放噬菌体,洗脱效率高但可能降解展示蛋白。在噬菌体展示靶点验证中,多轮筛选的富集动力学通过output/input ratio(产出/投入比)的变化趋势来判读:正常情况下,每轮筛选的回收率应呈对数级上升(10^-5到10^-3到10^-1),若回收率不升反降或停滞,通常提示文库中缺乏足够高亲和力的克隆或筛选条件过于严苛。
关键参数:第三轮筛选的output/input ratio达到10^-2以上,且噬菌体ELISA阳性率超过60%时,通常表明富集效果良好,可进入单克隆鉴定阶段。
阴性筛选(negative panning)在降低非特异性结合中扮演着不可或缺的角色。在细胞淘洗中,使用靶抗原阴性表达的对照细胞系进行预吸附(depletion panning),去除识别细胞表面共有抗原的克隆;在固相淘洗中,使用空载体蛋白包被的孔板进行预吸附以去除塑料结合型和载体蛋白结合型噬菌体。交叉吸附策略尤其适用于多亚基靶标的筛选,通过连续阴性筛选去除识别共同亚基的非特异性克隆。面对复杂靶标,完整细胞筛选能够保留膜蛋白的天然构象和翻译后修饰;组织切片筛选提供了体内微环境的组织特异性筛选能力;体内筛选(in vivo panning)将噬菌体文库直接注射到动物体内,通过回收靶器官中的噬菌体来筛选组织归巢肽,这一策略在噬菌体展示靶向多肽筛选中具有不可替代的价值。亚类化筛选(subclassing)策略通过逐步降低靶分子浓度(如从100nM到10nM到1nM)来驱动热力学竞争,使仅有最高亲和力克隆能够维持结合,这种策略本质上是利用了结合反应的浓度依赖性来筛选解离速率慢的克隆。洗脱后分析阶段,噬菌体ELISA用于快速评估单克隆的结合特异性,Sanger测序揭示克隆的序列多样性(通过CDR序列聚类分析),必要时辅以NGS深度测序评估文库层面的克隆分布均匀度。
三、亲和力成熟与抗体优化的高级方法
噬菌体展示亲和力成熟是从微摩尔级先导抗体向纳摩尔甚至皮摩尔级候选药物跃迁的核心驱动力。CDR走步(CDR walking)策略通过逐一定向突变重链和轻链的互补决定区来实现亲和力的阶梯式提升,其优化顺序选择直接影响成熟效率。重链CDR3(HCDR3)通常首先被突变,因其位于抗原结合口袋中心,对亲和力贡献最大,且序列长度和组成多样性最高。随后依次突变HCDR1和HCDR2,最后转向轻链LCDR区。这种顺序设计的理论依据在于重链CDR的亲和力贡献通常大于轻链,且HCDR3的结构柔性使其最容易被优化。然而,在特定案例中,轻链CDR1的突变可能显著改善结合的特异性,尤其是当轻链直接参与抗原接触面形成时,需要根据晶体结构数据灵活调整突变顺序。
密码子优化策略决定了突变文库的氨基酸覆盖度和筛选效率。NNK简并密码子(N=A/C/G/T,K=G/T)覆盖32种密码子组合,编码全部20种氨基酸但存在终止密码子(1/32概率);NNS(S=C/G)与NNK在氨基酸覆盖上等效但密码子使用偏好不同。噬菌体展示抗体筛选中,NNK策略虽简单但氨基酸分布极不均匀(色氨酸1/32而丝氨酸6/32),导致文库中富含某些氨基酸而稀少另一些。TRIM引物技术通过预组装三核苷酸片段,在每个突变位置实现精确的氨基酸组成控制,可将色氨酸比例人为提高至5%以模拟天然抗体中HCDR3富含芳香族残基的特征,或降低半胱氨酸比例以防止非预期二硫键形成。轻链改配(light chain shuffling)策略保留了筛选获得的高亲和力重链,将其与新的轻链文库组合配对,通过噬菌体展示重新筛选,这一策略在改善特异性方面尤为有效,许多案例中,原重链与不同轻链的重新配对使亲和力提升5-10倍的同时显著降低了脱靶结合。重排策略(recombination strategy)将不同筛选轮次中获得的高频CDR片段重组到统一骨架上,通过DNA组装技术(如Gibson Assembly或Golden Gate)将最优CDR组合到单一框架中,实现亲和力与稳定性的协同优化。
off-rate筛选方法是噬菌体展示亲和力成熟中识别慢解离克隆的最直接策略。其核心原理在于:在结合反应达到平衡后,通过延长洗脱时间(从标准10分钟延长至24小时甚至72小时)或大幅降低靶分子浓度(模拟零浓度条件),使快解离克隆在等待期间自然脱落,仅保留慢解离克隆被回收。这种策略的本质是利用动力学差异而非热力学差异来区分克隆,两个克隆可能具有相似的平衡解离常数Kd,但解离速率koff可以相差数个数量级。表位特异性的保持是亲和力成熟中的隐性风险:高严苛筛选条件可能选择出结合表位偏移(epitope drift)的克隆,它们虽然亲和力更高但识别的表位已与原始先导克隆不同,可能导致功能丧失(如中和活性消失)。因此在每一轮亲和力成熟后,必须通过竞争ELISA或SPR表位分组(epitope binning)验证表位特异性是否保持。
图2. 亲和力成熟多轮筛选与序列优化路径:从CDR走步突变文库到off-rate筛选与表位验证的迭代优化循环
高通量结合鉴定采用梯度策略以平衡通量与精度:单点ELISA(single-point ELISA)用于第一轮高通量初筛,通常在96孔或384孔板中同时评估数百个克隆的结合信号,筛选标准为信号/背景比值大于5;表面等离子共振(SPR)初筛在Biacore 8K或Carterra LSA平台上并行测定数十至数百个克隆的kon和koff动力学参数,提供比ELISA更可靠的亲和力排序;等温滴定微量热法(ITC)在最后阶段提供无标记的金标准Kd测定,同时获取热力学参数(ΔH、ΔS、ΔG),揭示结合的驱动力来源。从scFv到全长抗体的格式转换需要综合考虑效应功能需求:IgG1框架适用于需要ADCC和CDC效应的肿瘤杀伤抗体;IgG4框架适用于受体阻断型抗体以减少Fc介导的效应功能;双特异性抗体格式(Knobs-into-Holes、CrossMab、DVD-Ig等)的选择取决于靶点组合特性和药代动力学需求。人源化过程中的CDR移植需将供体CDR移植到接受体人源框架上,并通过框架区回复突变(back-mutation)恢复关键接触残基,通常需要回复5-15个框架区残基以恢复结合亲和力,选择哪些残基回复需基于同源建模和分子动力学模拟数据。稳定性工程方面,二硫键引入(如在VH-VL界面引入非天然二硫键稳定配对)、半胱氨酸扫描(系统性地将每个残基突变为半胱氨酸以检测二硫键可行性)和构象稳定性优化(通过热 challenge 筛选耐热克隆)可将抗体的Tm值提高5-15°C,显著改善其可开发性。
四、噬菌体展示多肽筛选与靶向应用
噬菌体展示靶向多肽筛选的核心挑战在于平衡亲和力、特异性和构象稳定性三者的关系。线性肽文库(如Ph.D.-7和Ph.D.-12系统)构建简便,筛选通量高,但线性肽在血清中的蛋白酶稳定性差且构象柔性过大导致熵罚高、结合亲和力受限。环肽文库(cyclic peptide library)通过构象约束将柔性肽锁定在特定空间构象中,大幅降低了结合时的构象熵损失,使表观亲和力提升1-3个数量级。半胱氨酸成环(cyclization)条件的优化是多肽功能化的关键步骤:二硫键成环(Cys-Cys氧化)操作简便但还原环境(如细胞内)中不稳定;硫醚键成环通过半胱氨酸与卤代乙酰胺或马来酰亚胺反应,在生理条件下稳定;酰胺键成环(如内酰胺桥,通过Asp/Glu与Lys侧链缩合)提供了最高的化学稳定性且可通过固相合成精确控制环大小。
多肽筛选中的亲和力-特异性平衡是一个需要精细调控的工程问题。7-mer短肽文库适用于筛选识别浅表线性表位的配体,如蛋白酶底物序列和受体结合 motif;12-mer文库在保持适度构象多样性的同时提供了更深的表位覆盖能力,适合筛选识别浅凹槽表位的配体;20-mer长肽文库适用于模拟天然蛋白-蛋白相互作用界面,但其构象不确定性也最高。靶向肿瘤微环境的多肽筛选正在从单纯的"结合型"向"功能型"演进:pH敏感肽利用肿瘤微环境(pH 6.5-6.8)与正常组织(pH 7.4)的酸度差异,通过组氨酸残基的咪唑基团pH依赖性质子化实现选择性释放,在正常pH下组氨酸不带电、肽呈无活性构象,在肿瘤酸性环境中组氨酸质子化触发构象切换暴露结合界面。蛋白酶底物肽的设计利用肿瘤过表达蛋白酶(如MMP-2/9、uPA、legumain)的切割活性,将多肽前药在肿瘤局部激活,这一策略已被广泛应用于肿瘤靶向成像和前药递送。
细胞穿膜肽(CPP)的噬菌体筛选采用内化筛选(internalization panning)策略:将噬菌体文库与靶细胞孵育后,通过蛋白酶处理去除表面结合但未内化的噬菌体,裂解细胞释放内化噬菌体进行扩增。操作要点在于温度控制(37°C保证内吞途径活跃)、孵育时间(30-60分钟以区分快速内化与慢速内化)和蛋白酶选择(trypsin浓度需优化以完全去除表面结合但不损伤细胞膜完整性)。器官特异性归巢肽(homing peptide)的体内筛选将噬菌体文库经尾静脉注射到小鼠体内,经过一定循环时间后回收靶器官中的噬菌体,这一策略发现了识别肿瘤血管、肾脏、脑、胰腺等器官特异性标志物的多肽配体,如经典的RGD-4C肽靶向肿瘤新生血管整合素αvβ3,和CGKRK肽靶向肿瘤血管内皮。噬菌体展示多肽在分子成像中的应用通过放射性核素标记实现:64Cu或68Ga通过DOTA或NOTA螯合剂偶联到多肽N端或侧链功能基团,PET成像的灵敏度可达皮摩尔级别,如PSMA靶向肽在前列腺癌成像中的临床转化。多肽-药物偶联物(PDC)的靶向递送设计中,连接子(linker)选择决定了药物释放的时空精确性:酸敏连接子(hydrazone)在溶酶体酸性环境中断裂释放游离药物;酶切连接子(如GFLG四肽序列)被溶酶体cathepsin B特异性切割;二硫连接子在细胞内高浓度谷胱甘肽还原下断裂。与白蛋白结合肽(ALB-binding peptide)融合可利用白蛋白的天然长半衰期(约19天)将短肽的体内半衰期从分钟级延长至小时甚至天级,这一策略已在多个临床候选PDC中得到验证。双功能多肽的设计通过串联或分叉结构使一个肽分子同时靶向两个不同分子,如RGD-神经肽Y双功能肽同时靶向肿瘤血管和肿瘤细胞,实现双重靶向递送。这类异源二聚体肽的构建需兼顾两个结合域的空间取向和连接肽的柔韧性,确保任一功能域的活性不被空间位阻屏蔽。
五、噬菌体展示在药物发现全链条中的应用
噬菌体展示药物发现应用已贯穿从靶点确证到IND申报的完整研发链条。在全人源抗体药物开发流程中,噬菌体展示技术提供了从天然或合成文库直接筛选全人源序列的能力,规避了鼠源抗体需要人源化改造的免疫原性风险。噬菌体展示来源的抗体药物已在市场中占据重要地位:阿达木单抗(adalimumab/Humira)源自Cambridge Antibody Technology的噬菌体展示人源抗体文库(该文库使用Tomlinson框架构建),靶向TNF-α,通过亲和力成熟从初始纳摩尔级提升至亚纳摩尔级,成为史上最畅销的处方药物;贝利尤单抗(belimumab/Benlysta)靶向BLyS/BAFF,同样源自噬菌体展示筛选,是首个获批用于系统性红斑狼疮的生物制剂。这些案例验证了从文库筛选到IND申报的完整路径可行性和商业价值。
双特异性抗体的噬菌体展示筛选策略呈现多样化格局。dual-scFv格式将两个scFv串联表达,通过linker连接实现双靶点结合,筛选时可采用顺序筛选策略,先针对第一靶标筛选,再对阳性克隆进行第二靶标的结合验证。tandem-scFv格式在dual-scFv基础上优化了连接肽长度和域间排列,改善了分子内折叠。DVD-Ig(Dual Variable Domain Immunoglobulin)格式将两个可变域串联置于常规IgG的VH/VL之前,保持了天然IgG的结构和药代特性,噬菌体展示在其中用于筛选两个可变域的最优组合。嵌合抗原受体(CAR)的胞外抗原结合域优化是细胞治疗领域的关键环节,scFv亲和力调谐需要防止抗原脱离(tonic signaling)和靶点丢失逃逸:亲和力过高可能导致低抗原表达细胞被过度激活引发毒性,亲和力过低则导致抗原阴性逃逸。噬菌体展示通过多轮亲和力梯度筛选精确调谐scFv的亲和力至最优窗口,已在CD19、BCMA、Claudin18.2等靶点的CAR设计中发挥核心作用。
图3. 噬菌体展示在抗体药物发现全链条中的应用:从双特异性抗体、CAR设计到ADC偶联与靶向治疗转化
抗体偶联药物(ADC)中抗体部分的噬菌体展示筛选需要同时优化结合亲和力和内化效率,筛选策略从传统的结合导向型转向内化导向型,通过内化筛选直接选择能够高效内化进入靶细胞的克隆,评估指标包括内化速率(半衰期通常需小于30分钟)和细胞内滞留时间。纳米抗体(VHH)和单域抗体的噬菌体展示以驼源免疫文库为经典路线:羊驼免疫后外周血B细胞中重链抗体(HCAb)的VHH域被克隆到噬菌体展示载体,因VHH的CDR3区通常较长且可形成凸环结构(loop structure),能够触及传统抗体无法接触的凹槽表位(如酶活性位点)。合成VHH文库通过人工设计CDR3随机化区域,在可设计性和批次一致性上优于免疫文库,且避免了动物使用的伦理问题。PROTAC分子中靶蛋白结合配体的噬菌体展示来源正在兴起,通过噬菌体展示筛选靶向特定E3连接酶底物结合域的多肽配体,替代传统的小分子配体,如VHL和CRBN配体。噬菌体展示在疫苗设计中通过表位映射技术精确定义保护性抗原表位:将病原体蛋白的表位肽段展示在噬菌体表面,通过与康复患者血清的免疫筛选识别免疫优势表位,指导基于表位的疫苗设计。噬菌体展示在蛋白工程中实现了酶活性和结合蛋白的定向进化,通过将酶的活性位点周围残基随机突变并展示在噬菌体表面,以底物类似物或过渡态类似物为靶标进行筛选,可定向进化出具有新催化活性的酶变体。从噬菌体展示到mRNA治疗的转化代表了技术融合的前沿方向:噬菌体展示筛选获得的抗体序列可直接编码为mRNA序列,通过脂质纳米颗粒(LNP)递送后在体内瞬时表达,实现"体内抗体工厂"的治疗模式,这一策略在传染病被动免疫和肿瘤免疫治疗中展现出巨大潜力。
六、AI赋能噬菌体展示与未来技术趋势
噬菌体展示AI辅助筛选正在从根本上重塑抗体发现的工作流程。深度学习模型在预测抗体-抗原结合亲和力方面取得了突破性进展:AlphaFold2及其衍生的AlphaFold-Multimer能够以原子级精度预测抗体-抗原复合物的三维结构,为理解结合界面提供了前所未有的结构洞察;AntiBERTy等基于Transformer架构的蛋白质语言模型通过在大规模抗体序列数据库上预训练,学会了捕获V(D)J重组模式和CDR序列的特征表示,在序列优化中的应用表现为对突变文库中每个变体的结合亲和力进行计算预测,大幅减少了需要实验验证的克隆数量。在噬菌体展示亲和力成熟中,AI模型可基于已有筛选轮次的序列-结合数据训练亲和力预测器,指导下一轮突变文库的设计,从随机突变转向计算优化的聚焦突变,使每次筛选循环的信息效率提升数倍。
生成式AI在合成抗体文库设计中的应用正在颠覆传统文库构建范式。变分自编码器(VAE)和扩散模型(diffusion model)能够学习天然抗体序列空间的潜在分布,并生成覆盖未探索序列空间的新颖抗体序列。这些计算生成的序列在保持天然抗体框架特征的同时,在CDR区引入了超越天然多样性的突变组合,使噬菌体展示文库的序列空间探索效率实现数量级提升。噬菌体展示高通量测序(NGS)数据的机器学习挖掘是发现隐藏高价值克隆的关键技术,传统筛选仅回收排名前列的高频克隆,而NGS数据中蕴含的低频克隆可能包含独特的高亲和力序列。通过序列聚类和亲和力回归模型,可从数百万条NGS reads中识别出被传统分析方法遗漏的低频高亲和力克隆,这一策略已在多个项目中发现了被排名前列克隆掩盖的稀有但更优的候选序列。
前沿趋势:计算指导的亲和力成熟正在从"实验驱动"向"计算驱动"转变,AlphaFold2结构预测与分子动力学模拟结合,可在计算机上完成数百万次虚拟突变筛选,仅将计算预测的Top候选进行实验验证,使亲和力成熟的成本和时间降低一个数量级。
AI预测的表位-副表位(paratope)网络模型在降低脱靶毒性中具有预测价值,通过深度学习模型预测抗体CDR区与抗原表面的接触残基网络,识别潜在的脱靶结合位点,在筛选早期阶段过滤具有高脱靶风险的克隆。数字噬菌体展示(digital phage display)概念将计算模拟推向了极致:通过物理模型计算虚拟文库中每个克隆与靶分子的结合自由能,完全在计算机中完成筛选过程,虽然目前这一概念仍受限于计算精度和速度,但随着GPU算力的指数增长和算法优化,对中小型文库(10^4-10^5克隆)的虚拟筛选已初具可行性。噬菌体展示与单细胞测序的联用创造了B细胞受体(BCR)库与合成文库的交叉参考策略:通过单细胞BCR测序获得天然抗体的V(D)J序列和配对的重轻链信息,将这些天然序列特征注入合成文库的设计中,使合成文库的CDR区组成更加接近天然免疫库的高亲和力分布,这一策略弥合了合成文库的可设计性与天然文库的亲和力优势之间的鸿沟。微流控-噬菌体展示联用平台在单分子水平上突破了传统筛选的通量瓶颈:通过微液滴(microdroplet)包裹单个噬菌体-靶分子-荧光探针复合体,在微流控芯片上以每秒数万滴的速度实现荧光分选,筛选通量较传统淘洗提升3-4个数量级。合成生物学与噬菌体展示的交叉融合正在催生从头设计的人工受体结合蛋白,通过计算设计的重复蛋白(repeat protein)骨架替代天然抗体框架,在噬菌体展示上展示并筛选,可获得具有新型拓扑结构和功能特性的结合分子。噬菌体展示技术在未来精准医学中的角色将是个体化抗体药物的快速发现引擎:从患者肿瘤活检组织中快速建库、筛选、优化到获得个体化靶向抗体,全流程时间从传统数月压缩至数周,为精准医学的药物个体化提供了技术基础。
 X