DNA测序技术的进阶应用与临床转化
DNA测序技术正在经历一场从读长到通量再到临床落地的多维变革。十年前我们还在讨论一个基因组要花多少天才能测完,如今的话题已经转向了哪个平台更适合在24小时内完成数百例临床样本的检测。从Illumina的短读长霸主地位,到PacBio的HiFi读长崛起,再到Oxford Nanopore把测序仪做到USB大小,技术的迭代速度远超大多数人的预期。但真正值得关注的不是技术本身的炫酷,而是这些技术如何一步步走入临床路径,从科研工具变成了诊断决策的依据。
这篇文章不聊基础原理,而是直接切入各平台的参数对比、长读长在结构变异检测中的不可替代性、单细胞测序如何重塑肿瘤微环境认知、液体活检的临床验证逻辑,以及生物信息流程的标准化进程。如果你已经在做测序相关的工作,或者正准备选型上马一个测序项目,这些内容应该能给你一些实打实的参考。
一、测序平台的技术迭代与读长突破
当前主流测序平台的竞争格局已经不是"谁能测得更快"这么简单的问题了,而是变成了"在特定应用场景下谁能给出最优解"的多维博弈。二代测序平台对比的核心维度早就从单纯的通量转移到了读长、错误率、成本和灵活性的综合考量上。选平台不是看谁的参数表更漂亮,而是看你的项目到底需要什么样的数据。
先说Illumina NovaSeq X系列,这台机器目前还是短读长测序的标杆。单次运行可以产出高达16Tb的数据量,双flow cell配置下一次运行能测掉上百个人类基因组。读长方面,NovaSeq的PE150(双端150bp)已经是常规配置,虽然读长不占优势,但每碱基的错误率控制在0.1%以下,这个精度在临床级SNV检测中几乎是硬门槛。NovaSeq的问题在于灵活性和启动成本——跑一个flow cell的固定开销不低,如果样本量不够撑满,单位成本就会飙升。后来Illumina推出了NovaSeq X Plus和更灵活的NextSeq系列来覆盖中小规模项目,但核心瓶颈依然是"要不要为一个flow cell的固定成本买单"的决策。
| 平台 | 典型读长 | 单次运行通量 | 原始错误率 | 核心适用场景 |
|---|---|---|---|---|
| Illumina NovaSeq X | PE150 | ~16 Tb | <0.1% | 大规模群体基因组、临床SNV检测 |
| 华大 DNBSEQ-T7+ | PE150 | ~1 Tb/日 | <0.1% | 群体遗传学、低duplicate项目 |
| PacBio Revio (HiFi) | 15-25 kb | ~360 Gb | Q30+ (<0.1%) | 结构变异、基因组组装、复杂区域解析 |
| Oxford Nanopore PromethION | N50 >100 kb | 数 Tb(可变) | Q20+ (R10.4.1) | 超长读长组装、实时监测、甲基化直接检测 |
华大智造的DNBSEQ-T7+走的是另一条技术路线,核心差异在于DNB(DNA纳米球)技术和cPAS(联合探针锚定聚合)测序化学。DNBSEQ-T7+单日产出可达Tb级别,而且因为DNB扩增方式不同于Illumina的桥式PCR,理论上扩增偏差更小,duplicate rate更低。在实际的群体遗传学项目中,这一点对数据质量有实质影响——较低的duplicate rate意味着同样的测序量可以获得更多有效覆盖深度,间接提升了数据利用效率。但读长上限同样是PE150,在需要长读长的场景里没有话语权。华大在海外市场的推广策略也和Illumina不同,更倾向于整体解决方案打包交付,这对一些新建测序中心的团队来说降低了上手门槛。
说到长读长,PacBio Revio是当前三代单分子实时测序的主力平台。Revio的HiFi读长模式可以产出Q30以上的高质量读长,平均长度在15-25kb区间,这对于跨越复杂重复区域、解析大片段结构变异来说是质变级别的提升。Revio的通量相比上一代Sequel IIe提升了大约4倍,单次运行产出约360Gb HiFi数据,虽然和NovaSeq的Tb级别没法比,但在需要长读长的应用场景里,这个产出已经足够支撑数十个高质量人类基因组的de novo组装。Revio的另一个改进是仪器体积和运行成本都显著低于上一代,这使得中小型实验室也能负担得起长读长测序,不再像以前那样只能依赖大型测序中心的服务。
Oxford Nanopore的PromethION则代表了纳米孔长读长测序的另一种思路。PromethION可以产出超长读长,N50轻松突破100kb,个别reads甚至能达到Mb级别。这种超长读长在基因组gap填补和端粒到端粒(T2T)组装中几乎是不可替代的——人类基因组中最后被填补的gap,包括着丝粒和核糖体DNA簇区域,就是靠Nanopore的超长读长加上PacBio HiFi的联合策略才完成的。但Nanopore的历史痛点是单碱基准确率,早期的R9芯片错误率在5-10%之间,虽然R10.4.1化学已经把raw read准确率推到了Q20以上,但在SNV级别的检测上仍然不如Illumina和PacBio HiFi可靠。不过Nanopore的灵活性是独一份的——你可以随时停机、随时看数据,这对于疫情监控或田间育种这种需要实时反馈的场景来说价值巨大。
选型策略上没有万能解。如果你做的是大规模群体基因组学,NovaSeq或DNBSEQ-T7+的高通量低成本优势压倒一切。如果你关注的是复杂区域解析或结构变异,PacBio Revio的HiFi模式是当前最稳妥的平衡点。如果你要做的是实时监控或者超长读长组装,Nanopore的灵活性加上Mb级读长是其他平台给不了的。实际项目里,越来越多团队采用的是多平台组合策略,用短读长做高精度SNV检测,用长读长补结构变异和重复区域,这种互补方案正在成为基因组学研究的标准操作。
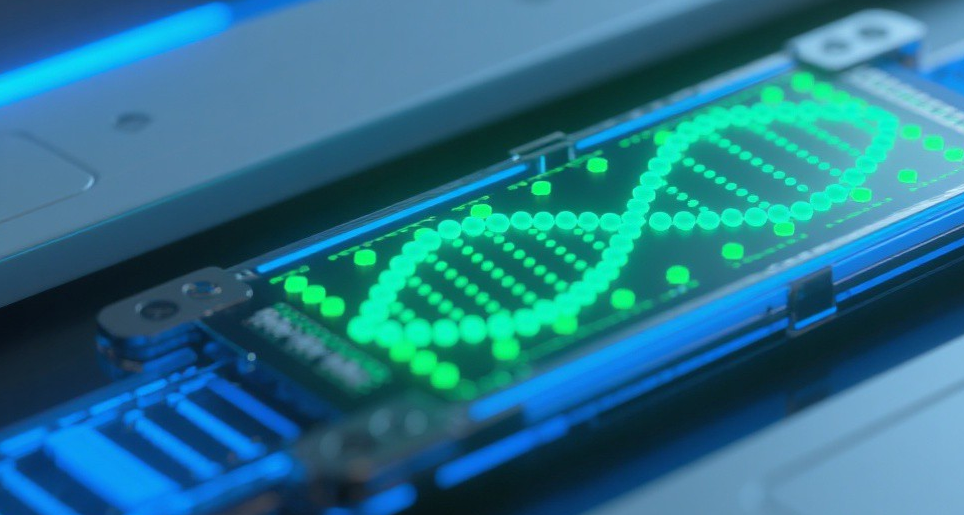
图1. 二代测序flow cell表面荧光簇信号检测示意,每个亮点代表一个克隆扩增的DNA簇
二、长读长测序对结构变异检测的不可替代性
结构变异检测这个领域,短读长测序的天花板已经非常明显了。结构变异涵盖了从50bp到数Mb的插入、缺失、倒位、易位和复杂重排,这类变异涉及的序列跨度远超短读长的覆盖范围。Illumina的PE150在读到一段断裂的read pair时,只能推断"这里可能有一个SV",但具体断点在哪、插入序列是什么、倒位的方向和精确边界,短读长往往是束手无策的。这不是算法不够好的问题,是数据本身的信息量就不够。
具体来说,短读长在结构变异检测中有三个典型的盲区。第一是串联重复区域,比如着丝粒附近的α卫星重复和端粒区域,这些地方的序列高度相似,短读长根本无法唯一比对到具体位置,mapping质量骤降,直接导致这些区域的SV检测成了黑箱。第二是高度同源区段,比如HLA基因座和PMS2等具有假基因的基因,短读长无法区分真实基因和假基因,错比对会带来大量的假阳性和假阴性。第三是中等大小的结构变异(1-10kb),这些变异大到跨越多个read但小到不容易被覆盖深度异常检测到,是短读长检测的重灾区。有研究估计,仅靠短读长WGS数据,人类基因组中大约30-40%的结构变异无法被可靠检出。
长读长在这里的价值就体现出来了。PacBio HiFi读长平均15-25kb的长度足以跨越绝大多数散在重复元件,比如Alu元件(约300bp)和LINE-1元件(约6kb)。一段HiFi读长可以完整覆盖多个Alu元件并锚定到唯一的基因组位置,这对于解析Alu介导的重组事件引发的基因组重排至关重要——这类重排在地中海贫血、血友病等单基因病的致病机制中占了不小比例。更重要的是,HiFi读长的准确率在Q30以上,这意味着不需要深度覆盖就能可靠地调用变异,大幅降低了测序成本和数据计算量。在临床遗传学诊断中,很多致病变异恰恰落在短读长的盲区里,用HiFi读长直接覆盖这些区域,有时候比反复验证短读长结果更高效也更可靠。
关键数据:全基因组重测序如果只用短读长,大约只能检测到60-70%的结构变异,剩下的30-40%需要长读长来补全。在临床遗传学诊断中,这些"漏掉"的SV中有相当比例是致病性的——长读长不是可选项,而是完整解析基因组的必要条件。
纳米孔长读长测序则带来了另一个独特的优势——直接检测DNA甲基化。传统的甲基化检测依赖亚硫酸氢盐转化(bisulfite conversion),这个过程会破坏DNA,导致片段化和DNA损失,而且转化效率不是100%,未转化的胞嘧啶会被误判为甲基化。Nanopore测序中,DNA聚合酶或解旋酶推动DNA链穿过纳米孔时,不同甲基化状态的碱基会产生特征性的电流信号变化,软件(如Megalodon、Remora)可以直接从raw signal中识别出5mC和6mA修饰。这意味着你不需要额外做亚硫酸氢盐转化,一次测序就能同时拿到序列信息和表观遗传信息。对于需要同时分析结构变异和甲基化状态的研究,比如肿瘤抑制基因启动子的异常甲基化伴随杂合性缺失的情况,Nanopore测序在效率和信息密度上都有明显优势。更进一步,Nanopore还能检测其他的碱基修饰如hmC和m6A,这些修饰在基因调控中的角色正在被逐步揭示,而亚硫酸氢盐方法根本无法区分mC和hmC。
实际应用中,越来越多的基因组项目开始把长读长作为结构变异检测的主力手段。全基因组重测序如果只用短读长,大概只能检测到60-70%的SV,剩下的30-40%需要长读长来补全。这个差距在临床遗传学中不是可以忽略的——很多致病性SV恰恰落在短读长的检测盲区里。一些前沿的诊断实验室已经开始在疑难遗传病案例中使用长读长测序作为短读长阴性结果后的二线检测手段,而且数据显示这种策略确实能够额外检出相当比例的致病变异,显著提高了分子诊断率。
图2. 纳米孔测序原理示意,DNA链在马达蛋白牵引下穿过生物孔道,电流信号变化反映碱基序列
三、单细胞测序解析肿瘤微环境异质性
单细胞RNA测序在肿瘤研究中的应用已经不是"锦上添花"了,而是变成了理解肿瘤微环境异质性的核心工具。传统的bulk RNA-seq给的是细胞群体的平均表达信号,这在肿瘤这种高度异质性的组织中会把不同亚群的特征相互稀释和掩盖。scRNA-seq直接到单细胞分辨率,能够把肿瘤组织中混杂的恶性细胞、基质细胞、免疫细胞逐个拆开,看清楚每个细胞亚群的转录状态和细胞间通讯网络。这种分辨率层面的跃迁改变了我们对肿瘤生物学的认知方式。
在肿瘤免疫微环境研究中,scRNA-seq最有价值的应用之一是T细胞耗竭轨迹的追踪。肿瘤浸润T细胞从效应状态到耗竭状态的转变不是一蹴而就的,而是一个连续的动态过程。通过scRNA-seq的数据,结合拟时间分析(pseudotime analysis),可以重建T细胞从初始激活到终末耗竭的完整轨迹,识别出轨迹上关键的转录因子和检查点分子的动态表达模式。比如,TCF7+的干性样T细胞亚群在免疫治疗响应中的预测价值,就是通过scRNA-seq首先揭示的——这些细胞在接受ICB(免疫检查点阻断)治疗后能够重新扩增并恢复效应功能,是治疗响应的关键细胞群体。这类发现直接来自scRNA-seq对T细胞亚群的精细分型,bulk层面的分析根本看不到这种异质性。后续的功能验证研究进一步确认了这些干性样T细胞在CAR-T治疗和肿瘤疫苗响应中的核心地位。
肿瘤干细胞亚群的鉴定是另一个scRNA-seq大展身手的场景。肿瘤干细胞概念认为,肿瘤内部存在一小群具有自我更新和分化能力的细胞,它们对治疗耐药和复发负责。通过scRNA-seq,研究者可以在单细胞水平上识别出表达干性标志物(如SOX2、NANOG、ALDH1)的细胞亚群,并追踪这些细胞在治疗前后的比例变化和转录状态漂移。这对于理解治疗耐药的细胞基础和设计针对干细胞的治疗策略至关重要。某些研究还通过scRNA-seq揭示了肿瘤干细胞和非干细胞之间的状态转换是可逆的,这挑战了之前认为干细胞状态是固定不变的观点,对靶向干细胞的策略设计有直接影响。
技术平台方面,10x Genomics Chromium和BD Rhapsody是当前单细胞RNA测序两个主流选择。10x Chromium基于微流控液滴技术,一次运行可以捕获上千到上万个细胞,双胞率(doublet rate)大约在0.8%每1000个细胞的水平。Chromium的优势在于通量高、配套试剂和软件生态成熟,CellRanger流程已经是行业标准。BD Rhapsody采用的是微孔(microwell)技术,细胞捕获方式有所不同,在处理特定样本类型(如FFPE样本或脆弱细胞)时有一定优势,但通量相对较低。两个平台在基因捕获的灵敏度、3'端vs全长的偏好、以及多重检测能力上各有取舍。实际选型时,样本数量、细胞活性、是否需要V(D)J信息、预算约束都是要考虑的因素。近年来还出现了基于组合条码的高通量单细胞方法(如Parse Biosciences的split-pool策略),可以在不依赖微流控设备的情况下实现超大规模的细胞通量,适合需要数万到数十万细胞通量的研究。
图3. 单细胞测序微流控液滴技术示意,单个细胞与barcode磁珠被包裹在同一液滴中实现单细胞标记
值得注意的是,scRNA-seq的数据分析已经从简单的聚类注释走向了更复杂的方向。细胞-细胞通讯分析(如CellChat、NicheNet)、轨迹推断(如Monocle3、RNA velocity)、空间转录组数据的整合分析,这些都要求研究者具备扎实的数据处理能力和生物学解读能力。单细胞数据的维度和复杂度远超bulk RNA-seq,后续的数据挖掘和分析才是真正的瓶颈所在。空间转录组学(如10x Visium、Stereo-seq)的兴起正在把单细胞数据从"拆开看"推向"放回去看"的新阶段,将单细胞分辨率和空间位置信息结合,对于理解肿瘤微环境中细胞间的空间互作关系有巨大潜力。
四、液体活检ctDNA测序的临床验证路径
液体活检ctDNA测序从科研走向临床的过程,本质上是一个不断验证检测灵敏度、特异度和临床决策价值的过程。ctDNA(循环肿瘤DNA)是肿瘤细胞释放到血液中的片段化DNA,浓度通常在0.1%到ng/mL级别,早期癌症患者体内可能更低。要在这么低的丰度下可靠地检测出肿瘤来源的突变,技术挑战相当大。这不仅仅是测序深度的问题,而是整个检测体系从文库构建到生物信息分析全链路的精度挑战。
先说MRD(微小残留病灶)监测。MRD监测的核心需求是在治疗后(手术后或辅助治疗后)检测是否还有残留的肿瘤分子证据。这里的检出限(limit of detection, LoD)直接决定了临床价值——如果检测方法只能检出1%的VAF(变异等位基因频率),那它在MRD场景下基本没有用,因为MRD相关的ctDNA丰度通常在0.01%到0.5%之间。要达到0.01%甚至更低的检出限,需要在技术上做一系列优化。Tumor-informed策略(基于患者肿瘤组织已知突变设计定制化panel)和Tumor-naive策略(不依赖肿瘤组织信息,使用固定panel或WBC突变过滤)各有优劣,前者灵敏度更高但需要肿瘤组织样本,后者适用面更广但灵敏度受限于panel覆盖范围和克隆性造血突变的干扰。
ctDNA的半衰期大约在30分钟到2小时之间(受肾功能和肿瘤负荷影响),这个特征决定了采样时间窗的设计。手术后立即采血可能检出的是术中释放的ctDNA,不代表真实的MRD状态,通常需要等待1-7天让术中释放的ctDNA清除后再采样。在治疗随访中,ctDNA的动态变化(升高或清除)比绝对值更有临床意义,连续监测的策略设计比单次检测更有价值。ctDNA转阴的时间点、持续阴性的维持时间、以及复发前的ctDNA上升斜率,这些都是临床决策中需要综合考量的动态指标。
UMI(唯一分子标识)技术在低频突变检测中扮演了关键角色。高通量测序的固有错误来自文库构建过程中的PCR扩增错误和测序仪本身的碱基错误率,这些错误在低频突变检测中会构成严重的背景噪声。UMI的原理是给每条原始DNA分子在PCR扩增前加上一个唯一标签,这样后续的测序reads可以通过UMI回溯到原始分子,同一UMI标签的多条reads之间可以交叉验证,真实的突变会在同一UMI家族的多条reads中一致出现,而随机错误不会。这种策略可以把背景错误率从10的负3次方降到10的负5次方甚至更低,是超低频突变检测的必要手段。基于UMI的共识序列生成(consensus calling)已经成为临床级ctDNA检测的标准配置。
核心要点:MRD监测中ctDNA的检出限需要达到0.01% VAF级别才能满足临床需求。UMI技术通过分子标签回溯原始分子,将背景错误率从10^-3降至10^-5以下。双端共识测序(duplex consensus)进一步要求正义链和反义链同时检出同一突变,理论上可将错误率推至10^-7水平——这是检测超低频突变的终极防线。
降低背景噪声的其他策略还包括双端分子标签(duplex consensus sequencing),要求正义链和反义链都检出同一突变,进一步降低假阳性。实验室层面的污染控制、分子标签索引平衡(index hopping)的防范、批次效应的监控,这些都是液体活检ctDNA测序在临床验证中必须解决的工程问题。样本采集环节同样关键——不同的采血管(EDTA vs Streck cfDNA管)对ctDNA的保存效果不同,样本运输条件、处理时间窗都会影响数据质量,这些前分析变量在临床场景中往往被低估但影响巨大。
临床验证路径上,ctDNA检测方法需要经过分析验证和临床验证两个层面。分析验证关注的是检测方法的灵敏度、特异度、精密度、可报告范围等分析性能指标,需要用参考物质(如Horizon Discovery的标准品)和方法学比对来确认。临床验证则需要在目标患者队列中评估检测结果的临床敏感度、特异度和预测值,这类研究通常需要较大样本量和前瞻性设计。NMPA(国家药监局)和FDA对ctDNA检测产品的审批要求也在不断细化,从早期只关注检测性能逐步走向要求提供临床结局改善的证据。FDA批准的几个ctDNA伴随诊断产品(如Guardant360 CDx、FoundationOne Liquid CDx)已经为后续产品的注册路径提供了参考框架,但每个新的适应症和检测方法仍需要独立的临床验证数据支撑。
五、测序成本下降驱动下的精准医疗经济性
测序成本的下降轨迹本身就是一个值得研究的经济现象。2003年人类基因组计划完成时,一个基因组的测序成本大约是30亿美元。2007年高通量测序技术开始大规模应用后,成本曲线开始急剧下降,远超摩尔定律的节奏。到2014年,Illumina宣布HiSeq X Ten实现了1000美元基因组。2026年全球基因组市场规模已经突破数百亿美元级别,而100美元基因组的目标也在多个技术路线的推动下逐步逼近。成本的下降不只是仪器和试剂的改进,还受益于文库制备自动化、生物信息分析流程的标准化和规模化运营带来的边际成本递减。
100美元基因组如果真正实现,对临床路径的影响是深远的。首先,全基因组重测序的门槛会大幅降低,意味着更多的患者可以接受基因组级别的分子诊断,而不是仅限于热点突变检测panel。这直接关系到罕见病诊断——目前罕见病患者的基因组测序覆盖率远低于需求,成本是主要障碍之一。其次,肿瘤患者的基因组测序可以作为常规分子病理检查纳入诊疗流程,而不是当前仅用于特定适应症患者的伴随诊断。这会改变肿瘤靶向药物的使用模式——更多患者有机会进入精准匹配的靶向治疗,而不是靠"试错-换药"的经验性治疗路径。
医保覆盖的经济学边界是另一个核心问题。基因组测序能否纳入医保覆盖,不取决于技术本身的好坏,而取决于成本-效益分析的结果。如果基因组测序能够缩短诊断周期(比如罕见病患者的诊断性漫游平均需要4-7年)、减少无效治疗、改善预后,那这些节省的医疗成本能否抵消测序本身的费用?经济性评估模型(如QALY分析,质量调整生命年)是医保决策的重要依据,但目前高质量的测序经济学研究还不够充分,特别是在中国人群中缺乏本地化的成本-效益数据。随着国产测序平台(华大智造、真迈等)的崛起,测序设备和试剂的国产化正在推动成本进一步下探,这也为医保覆盖创造了更有利的成本条件。
另一个值得关注的趋势是测序服务和数据价值的分离。随着测序成本下降,测序本身越来越像一个低利润的商品化服务,而测序数据的分析和解读成为真正的价值增长点。这意味着产业链的价值在向上游(数据分析、AI辅助解读)和下游(临床决策支持、患者管理)转移。对于检测机构来说,单纯靠卖测序数据量的商业模式利润空间会被持续压缩,能够提供数据解读和临床决策支持的综合服务商才更有竞争力。这种产业结构的调整正在全球范围内发生,中国的测序服务市场也在经历类似的整合和分化,头部企业开始从单纯的测序服务向"测序+分析+报告+临床支持"的全链条模式转型。
六、生物信息分析流程的标准化与AI辅助
测序数据生物信息分析的标准化是确保结果可重复、可比性的基础。在变异检测领域,GATK Best Practices已经成为了事实上的标准流程。这套流程由Broad研究所开发,涵盖了从原始数据质控(FastQC、MultiQC)、序列比对(BWA-MEM2)、比对后处理(SortSam、MarkDuplicates)、碱基质量分数校正(BaseRecalibrator)到变异检测(HaplotypeCaller)的完整链路。GATK流程的标准化价值在于,不同实验室使用相同流程得到的结果具有可比性,这对于多中心研究、临床验证的数据互认至关重要。但标准化的另一面是,它也可能掩盖特定场景下的优化需求——比如低频突变检测或肿瘤-正常配对检测,GATK的默认参数未必是最优的,需要根据应用场景调整。此外,GATK对计算资源的需求不低,大规模WGS项目的计算成本也是需要纳入预算考量的实际因素。
AI在变异调用中的角色正在快速演变。DeepVariant是Google开发的一个基于深度学习的变异调用工具,它把比对信息转化为图像张量(tensor),利用CNN架构来区分真实变异和测序错误。在多个基准测试中,DeepVariant在SNV检测上的F1 score超过了GATK HaplotypeCaller,特别是在Indel检测上优势明显。DeepVariant的价值不在于它用了多炫的模型架构,而在于它通过数据驱动的方式学到了传统统计模型难以捕捉的错误模式,比如特定序列上下文下的碱基错误偏向。Clair3是另一个值得关注的AI变异调用工具,专为长读长测序设计,在PacBio HiFi和Nanopore数据上的表现已经接近甚至超过了短读长平台上的DeepVariant,这使得长读长数据在SNV检测层面的可靠性有了实质提升。
在结构变异调用方面,AI辅助工具也在快速涌现。传统的SV检测工具如Manta、Delly、Lumpy主要依赖read pair和split read信号,但在复杂SV和断点精确定位上仍有不足。基于深度学习的工具如Sniffles2(针对长读长数据)和NeoLoop在复杂重排检测上表现出了更好的敏感度和特异度。这些工具的核心改进在于利用神经网络学习测序reads的特征模式,能够在噪声数据中更准确地识别真实的结构变异信号。AI辅助的SV调用在长读长数据上尤其有价值,因为长读长数据的信号特征和短读长完全不同,传统基于短读长设计的工具迁移到长读长上效果不佳,需要专门为长读长数据训练的模型。
流程编排和可重复性方面,容器化技术(Docker、Singularity)配合流程管理工具(Nextflow、Snakemake、WDL)使得分析流程的标准化和可移植性大幅提升。nf-core社区维护的开源流程集合已经成为很多团队的标准参考,这些流程经过社区验证和持续迭代,降低了自建流程的维护成本。但标准化流程在临床应用中还需要额外的验证要求,包括监管合规(如LDT实验室自建项目的验证)、数据安全(患者基因组数据的隐私保护)和结果可追溯性。这些非技术因素在实际落地中往往比算法本身的性能更具有决定性——一个临床检测产品能否获批,合规体系的完善程度有时候比检测灵敏度的数字更关键。
回顾测序技术这些年的发展,从Sanger测序到高通量二代测序,再到三代长读长和单分子测序,每一次技术迭代都不仅仅是参数的提升,而是开辟了新的应用维度和临床场景。长读长测序让我们终于能够看到基因组的"暗物质"区域,单细胞测序让我们理解了肿瘤内部的异质性景观,液体活检把基因组信息变成了可动态监测的临床指标,AI辅助的生物信息分析让海量数据的解读变得可行且可靠。这些技术的交汇正在推动精准医疗从概念走向现实。
但我们也必须清醒地看到,技术到临床之间的距离远比技术本身的迭代要漫长——分析方法标准化、临床验证体系的完善、医保经济学的支撑、数据隐私和伦理的保障,这些环节的成熟度决定了测序技术能在多大程度上改变患者的诊疗结局。未来几年,测序技术本身的突破可能不再是瓶颈,真正的挑战在于如何把这些技术能力转化为临床路径中可执行、可负担、可监管的常规诊疗手段。这条路需要技术团队、临床团队、监管机构和支付方的协同推进,任何一个环节的短板都会成为整体落地的制约因素。
 X