噬菌体库筛选技术的流程与抗体发现应用
一、噬菌体展示技术在现代抗体发现中的战略地位
噬菌体展示技术自1990年由Smith首次报道以来,已经发展成为抗体发现领域最成熟、应用最广泛的体外筛选平台之一。2018年,该技术的发明者George P. Smith和Gregory P. Winter因其在噬菌体展示和定向进化方面的贡献获得诺贝尔化学奖,标志着这一技术在科学界获得了至高认可。与传统的杂交瘤技术相比,噬菌体展示不依赖动物免疫系统,可以筛选人源抗体序列,且筛选周期从数月缩短至数周,已经成为治疗性抗体发现的主流路径之一。
噬菌体展示的核心原理是将外源蛋白或多肽的DNA序列与噬菌体外壳蛋白基因融合,使外源蛋白展示在噬菌体颗粒表面,实现基因型和表型的物理关联。通过"结合—洗涤—洗脱—扩增"的多轮循环,从数十亿个克隆中富集出与靶标高亲和力结合的候选分子。这一过程被称作生物淘选(biopanning),是噬菌体展示技术的实验核心。
技术定位:噬菌体展示不是简单的"抗体筛选工具",而是一个完整的"基因型-表型关联筛选平台"。除了抗体发现,它还广泛应用于多肽药物筛选、蛋白相互作用映射、酶底物特异性分析以及表位定位等领域。理解其通用原理有助于在不同应用场景中灵活设计筛选策略。
在当前抗体药物研发管线中,噬菌体展示贡献了多个已上市治疗性抗体,包括阿达木单抗(Humira,全球首个全人源抗体药物)、贝利木单抗(Benlysta)和雷克珠单抗(Rayos)等。这些成功案例验证了噬菌体展示技术在治疗性抗体发现中的实战价值,也推动了该技术在工程化改进和自动化筛选方面的持续革新。
二、噬菌体展示肽库筛选的文库类型与构建策略
噬菌体展示文库的质量直接决定了筛选的成败。文库类型的选择和构建质量是整个项目的基石。
1、丝状噬菌体展示系统
噬菌体展示主要使用M13、fd和f1等丝状噬菌体,它们感染大肠杆菌但不裂解宿主菌。外源序列通过融合到pIII或pVIII外壳蛋白基因实现表面展示。pIII位于噬菌体末端,每个噬菌体约3-5个拷贝,适合展示大分子蛋白(如scFv、VHH);pVIII构成噬菌体侧壁,约2700个拷贝,适合展示小分子多肽,多拷贝展示可产生多价效应(avidity)提高低亲和力结合的筛选效率。
展示系统分为3型:3型(pIII融合,单价展示)、8型(pVIII融合,多价展示)和33型(杂合pIII系统,单价展示但不影响感染能力)。对于抗体片段筛选,3型或33型是标准选择,因为单价展示可以避免多价效应掩盖真实的亲和力差异。对于多肽筛选,8型或88型(杂合pVIII)可以利用多价效应富集低亲和力结合物。
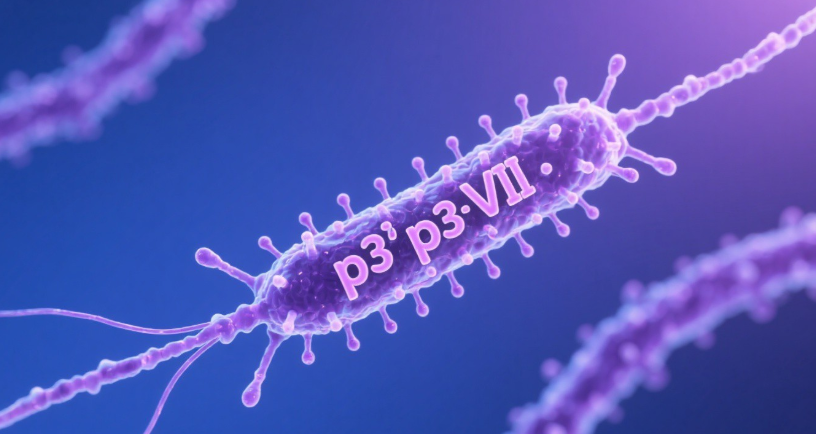
图1:噬菌体展示技术原理,丝状噬菌体外壳蛋白融合展示与基因型-表型关联系统
2、文库类型:天然文库 vs 免疫文库 vs 合成文库
三种文库各有优势和适用场景。天然文库(naive library)来源于未经免疫的健康人或动物的B淋巴细胞 repertoire,理论上覆盖所有可能的抗体序列,适合筛选任何靶标。优势在于不需要免疫动物,可以直接获得人源抗体;局限在于平均亲和力较低(通常Kd在10⁻⁶至10⁻⁷ M),需要后续亲和力成熟。代表性文库如Philippa Holliger实验室的McCafferty文库和Gregory Winter的Tomlinson文库。
免疫文库(immune library)来源于经特定抗原免疫的动物B淋巴细胞。由于经过体内亲和力成熟和克隆选择,免疫文库的平均亲和力较高(Kd通常在10⁻⁸至10⁻⁹ M),适合需要快速获得高亲和力抗体的项目。缺点是每种靶标需要单独构建文库,且人源免疫文库受伦理限制。驼源VHH免疫文库是目前应用最广泛的免疫文库类型。
合成文库(synthetic library)通过人工设计抗体可变区序列构建,可以在CDR区域引入随机化或半随机化序列。优势在于文库设计完全可控,可以优化密码子使用、避免已知缺陷序列、引入特定结构元素。缺点是需要丰富的抗体工程经验进行设计,且可能缺乏体内亲和力成熟筛选出的天然优化序列。代表性文库如MorphoSys的HuCAL系列。
| 特征 | 天然文库 | 免疫文库 | 合成文库 |
|---|---|---|---|
| 来源 | 未免疫B细胞 | 免疫后B细胞 | 人工设计序列 |
| 初始亲和力 | 低(μM) | 高(nM) | 中低(μM) |
| 靶标通用性 | 通用 | 特异于免疫抗原 | 通用 |
| 人源性 | 天然人源 | 取决于免疫动物 | 设计人源框架 |
| 所需周期 | 2-3周筛选 | 3-4月(含免疫) | 2-3周筛选 |
3、噬菌体文库库容设计的关键参数
库容(library size)是衡量文库质量的核心指标,指文库中独立克隆的数量。库容决定了文库覆盖的序列空间大小,理论上有10²⁰种可能的6肽序列,但任何实际文库的库容都远小于此。天然抗体文库的库容通常要求达到10⁹至10¹¹,scFv文库库容应至少达到10⁸,多肽文库库容10⁸即可。库容过低会导致序列多样性不足,筛选到的候选分子可能无法覆盖高亲和力克隆。
库容不仅取决于转化效率,还取决于构建方法。电穿孔大肠杆菌的转化效率通常为10⁹至10¹⁰ cfu/μg DNA,通过多次电穿孔可以累积到10¹¹的库容。构建过程中需要关注的一个关键指标是正确读框率(in-frame rate),如果连接效率低或载体自连率高,大量克隆可能不含插入片段或读框错误。通过在载体中引入琥珀终止密码子或使用SP6/T7选择性培养可以筛选正确读框的克隆。
质量控制:构建完成后,应当从文库中随机挑取50-100个克隆进行测序,评估插入率(应>90%)、读框正确率(应>80%)和序列多样性(应无明显优势克隆)。如果某一克隆占比超过5%,提示文库中存在扩增偏倚或构建瓶颈。
三、生物淘选biopanning的流程优化与参数调控
生物淘选是噬菌体展示技术的实验核心,其本质是亲和富集筛选。通过多轮的"结合—洗涤—洗脱—扩增"循环,从数十亿个克隆中逐步富集出与靶标特异性结合的噬菌体。
1、靶标固定策略与固相选择
靶标抗原的固定方式直接影响筛选效果。最传统的方法是将抗原直接包被在免疫管或96孔板上。这种固相固定操作简便,但存在几个问题:第一,抗原可能因吸附而变性,丧失天然构象;第二,筛选到的抗体可能优先识别吸附暴露的表位,而非溶液状态下的天然表位;第三,塑料吸附的抗原密度有限,可能不足以捕获低亲和力克隆。
替代方案包括:生物素化抗原结合链霉亲和素磁珠、His-tag抗原结合Ni-NTA磁珠、以及溶液相淘选(solution panning)。溶液相淘选将生物素化抗原与文库在溶液中孵育,然后通过链霉亲和素磁珠捕获结合的噬菌体。这种方法保持了抗原的天然构象,筛选到的抗体更可能在生理条件下有效。但溶液相淘选需要控制抗原浓度以实现亲和力选择,低浓度(1-10 nM)偏向筛选高亲和力克隆,高浓度(100-1000 nM)则保留更多中等亲和力克隆。
图2:生物淘选biopanning流程,结合、洗涤、洗脱与扩增的多轮循环富集策略
2、洗涤条件与富集效率的平衡
洗涤是淘选过程中区分特异性结合与非特异性结合的关键环节。洗涤强度过低会导致非特异性噬菌体残留,背景高;洗涤强度过高可能丢失低亲和力但有价值的克隆。标准方案通常在前两轮使用温和洗涤(PBS/TBS+0.1% Tween-20,3-5次,每次5分钟),后两轮逐渐加强(增加洗涤次数至10-15次,提高Tween-20浓度至0.5%,或引入额外的高盐洗涤)。
每轮淘选后需要计算回收率(output/input ratio),即洗脱噬菌体数与加入文库总数的比值。通常第一轮回收率为10⁻⁴至10⁻⁵,经过3-4轮后应升高至10⁻²至10⁻¹。如果回收率持续偏低(<10⁻⁵),可能提示抗原固定效率低、文库质量差或洗涤过于严苛。如果回收率过早升高(第二轮即达到10⁻²),可能提示存在非特异性富集(如塑料结合克隆扩增)。
常见陷阱:"塑料结合克隆"是淘选中最常见的失败模式。某些噬菌体克隆具有非特异性结合塑料表面的能力,在洗涤中因结合力强而存活,在扩增中因繁殖快而富集。判断方法:设置无抗原对照孔(仅包被BSA或明胶),如果该孔的回收率与抗原孔相当,则提示存在塑料结合克隆。解决方案是更换靶标固定方式或引入负筛选(depletion)步骤。
3、洗脱方法与洗脱效率
洗脱是将结合在靶标上的噬菌体回收用于下一轮扩增的关键步骤。常用方法包括低pH洗脱(0.1 M glycine-HCl, pH 2.2,室温5-10分钟)、胰蛋白酶洗脱(1mg/mL trypsin,室温15分钟)和竞争性洗脱(过量游离抗原或特异性多肽)。
低pH洗脱是最常用的方法,通过变性抗原-抗体结合释放噬菌体。优点是普适性强,可以洗脱几乎所有的结合物。缺点是可能破坏噬菌体感染能力(M13在极端pH下pIII可能变性)。洗脱后需要立即用Tris-HCl(pH 7.5-8.0)中和。胰蛋白酶洗脱通过切割融合蛋白中的蛋白酶敏感位点释放噬菌体,条件温和但需要靶标和融合蛋白之间的接头序列含有蛋白酶位点。竞争性洗脱是特异性最高的方法,仅洗脱识别特定表位的噬菌体,但需要大量纯化抗原。
4、扩增条件与文库多样性维护
洗脱后的噬菌体需要感染大肠杆菌进行扩增。标准操作是将洗脱液加入对数生长期(OD₆₀₀=0.4-0.5)的TG1或ER2738宿主菌中,37°C静止感染30分钟,然后涂布于含相应抗生素的2xYT或LB平板上。次日刮取所有克隆制备下一轮淘选用的噬菌体文库。
扩增过程中需要维护文库多样性。几个关键控制点:第一,感染时使用足够量的宿主菌(通常10倍于洗脱噬菌体数),确保每个噬菌体都有机会感染细菌;第二,平板刮取要彻底,不要遗漏任何区域;第三,扩增代数控制在1-2代,避免优势克隆过度扩增导致多样性丢失。培养时间通常控制在37°C过夜(约16小时),避免长时间培养导致噬菌体滴度下降和营养竞争偏差。
四、VHH纳米抗体发现的免疫文库构建
VHH(Variable Heavy chain of Heavy-chain antibody)纳米抗体因其在CAR-T、分子成像和口服给药方面的独特优势,已成为抗体药物开发的热点方向。噬菌体展示是VHH发现的核心技术路径。
1、驼源免疫与B细胞采集
VHH来源于骆驼科动物(骆驼、羊驼、大羊驼)天然产生的重链抗体(HCAb)。免疫文库构建的第一步是对驼源动物进行抗原免疫。通常使用6-8周龄的羊驼,采用4-5次免疫方案(间隔2周),末次免疫后7-10天采集外周血(100-200 mL),分离PBMC。
免疫方案设计需要考虑几个因素:佐剂选择(弗氏佐剂或新型水基佐剂如AddaVax)、免疫途径(皮下多点注射或肌肉注射)和抗原剂量(通常100-500μg/次)。免疫效果评估通过ELISA检测血清抗体效价,效价达到1:10000以上时方可进行文库构建。
图3:VHH纳米抗体发现流程,驼源免疫文库构建与噬菌体展示筛选路径
2、VHH文库构建的技术要点
从PBMC中提取总RNA,反转录为cDNA后,使用巢式PCR扩增VHH片段。第一轮PCR使用位于CH2域的引物和leader sequence引物,扩增整个重链基因(包括VHH-铰链-CH2-CH3);第二轮PCR使用位于铰链区的引物和FR1引物,特异性扩增VHH片段(约350-400 bp)。这一步的设计巧妙利用了HCAb铰链区与传统IgG铰链区的序列差异,实现了VHH与常规VH的分离。
扩增的VHH片段通过限制性内切酶克隆(常用SfiI或PstI/NcoI)或Gibson组装插入噬菌体展示载体。转化后通过电穿孔导入TG1宿主菌,计算库容并验证插入率。VHH免疫文库的库容通常要求达到10⁶至10⁸,低于scFv文库要求,因为免疫文库已经经过体内亲和力成熟,序列多样性不需要像天然文库那样高。
3、VHH筛选的特异性优化
VHH淘选的基本流程与scFv类似,但需要关注几个VHH特有的因素。第一,VHH的CDR3通常比VH更长且更灵活,可能形成额外的二硫键或凸环结构。筛选到的高亲和力VHH可能依赖于这些特殊结构,在表达纯化时需要注意氧化还原条件。第二,VHH分子量仅15 kDa,在ELISA检测中信号可能偏弱,建议使用抗His-tag或抗c-Myc tag的检测抗体进行信号放大。第三,VHH对热和变性条件的稳定性普遍优于scFv,可以利用热挑战筛选(heat challenge panning)富集高稳定性克隆。
五、scFv单链抗体文库的设计与库容要求
scFv(single-chain variable fragment)是将抗体重链可变区(VH)和轻链可变区(VL)通过柔性接头连接形成的单链抗体片段,是噬菌体展示文库中最常见的抗体格式。
1、scFv接头设计对展示效率的影响
scFv中连接VH和VL的接头序列对蛋白折叠、稳定性和展示效率有显著影响。最常用的接头是(Gly₄Ser)₃,长度15个氨基酸,提供足够的柔性使VH和VL正确配对。较短的接头可能导致VH和VL分子间配对形成二聚体(diabody),而较长的接头虽然更柔性但可能影响蛋白稳定性。
在文库设计中,VH和VL的排列顺序(VH-linker-VL vs. VL-linker-VH)会影响展示效率和亲和力。大多数文库采用VH-linker-VL排列,因为这一排列方式在噬菌体表面的展示效率通常更高。但也有研究表明,VL-linker-VH排列在某些靶标筛选中表现更好,具体取决于靶标表位和抗体序列特征。
2、scFv文库的库容与多样性要求
scFv文库的库容要求通常高于VHH文库,因为scFv的序列空间更大(VH和VL各有约10³⁰种可能序列)。天然scFv文库的库容要求达到10⁹以上,合成文库可达10¹⁰至10¹¹。库容不足不仅限制了高亲和力克隆的覆盖概率,还可能因为克隆偏倚导致筛选到的抗体集中于少数序列。
除了库容,序列多样性也是关键指标。多样性可以通过CDR3区域的序列长度分布和氨基酸组成来评估。理想的scFv文库应当展示出接近正态分布的CDR3长度分布(VH CDR3平均15±5氨基酸),氨基酸组成应反映天然免疫库的特征(富含Tyr、Ser、Gly等高接触频率残基)。
设计要点:scFv文库构建中最大的技术挑战是VH和VL的正确配对。在天然B细胞中,每个细胞只表达一个VH和一个VL,天然配对信息在提取RNA后丢失。解决方案包括:单细胞分选后分别扩增VH和VL再随机连接、使用linker连接PCR将VH和VL在同一反应中连接、或采用 overlapped extension PCR技术。
3、scFv稳定性与表达水平的优化
scFv的稳定性和表达水平是影响其实际应用的关键因素。许多scFv在大肠杆菌中表达时形成包涵体,需要复性才能获得功能蛋白。这既影响筛选效率(展示在噬菌体表面的scFv如果折叠不正确则无法结合抗原),也影响后续生产和应用。
稳定性优化策略包括:选择已知高稳定性的VH和VL框架序列作为模板(如DP-47 VH框架和DPL16 VL框架),在CDR以外的区域减少随机化,保留框架区的保守序列。此外,可以在筛选后通过定向进化引入二硫键(如VH44-VL100二硫键)提高scFv的热稳定性。
六、阳性克隆ELISA鉴定与亲和力评估
淘选3-5轮后,需要从富集文库中随机挑取单克隆进行ELISA鉴定,筛选出与靶标特异性结合的阳性克隆。这是从"文库"到"候选分子"的关键转化步骤。
1、单克隆ELISA鉴定的标准流程
从最后一轮淘选的输出平板上随机挑取48-96个单克隆,接种于96深孔板中培养并诱导表达scFv或VHH展示噬菌体。收集噬菌体上清进行ELISA检测:靶标抗原包被孔(阳性检测)和BSA包被孔(阴性对照)同时检测,计算特异性信号比值(S/N ratio)。
阳性判读标准通常设为S/N ≥ 3且绝对信号值超过空白对照的5倍以上。根据期望的阳性率,可能需要扩大筛选数量。如果阳性率低于5%,可能提示淘选效率不足;如果阳性率高于50%,可能提示文库多样性已显著降低(富集到了少数几个克隆)。
阳性克隆需要进一步进行DNA测序获得序列信息。序列分析应包括:VH和VL的germline来源(使用IMGT/V-QUEST或IgBLAST工具)、CDR序列分析、序列聚类去重(通常按100%氨基酸序列一致去重,但对于长CDR3也可以按90%相似度聚类)。
2、交叉反应性与特异性评估
初步鉴定的阳性克隆需要进行更全面的特异性评估。将每个克隆与一系列相关和无关靶标同时进行ELISA检测,包括:同家族蛋白(如筛选抗PD-1抗体时检测PD-L1、PD-L2、CTLA-4)、不同种属同源蛋白(人、猴、小鼠等)以及无关蛋白(BSA、卵清蛋白等)。理想的候选抗体应只与靶标和预期交叉反应的同源蛋白结合。
筛选策略:对于治疗性抗体开发项目,通常从ELISA阳性克隆中挑选20-50个序列独特的克隆进入下一轮评估(包括流式细胞术验证细胞结合、表面等离子体共振测定亲和力、以及细胞功能实验)。聚焦于序列多样性的克隆而非仅选信号最强的,因为序列多样性意味着可能识别不同表位,增加最终候选物的成功概率。
3、亲和力定量与比较分析
ELISA定性鉴定后的关键步骤是亲和力的定量测量。噬菌体展示筛选的抗体初始亲和力差异可能跨越2-3个数量级,准确的亲和力排序对于候选物选择至关重要。
表面等离子体共振(SPR,Biacore)和生物膜干涉(BLI,Octet)是亲和力定量的金标准方法。SPR通过在芯片表面固定抗原,检测溶液相抗体的结合和解离动力学,可以获得结合速率(ka)、解离速率(kd)和平衡解离常数(KD=kd/ka)。BLI使用光纤传感器进行类似测量,通量更高但灵敏度略低。
在候选物排序阶段,通常将KD在10 nM以下的克隆列为高优先级候选。但KD并非唯一考量,解离速率(kd,或停留时间residence time=1/kd)在某些治疗场景中更为关键。慢解离速率(kd < 10⁻⁴ s⁻¹,停留时间>2.8小时)的抗体在体内可能具有更长的靶标占据时间,产生更持久的药效。
图4:阳性克隆ELISA鉴定流程,单克隆筛选、特异性评估与DNA测序鉴定
七、体内体外淘选策略的比较与选择
噬菌体展示筛选策略不是一成不变的模板,需要根据靶标特性和研究目的进行定制化设计。体内体外淘选策略各有适用场景,理解它们的差异和互补性是设计高效筛选方案的前提。
1、体外淘选策略的变体与应用场景
标准体外淘选(solid phase panning)使用固定在固相表面的抗原。在此基础上发展出多种变体:溶液相淘选使用生物素化抗原在溶液中结合,再通过磁珠捕获,适合需要保留抗原天然构象的场景。细胞淘选(cell panning)直接使用表达靶标的完整细胞作为筛选源,适合筛选需要识别细胞表面天然构象表位的抗体(如GPCR、离子通道等膜蛋白)。
BRASIL技术(Biopanning and Rapid Analysis of Selective Interactive Ligands)是一种改良的细胞淘选策略。其核心创新是将结合步骤与分离步骤解耦:噬菌体与靶细胞在溶液中孵育后,将混合物加到含有机溶剂(如dinonyl phthalate)的离心管中,离心使结合噬菌体的细胞穿过有机相到达管底,未结合的游离噬菌体留在水相。这种方法避免了磁珠分离可能的非特异性吸附问题,分离效率更高。
负筛选策略(depletion/negative selection)在正筛选前先用非靶标细胞或分子预吸附文库,去除交叉反应克隆。例如,筛选肿瘤特异性抗体时,先用正常组织细胞预吸附文库,再与肿瘤细胞进行正筛选。负筛选可以有效提高特异性,但可能降低文库多样性,需要权衡使用。
2、体内淘选策略的特殊价值
体内淘选(in vivo panning)是将噬菌体文库直接注射到动物体内,利用体内组织分布的自然选择压力筛选组织特异性配体。这种方法可以筛选出在体内条件下具有组织靶向能力的多肽或抗体片段,特别适用于药物递送系统配体的发现。
典型流程:将文库经尾静脉注射到小鼠体内,5-30分钟后灌注冲洗去除血液中未结合的噬菌体,解剖目标器官(如脑、肿瘤、肝等),匀浆后提取组织结合的噬菌体,感染大肠杆菌扩增后进行下一轮。通常需要3-5轮体内淘选才能获得明显的组织富集。
体内淘选的核心优势是筛选到的配体已经过生理条件的自然筛选,具有体内适用性。但其局限也很明显:筛选过程难以控制、重复性差、每次筛选只针对一个器官、且涉及动物实验伦理审批。因此,体内淘选通常作为体外淘选的补充而非替代,先用体外淘选获得候选克隆,再通过体内淘选验证或优化其组织靶向能力。
3、淘选策略的组合设计
在实际项目中,多种淘选策略的组合使用往往比单一策略更有效。一个典型的组合方案是:第一轮使用固相淘选初步富集靶标结合物→第二轮使用细胞淘选验证天然构象识别→第三轮使用溶液相淘选进行亲和力选择→第四轮引入负筛选去除交叉反应克隆。这种渐进式策略可以在不同维度上施加选择压力,提高筛选效率和候选物质量。
策略选择原则:淘选策略的选择应基于靶标的生物学特性和最终应用场景。如果靶标是可溶性蛋白且需要高亲和力,固相或溶液相淘选即可。如果靶标是膜蛋白且需要识别天然构象表位,细胞淘选不可替代。如果需要组织靶向能力,体内淘选是唯一选择。如果靶标在多种同源蛋白间需要精确区分,负筛选是必要的。
4、淘选后的工程化改进
淘选获得的候选抗体通常需要进一步工程化改进。亲和力成熟(affinity maturation)通过在CDR区域引入随机突变(通常使用NNK或NNS简并密码子),构建二次文库并使用更严苛的条件(如降低抗原浓度至1 nM以下)进行再淘选,可以将亲和力提高10-100倍。人源化改造将非人源框架序列替换为人源框架,保留CDR功能序列,降低免疫原性。Fc工程改造可以调节效应功能(ADCC、CDC)、半衰期和组织穿透能力。
这些工程化步骤与噬菌体展示筛选形成了一个完整的抗体发现-优化闭环。噬菌体展示提供的不仅是最终的候选序列,更是一个可以持续迭代的筛选平台,通过修改文库设计、调整淘选策略和引入新的选择压力,可以不断获得满足特定需求的优化分子。
从产业发展趋势看,噬菌体展示技术正在向更高通量、更自动化和更智能化的方向演进。机器人自动化淘选工作站可以实现24小时无人值守的多轮淘选,新一代测序(NGS)技术可以在淘选全程追踪克隆丰度变化,AI辅助的文库设计算法可以预测和优化文库的序列空间覆盖。这些技术进步正在缩短抗体发现的周期,提高筛选效率,同时也对研究者提出了更高的跨学科能力要求,理解噬菌体展示的生物学原理、掌握淘选策略的设计逻辑、运用生物信息学工具分析测序数据,这些都是现代抗体发现项目中不可或缺的能力要素。
 X