分子检测方法选型矩阵与定量体系
一、方法选型的量化矩阵:四维打分
分子检测的方法选型不该凭习惯或设备清单决定,而应按四个维度量化打分:灵敏度下限、定量性质(相对/绝对)、通量需求、单样本边际成本。把这四个维度分别评分,再叠加场景约束(现场 vs 实验室、定性 vs 定量、单指标 vs 多指标),多数选型问题可以收敛到 1–2 个候选方案。
荧光定量PCR 是绝大多数定量场景的默认选择:成熟、仪器普及、试剂成本可控、半定量结果稳定。数字PCR 的独特价值在绝对定量,不需要标准曲线,直接通过分区计数换算拷贝数,在低丰度突变检测、拷贝数变异、病毒载量精确定量上不可替代,代价是设备与耗材成本高、通量低。等温扩增技术的价值在现场与基层:无需热循环仪,用恒温水浴或简易加热模块即可完成,检测时间短,但定量能力弱、引物设计复杂度高。
qPCR半定量,灵敏度好,通量高,试剂成熟;标准曲线法依赖参考物质,批间漂移需要用内参校正。适合基因表达定量、病原载量监测。
数字PCR绝对定量,不依赖标准曲线;稀有序列与低拷贝样本优势突出;分区数决定动态范围。适合稀有突变、拷贝数变异、残留宿主 DNA。
等温扩增无需热循环,现场可用,时间短;引物设计复杂,易非特异;定量能力弱。适合基层筛查、床旁检测、现场快检。
高通量测序可发现未知变异,通量最高;周期与成本高,数据分析门槛高。适合未知病原、肿瘤 panel、脱靶谱分析。
三代 PCR 技术并非替代关系,而是互补关系。常规 PCR 适合定性初筛,qPCR 适合常规定量,dPCR 适合极端定量需求。把三代技术放在同一条工作流里按用途分工,比试图用单一平台覆盖所有需求更务实。
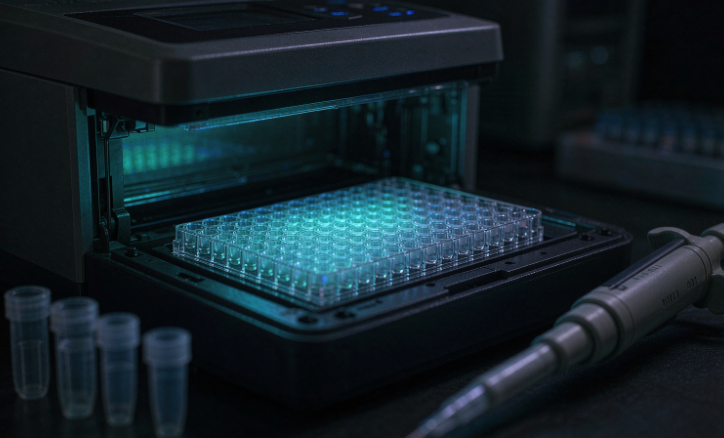
图1:qPCR 的信号质量取决于引物探针设计与扩增效率,仪器本身只是读出端
二、荧光定量PCR:把 Cq 值变成可信数字
荧光定量PCR 的输出是一个 Cq 值,但 Cq 值本身没有意义,只有经过扩增效率校正、参比基因归一化和重复性验证后,才能变成可信的定量结论。这三个环节是最常被跳过、也是最容易出问题的。
扩增效率必须实测
理想的扩增效率在 90–110% 之间,对应标准曲线斜率 -3.1 至 -3.6,R² 应高于 0.99。效率偏低常意味着引物二聚体、二级结构或反应体系抑制;效率偏高(>110%)则往往提示非特异扩增或引物二聚体主导。每次更换试剂批次、仪器或样本基质,都应重新做标准曲线,不能沿用历史数据。
参比基因不是随便选
相对定量的可信度完全取决于参比基因的稳定性。常用参比基因(GAPDH、ACTB、18S rRNA)在不同组织、不同处理条件下表达波动可能达到数倍。正确做法是用 GeNorm、NormFinder 等工具在目标样本集中实测候选参比基因的稳定性值,选择 2–3 个稳定基因做几何平均归一化,而不是依赖文献推荐。
Cq 值的解读边界
Cq 大于 35 的数据通常进入定量可信区间边缘,重复性差、易受背景荧光影响;Cq 大于 40 基本等同于未检出。此时应报告"低于定量下限"而不是硬给一个数值。另一个常被忽视的问题是抑制剂:血液、粪便、土壤等复杂基质中的抑制物会造成 Cq 偏移,用内扩增产物质控或稀释曲线可以诊断抑制问题。
融解曲线不是走形式使用染料法时,融解曲线必须与预期单峰一致,出现主峰偏移或杂峰都意味着扩增产物不单一。探针法虽然不依赖融解曲线,但也应通过凝胶电泳或产物测序抽检确认产物正确,探针的特异性不等于引物的特异性。
三、数字PCR:绝对定量的工程实践
数字PCR 的核心动作是把反应体系分成成千上万个独立分区,每个分区要么有目标分子(阳性)要么没有(阴性),按泊松分布换算原始拷贝数。这套逻辑带来三个独特优势:不需要标准曲线、对抑制剂鲁棒性更强、在低丰度目标上的灵敏度显著优于 qPCR。
分区数决定动态范围与分辨率。微滴式 dPCR 单反应约 2 万个分区,芯片式可达数十万。分区越多,能准确定量的拷贝数范围越宽,对稀有序列的检出概率也越高。但分区数不是唯一变量,分区体积的均一性、阳性判读阈值设定、死体积与蒸发损失,都会影响最终数字的准确性。
稀有序列突变检测的实操
稀有序列检测(如肿瘤液体活检、残留病灶监测)的关键在于背景噪音控制。野生型等位基因的扩增会淹没稀有突变信号,因此通常用突变特异性探针 + 野生型阻断(blocking oligo 或 LNA 修饰)来压制背景。检测下限受三个因素共同约束:总反应分区数、突变野生比、背景错误率。设计实验时应先估算这三项,再反推所需反应数。
什么时候选 dPCR三个典型信号提示该用 dPCR:需要绝对拷贝数而不想依赖标准曲线;样本中目标丰度极低(<1%)且需要可重复的定量;需要在不同实验室间建立可比对的标准。反过来,如果只是常规表达量比较或高通量筛查,qPCR 依然是性价比更高的选择。
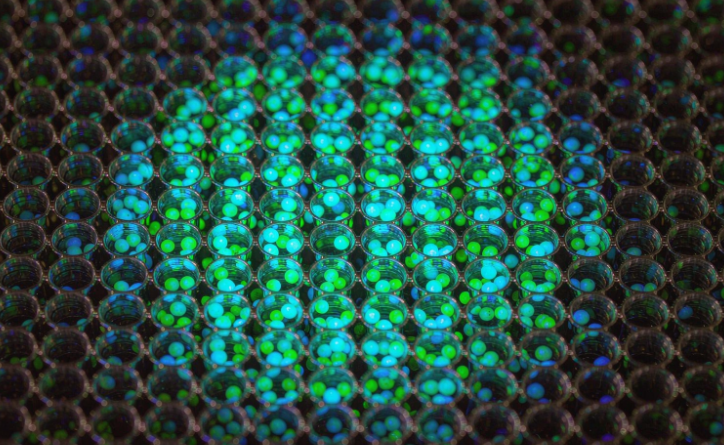
图2:数字PCR 把反应拆分成数万个微滴,每个微滴都是一次独立判读,靠计数而非荧光强度定量
四、等温扩增技术:现场部署的工程问题
等温扩增技术的价值在于把设备门槛降到最低,一个恒温水浴或简易加热模块就能完成扩增。LAMP、RPA、RCA、NASBA 各有温度区间与适用场景,但共同的问题是引物设计复杂度高与非特异扩增风险。
LAMP 的引物套组逻辑
LAMP 需要 4–6 条引物识别靶序列上 6–8 个区域,这既是它高特异性的来源,也是设计难度的根源。引物之间的 Tm 匹配、二级结构与相互作用的排查比 PCR 严格得多,通常需要专门的软件与多轮筛选。引物设计不当的典型表现为:阴性对照出现扩增、扩增曲线延迟或无法区分梯度稀释,这些都指向引物问题而非试剂问题。
假阳性的三种来源与控制
等温扩增的假阳性控制是现场应用的核心问题。来源一:气溶胶污染,LAMP 产物量大,开盖即扩散,必须使用闭管检测(如 pH 指示剂、荧光读出)或 dUTP-UNG 防污染体系。来源二:非特异扩增,引物与基因组其他区域误配,可通过缩短反应时间、降低镁离子浓度、增加探针特异性判读来缓解。来源三:样品基质干扰,复杂样本中的抑制物或背景荧光影响读出,需要前处理或内参监控。
RPA 在低温(37–42 ℃)运行,对设备要求更低,适合与便携式荧光计或侧向流动试纸联用。其短板是引物长度较长(30–35 nt)、设计经验依赖度高,且重组酶活性批次差异明显,需要每一批做性能确认。
五、探针化学:从 TaqMan 到分子信标
探针是特异性的最终把关者。TaqMan 探针依靠 5′ 核酸酶活性释放荧光,设计相对宽容、使用最广;分子信标探针采用茎环结构,只有与目标完全互补时才张开释放荧光,错配辨识度显著高于线性探针,特别适合 SNP 分型与等位基因鉴别。
分子信标的设计要点:茎区 5–7 bp,GC 含量适中;环区与目标完全互补,长度 15–25 nt;茎环的 Tm 应高于退火温度 7–10 ℃,确保游离状态下保持闭合。设计失误的典型表现为本底荧光过高(茎区不稳定提前张开)或信号增幅不足(环区 Tm 过低未杂交)。
增强探针特异性的进阶手段包括 MGB(小沟结合)修饰与 LNA(锁核酸)修饰。MGB 探针能在较短序列上维持高 Tm,适合 AT 富集区;LNA 修饰则在突变位点附近引入,可放大单碱基差异带来的 Tm 变化。这两种手段在稀有突变检测、耐药位点分型上几乎是标配。
六、CRISPR核酸检测:等温扩增 + 可编程切割
CRISPR核酸检测把 Cas12/Cas13 的可编程识别能力与等温扩增的灵敏度结合起来,形成"扩增—识别—读出"三段式工作流。Cas12a 在识别靶 DNA 后激活反式切割活性,切割体系中的非特异单链荧光报告探针;Cas13 识别靶 RNA 后切割 RNA 报告探针。这种"一激活多切割"的机制提供了内置信号放大,理论上单分子识别即可触发大量报告分子切割。
实际灵敏度取决于三个环节的协同:前扩增(通常用 RPA 或 LAMP 把目标放大到可检测水平)、Cas 反应的识别效率、以及读出方式的信噪比。读出方式从荧光计、试纸条到便携式电化学传感器各有取舍,现场应用倾向于试纸条或目视读出,实验室应用则偏好荧光定量读出以便获得 Ct 类似的半定量信息。
该平台的核心挑战在于把三个反应整合到一管而不相互抑制。开放式一管反应面临扩增酶与 Cas 酶的最佳温度、缓冲液、离子条件不匹配的问题;两步法(先扩增后开管加 Cas)虽然增加操作步骤,但避免了酶间干扰,是目前多数成熟方案的实际选择。防气溶胶设计是两步法的必答题,开管瞬间就是污染风险最高的时刻。
识别特异性与脱靶切割Cas12/Cas13 对错配的容忍度随错配位置而变化,PAM/distal 区的错配通常被容忍,seed 区错配则严格排除。设计 crRNA 时应把 SNP 或目标变异放在 seed 区,否则区分度不足。此外,样本中高丰度近缘序列可能引发非特异激活,必要时应做错配耐受性实验验证区分能力。
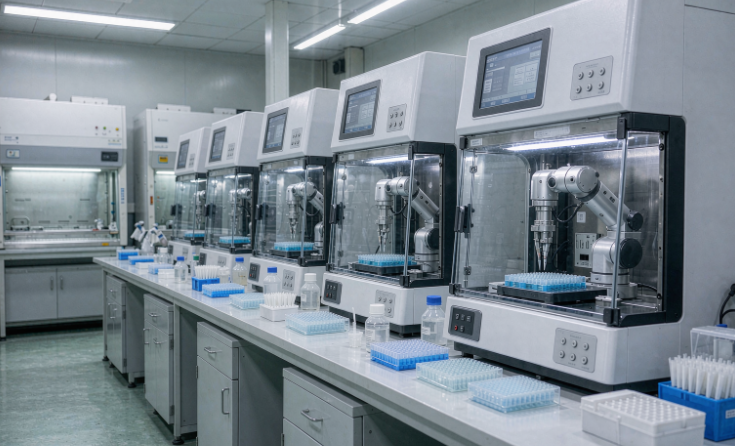
图3:高通量分子检测把核酸提取、扩增与读出整合为流水线,但方法学验证仍是质量根基
七、多重PCR检测与高通量测序检测
多重PCR检测在单反应中同时扩增多个目标,价值在于通量与样本经济性,尤其在样本量有限或多指标联合筛查场景。它的核心难题是引物池的相互作用与扩增偏倚:引物对之间的二聚体、不同目标的扩增效率差异、以及高丰度目标对低丰度目标的竞争抑制。
设计阶段的要点是:引物池整体做相互作用预测(不只是两两配对,而是池级别的能量矩阵);不同目标的引物 Tm 尽量集中;扩增长度差异控制在 100 bp 以内,减少效率差异。验证阶段需要用已知混合比例的模板确认各目标的相对回收率,必要时调整引物浓度做平衡。多重反应的"搭起来"和"用好"之间隔着大量的平衡工作。
从多重 PCR 到靶向测序
多重PCR与高通量测序检测的结合(amplicon-seq / targeted panel)把多重的价值进一步放大:同一个样本在一次测序运行中覆盖数十到数千个位点。但扩增子测序引入了新的问题,扩增偏倚会歪曲原始丰度信息,PCR 重复会压缩多样性。解决办法是在建库阶段加入分子标签(UMI),通过 UMI 共识序列去重,把 PCR 错误与重复reads剔除,恢复真实的分子计数。
从多重 PCR 到靶向测序的过渡还需要解决一个工程问题:引物池的迭代平衡。一个数十对引物的池子,几乎不可能一次设计就达到所有目标的均衡扩增。标准做法是分轮迭代,第一版跑已知混合模板,量化每个目标的相对回收率,把回收率偏低的目标提高引物浓度或重新设计,回收率偏高的下调,二到三轮迭代后多数池子可以达到十倍以内的均衡度。这个过程繁琐但不可省略,跳过平衡的引物池在真实样本上的表现往往与预期相差甚远。
测序数据的分析端同样需要质量把关。扩增子测序的常见问题包括:引物序列残留(必须在分析前切除)、嵌合体读段(尤其在 PCR 循环数偏高的反应中累积)、以及低深度位点的不确定判读。用嵌合体检测工具过滤、用固定深度阈值做判读边界、对临界样本做重复确认,这三条是扩增子测序分析的基础配置。分析流程一旦确定就不应随意改动参数,方法变更后的数据与历史数据不再可比,纵向监测项目尤其要注意这一点。
八、基因编辑脱靶检测:把"大概率没事"变成"可量化没事"
基因编辑脱靶检测的目的是把编辑特异性从"计算机预测没问题"升级为"实验测得没有可检出脱靶"。这是一条完整的证据链,而不是一个单一实验。
计算机预测工具(CRISPOR、Cas-OFFinder、CHOPCHOP)提供候选脱靶位点清单,但预测特异性有限,只能作为实验设计的起点。实验方法分为无偏与靶向两类。无偏方法如 GUIDE-seq(在细胞内捕获实际脱靶双链断裂)、DISCOVER-seq、CHANGE-seq(体外基因组切割后测序)能发现预测未覆盖的位点,但各有适用条件与灵敏度边界。靶向方法如扩增子深度测序,针对候选脱靶位点逐一量化编辑频率,灵敏度高但覆盖有限。
全基因组测序(WGS)作为整体评估手段,能发现大片段重排与染色体结构异常,但受限于测序深度,每个位点 30× 深度对 1% 以下低频脱靶的检出能力有限。对于需要高置信度的项目(细胞治疗、临床前模型),推荐"无偏方法发现候选位点 + 扩增子深度测序精确量化 + WGS 整体排查"的三层组合,而不是依赖单一方法。
脱靶评估的报告边界脱靶检测报告应明确三件事:检测方法的灵敏度下限(能检出多低的编辑频率)、覆盖范围(哪些位点被检测、哪些未被检测)、以及检测所针对的细胞类型与培养条件。不同细胞系、不同代次的脱靶谱可能不同,把一个条件下的结果外推到另一个条件,是没有证据支持的。
九、方法学性能验证:把"能用"变成"可报告"
一个检测方法在自家实验室跑通了,与它"可以出报告"之间隔着完整的性能验证。这段距离是很多实验室欠下的技术债,也是检测结果被质疑时的第一道裂缝。
性能验证的核心指标有六项。准确度通过与参考方法或参考物质比对评估,理想情况是有标准物质可用,否则用方法学比对替代。精密度分批内与批间两个层次,批内精密度用同一样本多次重复评估,批间精密度需要跨日、跨操作者、跨试剂批次的组合实验。线性范围决定可报告区间,用梯度稀释的标准品确认实测值与预期值的线性关系,线性范围之外的结果必须稀释或浓缩后重测,不能直接报告。检出限与定量限是两个不同的概念,检出限是"能判断有无"的最低浓度,定量限是"能给出可信数值"的最低浓度,把检出限当定量限报告是常见的合规性问题。特异性用近缘序列与干扰样本验证交叉反应。稳健性评估小的参数波动(退火温度偏移 1 ℃、反应体积偏差 5%)对结果的影响,稳健性差的体系在常规操作中难以保持性能。
验证方案的设计要点是覆盖真实使用场景。用纯化的标准品做验证得到的是"仪器方法学性能",而真实样本中有基质效应、抑制剂、竞争性背景。验证集应包含不同基质、不同浓度水平、含干扰物质的样本,且验证样本的基质应与未来日常检测的样本类型一致。在缓冲液中做得很漂亮的验证,搬到复杂基质上可能完全失效。
验证完成后还有一件事:建立持续的性能监控。每批检测带内部质控(阳性、阴性、临界值样本),用 Levey-Jennings 图追踪质控值的漂移趋势,设定警告与失控规则。性能验证证明的是"方法在验证当天是好的",持续监控证明的是"方法一直保持是好的",两者缺一不可。
十、复杂样本基质:前处理与抑制物控制
核酸检测在纯模板上表现良好,一进入真实样本就开始打折扣,问题的根源大多在样本基质。血液中的血红素与免疫球蛋白、粪便中的胆盐与多糖、土壤中的腐殖酸、植物组织中的多酚与多糖,都是已知的 PCR 抑制剂。抑制物控制能力是前处理工艺的核心竞争力,也是不同检测方案性能差异的主要来源。
核酸提取环节有三类控制策略。物理化学策略依靠硅胶膜或磁珠的特异性吸附,配合充分的洗涤步骤去除抑制物,是主流方案;洗涤不充分是抑制物残留的最常见原因,尤其是样本量加大后,洗涤体积与次数没有相应放大。化学中和策略在提取缓冲液中加入抑制物螯合或吸附成分,如 BSA 能部分中和血液来源的抑制物,PVP 能结合多酚类物质。稀释策略最简单也最有效,把模板稀释几倍常能让抑制效果消失,代价是目标分子同步稀释,在目标丰度充足时是首选诊断手段。
抑制问题本身的诊断有一套标准做法。外源内标(exogenous internal control)是首选工具:在提取前向每个样本加入已知量的外源核酸,提取后检测其 Ct 值,若 Ct 显著偏移,说明提取环节存在抑制或损失。内标 Ct 正常而目标 Ct 偏移,则提示目标特异性问题而非抑制。另一类诊断是稀释曲线:把样本模板做梯度稀释,若 Ct 偏移量不符合理论稀释关系(每 10 倍稀释 Ct 增加 3.3),就存在抑制剂或竞争性扩增。
前处理工艺的另一个隐性问题是核酸降解。RNA 检测对 RNase 污染极其敏感,样本采集后的保存温度与时间直接影响目标完整性。用 DNase 处理 RNA 样本、用 RNase 抑制剂保护提取产物、采集后尽快冷藏或加入稳定液,这三条是 RNA 检测流程的底线配置。DNA 检测相对耐受,但长时间高温保存仍会导致片段化,影响长片段扩增的效率。
提取效率的批间漂移磁珠法提取的效率受磁珠批次、结合缓冲液批次、磁力架型号与操作节奏影响,批间漂移可达数倍。用统一的外源内标 + 批内校准样本,可以把这种漂移从"不可解释的结果差异"变成"可监控的工艺参数"。漂移一旦超出受控范围,应停批排查而不是照常出结果。
 X