酵母单杂交:蛋白—DNA 互作筛选
一、Y1H 在调控研究链条中的定位
酵母单杂交技术解决的是一个方向性问题:已知 DNA 序列,寻找能结合它的蛋白。这与 ChIP-qPCR、EMSA、荧光素酶报告等方法的指向正好相反,那些方法回答"这个蛋白结合哪些 DNA",Y1H 回答"这段 DNA 被哪些蛋白结合"。方向不同,适用阶段也不同。
在典型的调控研究链条里,Y1H 位于"从零到一"的发现阶段:研究一个新基因,启动子序列已知,但上游调控因子完全未知。此时 ChIP 无从设计(没有候选抗体),EMSA 无从设计(没有候选蛋白),只有 Y1H 可以用文库无偏筛选。发现的候选因子再进入下游验证环节:双荧光素酶确认功能性调控,EMSA 或 ChIP-qPCR 确认体内结合,突变体分析确认结合位点。
理解这个定位能避免两类常见误用。第一类是把 Y1H 当作最终证据,它给出的是体内酵母环境中的物理结合候选,不等于在目标物种中具有调控功能,必须经下游验证。第二类是在已有强候选时仍坚持全库筛选,此时直接做点对点 Y1H 验证或双荧光素酶更高效,全库筛选的价值在于发现"意料之外"的调控因子,而不是确认"意料之中"的假设。
调控研究的完整链条:启动子序列→Y1H 文库筛选→候选转录因子→点对点 Y1H 复验→双荧光素酶验证→EMSA / ChIP-qPCR 确认→突变体功能分析
二、诱饵设计:从启动子到诱饵菌株
诱饵(bait)是把目标 DNA 序列整合到酵母报告株基因组上的构建物。诱饵设计直接决定了后续筛选的特异性与假阴性风险,是整个项目里最值得花时间的环节。
长度的权衡
启动子片段长度是第一个决策点。全长启动子(500–1000 bp 以上)保留了完整的调控上下文,能捕获需要协同结合或远距离作用的因子,但长片段整合效率低、重复序列可能引发重组、自激活背景高。核心元件或 motif(几十到一二百 bp)易于操作、背景可控、便于后续突变分析,但可能错过依赖上下文的协同结合。工程上更常用的做法是多诱饵并行:把启动子切成 2–4 段分别构建诱饵,既保留上下文信息,又能把阳性信号定位到具体区段。
拷贝数与整合位置
诱饵通常以多拷贝串联整合到酵母基因组的安全 harbor 位点,多拷贝提高了信号强度,但也可能引入重复序列介导的重组。整合必须单一位点、确定拷贝数,用整合后 PCR 与测序确认,不要依赖转化后直接筛选。拷贝数不同的诱饵株之间不可直接比较信号强度,这是后续数据分析的隐性陷阱。
报告基因的组合
主流体系使用双报告基因(如 HIS3 + lacZ,或 HIS3 + AUR1-C):营养标记用于筛选,显色或荧光报告用于二次确认与定量。双报告的价值在于交叉验证,单一报告基因的假阳性率明显高于双报告一致阳性的克隆。诱饵应置于最小启动子(minimal promoter)上游,报告基因在下游,任何能结合诱饵并携带激活结构域的猎物蛋白都能激活报告。
重复序列的隐性风险启动子中的串联重复、转座子残留区域在酵母中可能发生重组,导致诱饵丢失或重排。构建后务必用 PCR 跨越长片段确认结构完整,筛选过程中若出现"信号逐渐减弱"的现象,也应优先怀疑诱饵结构变化而非生物学原因。
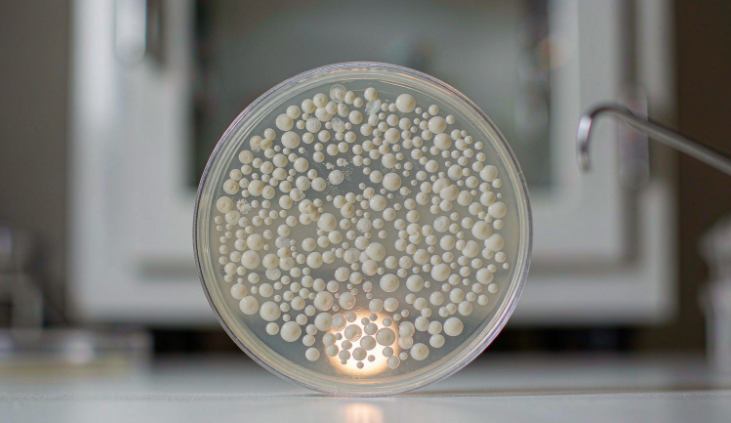
图1:酵母单杂交的筛选输出就是一皿菌落:每个阳性克隆背后都是一个待验证的蛋白—DNA 互作候选
三、自激活检测:筛选之前必须压制的背景
自激活检测是 Y1H 流程中最容易被低估的环节。诱饵序列本身可能被酵母内源转录因子识别并结合,从而在没有外源猎物的情况下激活报告基因,这就是自激活。如果不在筛选前测定并压制自激活背景,筛选结果会被大量"酵母内源因子驱动"的假阳性淹没。
3-AT 梯度压制
HIS3 报告体系的标准压制手段是 3-氨基三唑(3-AT),一种 HIS3 酶的竞争性抑制剂。操作是:将诱饵株在含 0、1、5、10、20、30、50 mM 3-AT 的缺陷培养基上点板,找到能完全抑制本底生长的最低 3-AT 浓度,这个浓度就是后续文库筛选的工作浓度。每个诱饵株的 3-AT 阈值不同,必须逐个测定,不能套用经验值。
自激活过强的处理路径
若 50 mM 以上 3-AT 仍无法压制,说明诱饵自激活过强,需要换策略而不是硬筛。可选路径包括:缩短诱饵片段,去除负责自激活的区段;换用另一套报告体系(如 lacZ 或 AUR1-C,敏感性不同);改用诱导型或弱化型最小启动子降低本底;或者在诱饵中引入点突变破坏内源因子结合位点(前提是这些位点不是你研究的目标)。每条路径都有取舍,但都比在无法压制的背景上硬筛有效。
选择压力的另一面3-AT 浓度不是越高越好。过高的选择压力会把真阳性也压制掉,弱结合的猎物蛋白产生的信号可能不足以在高浓度 3-AT 下存活。实际工作浓度通常取"完全压制本底的最低浓度再降一档",在背景压制与弱信号保留之间取平衡。这个平衡点的确定需要用已知阳性对照(若有)来校验。
四、Y1H文库筛选:从转化到覆盖度
Y1H文库筛选的工程核心是转化效率与文库覆盖度。猎物文库是 cDNA 与激活结构域(AD)的融合表达库,每个克隆对应一种候选蛋白。筛选能否发现目标因子,取决于两件事:文库中是否包含目标因子的编码序列,以及筛选是否覆盖了足够多的独立克隆。
文库来源的隐性约束
cDNA 文库来自特定组织、特定发育阶段或特定处理条件。转录因子表达往往有强烈的时空特异性,在叶片中高表达的因子不会出现在根的文库里。因此文库来源必须与研究问题匹配:研究逆境响应就选逆境处理的样本建库,研究发育调控就选对应发育阶段的样本。用错来源的文库,筛选做得再彻底也是零。
另一个常被忽视的约束是低丰度转录因子的代表性。文库中克隆的丰度反映原始 mRNA 丰度,而许多转录因子表达量极低,在未充分深度测序的文库中可能只有几个甚至零个克隆。文库质量评估应关注独立克隆数、平均插入片段长度、以及是否对转录因子编码序列有富集(有些方案用 DNA 结合结构域数据库做针对性富集)。
筛选的覆盖度计算
筛选至少应覆盖文库独立克隆数的 3–5 倍,即文库若含 10⁶ 个独立克隆,应筛 3–5 × 10⁶ 个转化子。这个数字决定了转化的规模,不是"转一板看看"的量级,而是需要多次大规模转化累积。覆盖不足时,筛到的往往是高表达、高丰度的"常见面孔",真正的调控因子被遗漏。这也是为什么很多 Y1H 项目筛到的候选高度重复,不是技术问题,是覆盖度问题。
五、阳性克隆验证:把候选变成证据
初筛得到的阳性克隆必须经过系统验证才能进入候选名单。这个环节的目标是把三类假阳性,酵母内源自激活、AD 融合蛋白的非特异结合、重复测序带来的冗余,全部清除。
第一轮验证是回转验证:把猎物质粒从阳性酵母中提取出来,重新转化到新鲜的诱饵株中,再次在选择性培养基上检测是否仍能激活报告。这一步清除的是转化过程中引入的无关突变或背景克隆。第二轮是点对点复验:把猎物克隆与诱饵重新配对,用双报告(显色 + 生长)双指标确认,排除单一报告的假信号。第三轮是测序与冗余去除:对通过复验的克隆测序,注释蛋白身份,去除重复序列与明显不合理的候选(如高度丰富的持家蛋白)。
验证阶段还有一个常被省略但极有价值的设计:用突变诱饵做特异性对照。把诱饵中的核心 motif 或预测结合位点做点突变,构建平行诱饵株,把阳性猎物分别转到野生型与突变型诱饵株上。若猎物只在野生型上激活报告,说明结合依赖该位点,证据等级显著提升;若两者都能激活,提示结合发生在其他位点,或结合是非特异的。
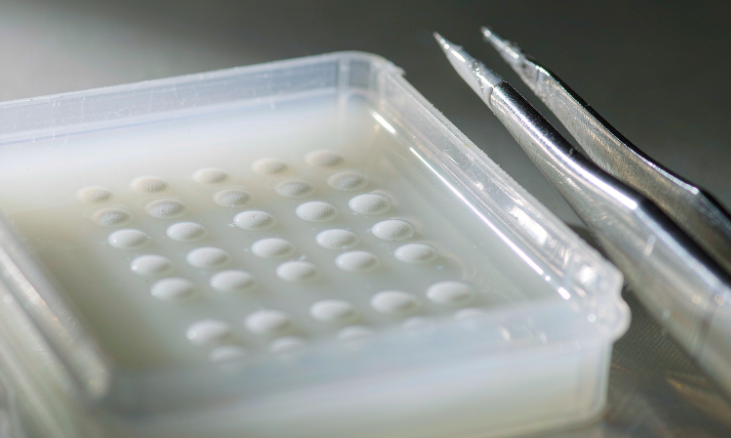
图2:选择培养基上的点板格局是 Y1H 的核心读出:生长与否、菌斑大小与显色强度共同构成信号判读依据
六、酵母双杂交与 Y1H 的协同
酵母双杂交(Y2H)与酵母单杂交共享同一套报告体系逻辑,但回答的问题不同:Y2H 检测蛋白—蛋白互作(PPI),Y1H 检测蛋白—DNA 互作(PDI)。在调控网络研究中,两者往往需要成对使用,形成"因子—因子"与"因子—DNA"两条正交的证据线。
典型协同场景一:从 Y1H 候选到调控复合物。Y1H 筛到的转录因子可能不是单独起作用,而是与共调节因子形成复合物。此时用 Y2H 验证该因子与其他调控蛋白的互作,可以揭示复合物层面的调控逻辑。场景二:从 Y2H 到 Y1H。Y2H 筛到的互作蛋白若含 DNA 结合结构域,提示它可能直接结合靶基因启动子,此时用 Y1H 检测它与启动子片段的直接结合,可以判断它是直接调控因子还是通过蛋白互作参与调控。
两个体系的局限性也需要同时记住。Y2H 的假阳性来自自激活与非特异粘性蛋白,假阴性来自需要翻译后修饰或膜环境才能形成的互作。Y1H 的假阳性来自诱饵自激活,假阴性来自需要特定辅因子或染色质环境才能结合的因子。两套体系的局限不同,交叉验证的价值正是在于局限不重叠,一个候选在两个体系中都成立,可信度远高于单一体系。
七、顺式作用元件鉴定与启动子互作分析
顺式作用元件鉴定是 Y1H 输出的下游延伸:把筛选到的候选因子与启动子上的具体结合位点对应起来,构建"因子—位点"的调控图谱。这一步把"某个蛋白能结合这段启动子"细化为"某个蛋白通过某个 motif 调控这个基因"。
从区段到 motif
若诱饵设计时采用了多段并行策略,阳性信号已经能定位到某个区段。下一步是在该区段内用生物信息学工具(如 MEME、JASPAR、PlantCARE)预测候选因子的结合 motif,然后做逐 motif 的点突变验证:把每个候选 motif 单独突变,构建系列诱饵变体,检测候选因子对突变体的结合是否丧失。motif 突变导致结合丧失,是该位点介导互作的直接证据。
启动子互作分析的系统化
启动子互作分析(promoter interaction analysis)常需要系统化的缺失与突变组合。缺失分析(5′ 逐步截短)能定位响应区域的大致范围;motif 突变能定位精确位点;两者结合可以绘制"启动子—因子"互作图谱。当多个因子结合同一启动子时,还需要检测位点间的协同或竞争,两个相邻位点的联合突变效应若大于单独突变之和,提示协同结合。
这里有一个容易被忽略的细节:突变 motif 时要区分"破坏结合"与"创造新结合"。点突变可能意外创造一个新的转录因子结合位点,导致解读混乱。设计突变时应尽量选择保守替换,并同步用 motif 预测工具检查突变后是否引入了新位点。
植物研究中的特殊考量植物启动子常含大量重复与转座子衍生序列,诱饵设计时要特别留意重复区域的组装稳定性。此外,植物转录因子家族(如 MYB、NAC、WRKY、bZIP)的结合 motif 已有较好的数据库积累,motif 预测的先验信息相对充足,可以把预测位点直接纳入突变验证的设计,减少盲目筛选。
八、双荧光素酶验证:从结合到调控功能
双荧光素酶验证(dual-luciferase assay)是 Y1H 候选走向"功能性调控证据"的关键一跳。Y1H 证明的是物理结合,双荧光素酶证明的是该结合在目标物种的细胞环境中具有转录调控效应。两者结合,才构成完整的调控证据。
体系设计
标准体系用两个报告基因:萤火虫荧光素酶(LUC)作为主报告,由目标启动子驱动;海肾荧光素酶(REN)作为内参,由组成型启动子驱动,用于校正转化效率与细胞状态差异。效应质粒表达候选转录因子。三者共转化到原生质体、原生动物细胞或烟草原生质球等体系中,48–72 小时后测定双荧光比值。
体系的判读逻辑是:效应因子若激活目标启动子,LUC/REN 比值上升;若抑制,比值下降。仅报告 LUC 绝对值而不做 REN 归一化,是新手最常见的错误,转化效率的差异完全可以制造出虚假的激活或抑制信号。
突变验证的加成
双荧光素酶实验最有力的版本是结合"启动子突变"与"因子突变"的双向验证。一方面,把启动子上的预测 motif 突变,观察效应因子的激活/抑制效应是否消失;另一方面,把效应因子的 DNA 结合结构域做关键残基突变或缺失,观察其调控功能是否丧失。两个方向的突变都导致效应消失,才能确认调控关系经由该结合界面介导。这是审稿人最常要求的证据组合,也是区分"相关"与"因果"的分水岭。
瞬时表达体系的边界双荧光素酶通常在瞬时表达体系中完成,表达水平远高于内源水平,可能产生非生理的调控效应。结果解读时应注意:强激活/抑制效应在瞬时体系中可能被夸大;需要染色质重塑的调控在瞬时质粒上无法重现。对关键结论,应补充 ChIP-qPCR 确认内源水平的结合,或在稳定转化体系中重复验证。
图3:从一皿菌落到一张调控图谱:酵母单杂交的价值在于把未知的调控关系变成可验证的分子假设
九、常见失败模式排查清单
酵母单杂交项目的失败高度模式化,绝大多数可以归入以下几类。按症状排查,能省掉大量重复实验。
症状一:筛选全阴性,一个阳性克隆都没有。排查顺序:先确认猎物文库质量(独立克隆数、平均插入长度、cDNA 是否来自正确组织);再确认诱饵株的报告体系完整(用阳性对照诱饵验证系统工作正常);然后确认转化效率(每次转化的克隆数是否达到覆盖度要求);最后检查选择压力是否过高(3-AT 浓度压掉了所有真阳性)。四个环节按顺序排查,通常能定位到具体问题。
症状二:阳性克隆很多但测序后全是少数几个重复。这不是筛选失败,是覆盖度不足或文库丰度偏斜的典型表现。高表达基因的 AD 融合克隆在文库中占据优势,把有限的选择资源消耗在重复克隆上。解决方式是提高筛选覆盖度(更多转化子)、在筛选前用基因组 DNA 消减或转录因子富集策略降低冗余、以及扩大挑克隆数量做更深度的测序注释。
症状三:点对点复验时信号消失。初筛阳性但复验阴性,通常是初筛背景的非特异信号被清除。也有可能是初筛克隆携带的猎物质粒在传代中丢失(若猎物对宿主有轻微毒性,无质粒细胞会逐渐占优)。复验时应从新鲜提取的猎物质粒出发重新转化,并在选择性培养基上尽早读结果。
症状四:诱饵株生长缓慢或不稳定。诱饵整合本身可能带来代谢负担,尤其多拷贝串联整合时。排查要点:确认整合结构是否完整(重组丢失是常见原因)、换用低拷贝整合、或把诱饵构建换成更稳定的载体系统。诱饵株不稳定的项目,筛选结果的可重复性也无从谈起。
症状五:双荧光素酶与 Y1H 结果不一致。这种不一致本身携带信息,Y1H 在酵母中测物理结合,双荧光素酶在目标物种细胞中测调控效应。不一致可能来自:结合需要辅因子或翻译后修饰(酵母中缺失)、瞬时体系中因子表达量超出生理范围、或结合位点在不同物种间不保守。此时应回到物种保守性分析与内源水平验证(ChIP-qPCR),而不是简单地二选一采信。
十、Y1H 与新兴互补技术的关系
酵母单杂交并非蛋白—DNA 互作研究的唯一工具,近年出现的几类互补技术正在改变这项研究的技术格局。理解它们与 Y1H 的关系,有助于合理组合而非盲目替换。
DAP-seq(DNA 亲和纯化测序)用体外表达的转录因子蛋白与基因组 DNA 文库做亲和结合,再通过测序获得全基因组结合位点图谱。它的优势是不需要构建酵母菌株、对植物等缺乏完善转基因体系的物种尤其友好,且能系统性地绘制某个因子的全基因组结合谱。与 Y1H 相比,DAP-seq 是"已知因子找位点",Y1H 是"已知位点找因子",两者方向互补。DAP-seq 的局限是体外结合条件与体内染色质环境的差异,对需要辅因子的结合事件检出能力有限。
Y1H-seq 与高通量 Y1H是把 Y1H 的筛选规模系统化放大的方案:用条码化的诱饵文库与猎物文库做大规模平行筛选,通过二代测序读出配对关系,一次实验覆盖数百上千对蛋白—DNA 组合。这类方案适合构建物种级的转录调控网络图谱,代价是建库与测序投入远高于单项目 Y1H,通常由专门的平台实验室承担。
计算预测的地位也在变化。基于 motif 数据库与深度学习的结合位点预测(包括蛋白质结构预测与蛋白—DNA 对接模型)已经能在设计阶段提供高质量的候选位点与候选因子列表。但预测的特异性仍然有限,预测给出的是"可能的组合",不是"已验证的互作"。务实的组合方式是:用预测做筛选范围的收窄与设计优化,用 Y1H 或 DAP-seq 做实验验证,用双荧光素酶与 ChIP 做功能确认。预测与实验的关系是分工,不是替代。
把这些工具放在同一条研究链上,可以形成一条从发现到确认的完整通路:计算预测收窄候选空间 → Y1H 或 DAP-seq 建立互作证据 → 点对点 Y1H 与突变诱饵确认结合特异性 → 双荧光素酶确认调控功能 → ChIP-qPCR 确认内源水平结合 → 遗传学突变体确认生物学功能。每个工具解决链条上的一环,没有哪一环能单独支撑完整的调控结论。
 X