定点突变从引物设计到突变体库的完整过程
1、突变策略选择树:先定路线,再动手
定点突变技术的第一步不是设计引物,而是选择路线。路线选错的代价是整轮实验重来,因此值得花十分钟做决策。决策树的核心分支只有一个:突变要发生在体外质粒上,还是发生在细胞基因组里。
如果目标是改造一个已经克隆好的载体,改变酶切位点、做点突变、验证结构域功能,体外方案是主战场,成本低、周期短、结果可控。如果目标是在内源基因上引入突变、构建细胞或动物模型,那么 PCR 类方法鞭长莫及,必须走 CRISPR 介导的体内编辑(HDR 或碱基编辑/先导编辑)。
体外路线内部还有一层分支:单点或少量分散位点适合全质粒 PCR 定点突变;多位点密集改造、插入、缺失或片段替换,更适合重叠延伸 PCR 或直接合成带突变的基因片段。这里有一个经常被忽略的判断点,当突变位点超过三个且相互距离在 100 bp 以内,直接委托基因合成往往比任何 PCR 方案都便宜且快,因为省去了反复设计引物、拼接、筛克隆的时间成本,交付的就是 100% 正确的序列。
| 需求场景 |
推荐路线 |
周期 | 主要风险 |
|---|---|---|---|
|
单点氨基酸替换 |
全质粒 PCR | 3–5 天 | 母本残留背景 |
|
多位点 / 插入 / 缺失 |
重叠延伸 PCR | 5–10 天 | 拼接效率不稳 |
|
3 个以上密集突变 |
基因合成替换片段 | 1–2 周 | 成本略高 |
|
功能残基定位 |
丙氨酸扫描 | 2–4 周 | 克隆量大 |
|
酶活 / 底物特异性改造 |
饱和突变文库 | 2–6 周 | 库偏向性 |
|
内源基因改造 / 建模 |
CRISPR-HDR 或碱基编辑 | 3–8 周 | 脱靶与低 HDR |
2、定点突变引物设计:参数边界决定成败
定点突变引物设计与普通 PCR 引物设计规则差别很大,核心原因是突变碱基本身就是"错配",它必须被包裹在足够长的完全匹配序列中间,才能在退火时稳定结合模板。把这段逻辑记住,参数就好推导了。
位置、长度与 Tm 的三角关系
突变碱基应放在引物正中央,两侧各延伸 10–15 个完全匹配的碱基,总长落在 25–45 bp 区间。这样设计的目的,是让引物中段形成的"错配泡"被两端稳定锚定。Tm 值要求高于普通 PCR,快速突变体系通常要求 Tm ≥ 78 ℃,因为高退火温度能抑制非特异延伸。计算 Tm 时要把突变碱基一并计入。上下游引物若为反向互补对(QuikChange 式),Tm 差值应控制在 5 ℃ 以内;若两条引物 Tm 差距过大,低 Tm 的一条会率先脱落,导致单链延伸占主导,最终形成线性化不完全的产物。
突变密码子的选择
氨基酸替换时,密码子的选择直接影响引物设计难度与后续表达。原则是改动最少碱基、避免稀有密码子、避开引物 3′ 端。例如 Ser→Ala,TCT 改为 GCT 只动第一个碱基,远优于换成 GCC 需要动两个碱基的方案。同时要模拟翻译确认没有意外产生终止密码子或移码,这一步用 SnapGene 或 Benchling 一分钟就能完成,但跳过它的后果往往是克隆测序后才发现。
引物设计速查
长度 25–45 bp(多点突变可加长至 45–60 bp)
突变位置 引物正中央,两侧各 ≥10–15 nt 完全匹配
GC 含量 40–60%(高 GC 模板可加 3–5% DMSO)
Tm ≥78 ℃(快速突变体系),上下游差 ≤5 ℃
3′ 端 以 G/C 结尾增强结合,突变碱基禁放 3′ 末端
二聚体 避开引物自身与引物间二聚体、发夹结构
高频错误突变碱基放在引物 3′ 末端 3 bp 以内是最常见的失败原因,聚合酶从错配位置起始延伸,效率断崖式下降。另一个高频错误是两条引物 Tm 差超过 5 ℃ 却仍按同一退火温度运行。这两个问题在设计阶段花两分钟能避免,但到测序阶段才发现至少浪费一周。
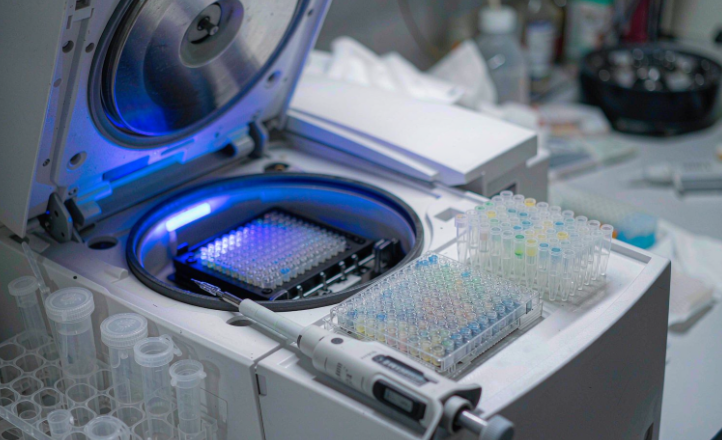
图1:全质粒 PCR 的热循环参数需要按质粒长度与 GC 含量单独优化,不能照搬普通 PCR 程序
3、全质粒PCR定点突变:最常用也最容易被坑
全质粒PCR定点突变(QuikChange 式)的逻辑优雅:一对反向互补引物携带突变,围绕整个质粒做线性扩增,用 DpnI 消化掉甲基化的母本质粒,转化后得到纯突变体质粒。整套流程 3–5 天就能完成单点突变。但它的失败模式也高度集中。
DpnI 消化不彻底 = 大量野生型背景
DpnI 只切割 Dam 甲基化位点,因此只能消化从大肠杆菌中提取的母本质粒,对 PCR 产物(无甲基化)不切割。这是整个方法的分水岭。若 DpnI 消化不彻底,转化的克隆里会混入大量野生型,菌落 PCR 看似阳性,测序却全是野生型。实操要点:消化时间至少 1 小时,酶量按质粒量放大而非按反应体积;对大质粒(>8 kb)或低拷贝质粒,建议消化后用 PCR 产物纯化柱过一遍,把消化产生的片段去掉,降低背景。
大质粒与高 GC 的特殊处理
质粒越长,全质粒扩增效率越低。8 kb 以上质粒建议延长延伸时间(按 30 s/kb 起步)、降低循环数(12–16 个循环足够,无需 18–25)、必要时改用长片段高保真酶。GC 含量超过 65% 的区域,加 3–5% DMSO 或 1 M 甜菜碱帮助解链。另一个实用技巧是把循环数压到最低,循环数越多,聚合酶引入的随机突变越多,测序时发现的"意外突变"大多源于此,而非模板本身。
多点突变的两种打法
当需要在同一质粒上引入两个以上突变时,有两条路。第一条是串联法:设计多对引物分轮做,每轮做完测序确认再做下一轮,稳妥但周期长。第二条是一次性法:用多条含不同突变的引物在同一反应中混合扩增,或分段扩增后用重叠延伸拼接。后者效率更高,但对引物间相互作用的要求也更高,需要用软件预判引物二聚体风险。
效率判断转化后菌落数量本身就是诊断指标。正常情况下单点突变应有几十到几百个克隆;若只有几个克隆,大概率是 PCR 扩增失败或 DpnI 消化过度导致总 DNA 量过低;若克隆数上千但测序阳性率极低,则应怀疑母本残留。从菌落数和阳性率这两个数字入手排查,比盲目重复实验有效得多。
4、重叠延伸PCR:拼接的艺术
重叠延伸PCR(OE-PCR)是处理多点突变、插入、缺失和片段替换的主力方法。它的核心思想是把待突变的基因切成若干段,每段末端携带与相邻段互补的重叠区(含突变),通过两轮或三轮 PCR 拼接出完整序列。拼接的质量完全取决于重叠区的设计。
重叠区的三个硬指标
重叠区长度 20–30 bp,是经验最优区间;短于 15 bp 退火不稳定,长于 40 bp 则合成成本上升且容易形成二级结构。重叠区 GC 含量应在 40–60% 之间,过低的重叠区在退火温度下无法稳定配对。突变位点(尤其是插入或缺失)应放在重叠区中央,让两端各有 10–15 bp 的完全匹配序列锚定。
两轮扩增的循环安排
第一轮分别扩增各段,用外侧引物加含突变引物配对,产物跑胶切胶回收。第二轮拼接有两种循环安排:经典做法是先做 5–10 个循环不加外侧引物,让两段靠重叠区自行退火延伸成全长,再加入外侧引物做 25–30 个循环;一步法则是从第一个循环就加入外侧引物。两种方式各有支持者,但一步法的关键在于片段等摩尔混合,若两段浓度相差悬殊,过量一端会自我扩增而抑制拼接。等摩尔混合这一条是刚性的,不可妥协。
拼接产物同样需要克隆与测序验证。这里有一个常被忽视的细节:外侧引物若加了酶切位点或同源臂,要在其 5′ 端外加 3–6 个保护碱基,否则限制酶切割效率会显著下降,导致后续载体连接效率低。同源臂长度建议 15–20 bp,且 GC 分布均匀、避开发夹。
拼接失败的三大诱因一是重叠区设计包含二级结构(用软件检查发夹与自二聚体);二是两片段浓度不匹配(必须定量而非目测);三是聚合酶选择不当,拼接用高保真酶的延伸能力可能不如 Taq,长片段拼接(>3 kb)应选用专门优化的长片段酶。三个诱因里,浓度不匹配占比最高,值得优先排查。
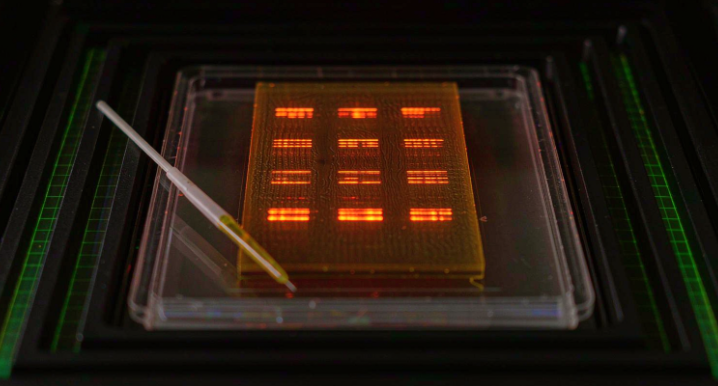
图2:凝胶电泳仍是突变体验证的第一道关卡:条带大小、单一性与背景带的位置都是诊断线索
5、丙氨酸扫描突变:把功能残基找出来
丙氨酸扫描突变是结构—功能研究的经典手段:把目标区域内的氨基酸逐一替换为丙氨酸,观察活性变化,从而定位关键功能残基。丙氨酸侧链最小且不带电荷,替换后几乎不引入新的化学性质,是"中和侧链功能而不破坏整体折叠"的理想选择。
但丙氨酸扫描有两个边界条件必须注意。第一,如果目标残基本身就是丙氨酸,就换成甘氨酸(保持最小侧链逻辑)。第二,如果蛋白中某区域富含甘氨酸或本身结构松散,丙氨酸替换可能导致局部折叠破坏,此时观察到的活性丧失可能是折叠问题而非功能位点,需要用保守替换(如 Ala→Ser、Asp→Asn)做交叉验证。
扫描范围的选择影响工作量。全长扫描一个 300 残基的蛋白需要约 300 个突变体,工作量巨大。更经济的做法是先做区域级扫描,每 5–10 个残基做一组"块替换"(block mutant),把整段换成 Ala 串,先定位敏感区块,再在敏感区块内做逐残基扫描。这个两级策略能把克隆数量压缩一个数量级,是大多数实验室负担得起的工作量。
判读活性数据时要警惕"位置效应"。某些位点的丙氨酸替换会导致蛋白表达量下降或降解加速,此时活性降低是"量不够"而非"活性差"。因此每次扫描都应平行测定表达量与活性两个指标,把比活(单位蛋白活性)作为主判据,避免把稳定性效应误读为催化功能。
6、饱和突变文库:简并性带来的偏差
饱和突变文库的目标是在一个或多个位点引入所有可能的氨基酸,用于酶工程、底物特异性改造与定向进化。文库设计中最容易被忽视的是简并密码子带来的不均匀性。
NNK 不是中性选择
NNK(N=A/C/G/T,K=G/T)是使用最广的简并方案,覆盖全部 20 种氨基酸与一个终止密码子。但它的覆盖并不均匀:NNK 用 32 种密码子编码 21 种可能,意味着某些氨基酸有多条路径被编码,另一些只有一条。结果是筛选时亮氨酸、丝氨酸等出现频率远高于甲硫氨酸、色氨酸。当筛选通量有限时,这种偏向性会显著压缩有效多样性。
更均匀的方案
NDT、DBK、NDT 等简化方案能在更少密码子下覆盖更均匀的氨基酸子集。例如 NDT 覆盖 12 种氨基酸且无终止密码子,适合"只需要一小类化学性质"的场景。三联体(trimer)合成技术则能精确控制每个氨基酸的出现概率,彻底消除简并偏差,代价是合成成本较高,通常用于关键单点或小规模热点饱和。
覆盖度计算
文库质量必须用覆盖度公式量化。对于 k 个位点、每个位点 n 种可能氨基酸,完全覆盖所需的理论克隆数为 nk,加上 95% 置信度的覆盖需要约 3 倍理论库容。例如两位点各 20 种氨基酸,理论库容 400,95% 覆盖需要约 1200 个独立克隆。实际转化得到的克隆数若低于此值,筛选很可能漏掉真正的最优解。这一点在设计阶段就应算清楚,不要等筛完才发现库容不足。
覆盖度速算
理论库容 N = n^k(n=每位点氨基酸数,k=位点数)
95% 覆盖 所需克隆数 ≈ N × ln(20) ≈ N × 3
实操建议 转化后实际克隆数 ≥ 3N 才开始筛选
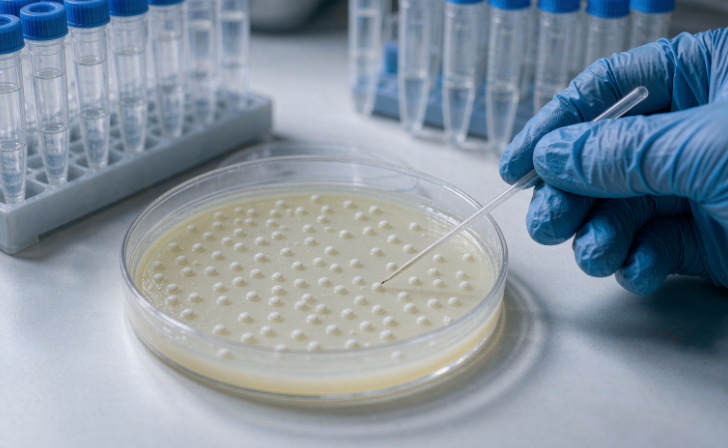
图3:突变体库构建的瓶颈常在克隆阶段:菌落密度、挑取方式与板式布局都直接影响库的实际多样性
7、突变体库构建:从设计到筛选的工程闭环
突变体库构建是把饱和突变、组合突变或定向进化策略落到实处的工程环节,涉及克隆策略、转化效率、筛选方式与质量控制四个环节。任何一环掉链子,前面的设计功亏一篑。
克隆策略上,大库容(>105)必须用电转化,化学转化效率天花板在 107 cfu/μg 左右,通常不足以覆盖高多样性文库。载体选择要匹配后续筛选方式:噬菌体展示需要噬粒载体,酵母展示需要酵母整合或游离载体,细胞内筛选则要考虑启动子强度与拷贝数。一个常被忽略的细节是载体本身的背景表达,若插入片段未成功连接,空载背景会在筛选中占据大量资源,用双色筛选或负筛标记可以有效压制。
库的质量控制必须做三件事。第一,随机挑取 20–50 个克隆测序,统计插入率、突变分布与氨基酸实际覆盖情况。第二,用高通量测序(NGS)对文库做深度抽检,量化每个位点的氨基酸频率是否与设计一致。第三,检测文库的多样性指数(通常用 Shannon 熵),判断实际有效多样性占理论多样性的比例。三项指标一起看,才能真正判断这个库"能不能筛"。
筛选阶段的偏倚控制筛选本身就是一层偏倚过滤器:表达量高的突变体天然更容易被检出,而与其真实活性无关。对于展示类筛选,可以用亲和力与表达量双参数门控来部分抵消;对于细胞内筛选,可用内参基因或报告基因做归一化。忽略这一层的筛选结果,常会把"表达好"误判为"活性高"。
8、CRISPR定点突变:从质粒走向基因组
CRISPR定点突变是唯一能在内源基因组上精确引入指定改变的路线,也是现代功能基因组学与疾病建模的基石。与体外质粒突变相比,它面对的是一个完全不同的问题域:细胞修复通路的竞争、供体模板的设计、编辑效率与脱靶的平衡。
sgRNA 与 PAM 的约束
CRISPR-Cas9 需要靶点旁有 NGG PAM(SpCas9),这把切割位点约束在特定位置,而编辑位点越靠近切割位点,HDR 效率越高(通常 10 bp 以内最佳)。若目标位点附近没有合适 PAM,可考虑其他 Cas 变体(SaCas9、Cas12a)或碱基编辑/先导编辑这类不依赖 HDR 的方案。sgRNA 的特异性评分(如 Doench 2016)与脱靶位点数量必须同步评估,实验室常用 CRISPOR、Benchling 等工具一次性完成。
供体模板的设计逻辑
小片段替换(<20 bp)用单链寡核苷酸(ssODN),同源臂 40–90 nt,成本低、效率高。大片段插入或多位点改造用带同源臂的质粒供体,同源臂 500–1000 bp。提高 HDR 效率的常见手段包括:在 S/G2 期富集细胞、共表达 Cas9 与供体、用 DNA-PK 或 53BP1 抑制剂抑制 NHEJ 竞争通路、在 sgRNA 切割位点引入沉默突变以防止 Cas9 重复切割已编辑的等位基因。这些手段并非都要叠加,而是根据细胞类型与编辑难度有选择地使用。
验证:必须做双份
编辑后的克隆验证至少包括两件事:目标位点 PCR + 测序确认引入了预期改变;同时用 PCR 或 qPCR 检查是否存在大片段缺失或重排,这是 HDR 实验中最常被漏检的问题。若项目对脱靶敏感(如细胞治疗、模型构建),还需用 GUIDE-seq、CIRCLE-seq 或 CHANGE-seq 等方法做脱靶谱分析,或用 WGS 做整体比对。
杂合与嵌合细胞群体编辑后常出现杂合与嵌合现象,同一克隆的不同等位基因携带不同改变,甚至同一等位基因内部存在混合峰。单克隆化之前,用 PCR 产物测序峰图判断嵌合度是基本功课;对需要明确基因型的项目,必须做单细胞克隆 + 等位基因分型,不能仅凭群体测序结果下结论。
9、突变体功能数据的解读:把活性差异变成结论
突变实验的最终价值取决于数据解读的质量。一个常见的低级错误是把单次测定的活性差异直接当作生物学结论,突变体活性是野生型的 60%,这个数字本身几乎不携带信息,除非知道它的误差范围与重复性。
规范的读法需要三个层面。第一层是重复与统计:至少三次独立生物学重复,报告均值与标准差,用合适的统计检验(t 检验或方差分析)判断差异显著性。第二层是效应量与置信区间:p 值只回答"差异是否存在",不回答"差异有多大",报告效应量与置信区间才能判断这个突变在生物学上是否重要。第三层是表达量的平行归一化:如前所述,必须同时测定蛋白表达量或纯化得率,把比活作为主判据,否则会混淆稳定性效应与催化功能效应。
动力学参数的解读还有一层:单个 Km 或 kcat 的变化不足以刻画酶学性质的改变。Km 下降可能意味着底物亲和力提高,也可能意味着催化步骤变慢导致表观亲和力假性升高;kcat/Km 作为催化效率的综合指标,在比较突变体时更稳健,但前提是测定在初速度范围内进行。涉及多位点或协同结合的酶,还需要完整的动力学曲线拟合,而不能只用单点测定。
热稳定性数据的解读同样有陷阱。Tm 值升高不必然意味着常温活性提升,某些突变通过刚性化结构提升 Tm,同时牺牲了催化所需的构象柔性,导致活性下降。稳定性与活性之间的权衡(stability-activity trade-off)是蛋白工程中最经典的折衷,解读数据时应同时报告两个维度,避免只优化单一指标。
突变叠加的非加和性多个有利突变的组合未必产生叠加效应。突变间的表观遗传性(epistasis)是定向进化的核心现象:两个单独有益的突变组合后可能相互抵消甚至有害。因此在组合突变前,应先做小规模组合矩阵验证,而不是默认"有益突变多多益善"。
10、大规模突变项目的工程化管理
当突变项目从几个位点扩展到几十上百个突变体时,工作重心从"技术执行"转向"项目管理"。这个阶段失败的项目大多不是败在实验技术,而是败在信息管理。
第一件事是命名与追踪体系。突变体的命名必须能从名字直接读出突变内容(如 A123V 表示第 123 位丙氨酸换成缬氨酸),构建批次、引物批次、测序批次用统一的编号规则关联。没有统一命名的项目,做到三十个突变体就会开始出现"这个克隆到底是什么"的困惑,而这个困惑的代价往往是一轮重复实验。
第二件事是测序数据与表型数据的关联。每个突变体应有唯一 ID,把测序结果(确认序列正确)、表达量、纯化得率、活性数据全部挂在这个 ID 下。用电子表格也能做到,但结构必须统一,列名固定、单位统一、缺失值明确标注。数据结构混乱的大项目,最终往往无法回答"哪个突变体表现最好"这种最基本的问题。
第三件事是冷冻保藏与质粒库。每个确认序列正确的突变体都应立即做甘油菌冻存并登记位置,质粒小提样品同步建库。突变体的再获取成本远低于重新构建,但前提是保藏体系在项目初期就建立。做过上百个突变体再回头找某个早期克隆却找不到保藏记录,是这类项目最常见的浪费。
第四件事是阶段性判断点。大规模突变项目应有明确的里程碑:完成多少个突变体后做一次数据汇总与方向评估,而不是无终点地累积数据。如果二十个突变体之后尚未出现任何活性显著改变的位点,应该回头审视实验体系的灵敏度与设计假设,而不是继续扩大克隆数量。适时止损与转向,是这类项目最稀缺的决策能力。
 X