DAP-seq技术:从体外蛋白表达到Motif分析,植物转录因子研究的利器
做植物转录因子研究的人都知道,想在体内做ChIP-seq有多难——植物细胞壁的交联效率低、抗体不好找、转化体系不成熟……DAP-seq的出现基本就是为了解决这些痛点。这篇不讲DAP-seq是什么的基础概念,直接上实操:体外蛋白怎么表达、DNA文库怎么建、磁珠富集怎么优化、peak怎么call、motif怎么分析、和ChIP-seq到底选哪个好。全是踩过坑之后的经验总结。
一、DAP-seq技术原理与核心优势:为什么它能替代ChIP-seq
DAP-seq(DNA Affinity Purification Sequencing)的技术原理说白了就是:把转录因子蛋白在体外表达出来,让它和基因组DNA文库自由结合,然后把结合了转录因子的DNA片段富集出来做高通量测序。和ChIP-seq最大的区别是——DAP-seq是体外结合,不需要做体内交联和免疫沉淀。
这个区别带来了一系列优势:
1、不需要抗体。这是DAP-seq最大的优势。ChIP-seq必须有针对目标转录因子的ChIP-grade抗体,植物转录因子的抗体几乎是找不到现成的商业抗体。DAP-seq用体外表达的蛋白,给蛋白加个标签(如Halo-tag、His-tag),用标签的亲和纯化系统来富集,完全绕开了抗体问题。
2、不需要做体内交联。植物组织的甲醛交联效率远低于动物细胞——细胞壁阻碍甲醛渗透,导致交联不均匀。DAP-seq是体外结合,不需要交联,避免了交联效率和交联偏好性带来的问题。
3、高通量筛选。一套DAP-seq流程可以同时筛选几十甚至上百个转录因子。蛋白在96孔板里表达,机器人自动化操作,一次实验就能拿到几十个转录因子的全基因组结合图谱。ChIP-seq想做到这种通量几乎不可能。
4、适用于任何物种。ChIP-seq在非模式物种中做不了,因为没有抗体。DAP-seq只要有转录因子的序列就能体外表达蛋白,对物种没有限制。非模式植物、作物野生近缘种都能做。
DAP-seq的核心优势总结:无抗体需求、无交联步骤、高通量筛选、物种不受限。但代价是只能检测体外结合,不能反映体内真实的结合状态(缺少体内调控修饰、染色质结构等因素的影响)。
二、DAP-seq与ChIP-seq区别:何时该选哪个?
DAP-seq与ChIP-seq区别不仅仅是"体外vs体内"这么简单。两者在实验设计、数据解读和应用场景上都有显著差异,选择哪个需要根据具体研究问题来定。
| 比较维度 | DAP-seq | ChIP-seq |
|---|---|---|
| 结合环境 | 体外(蛋白与裸露DNA结合) | 体内(染色质环境中) |
| 是否需要抗体 | 不需要 | 必须有ChIP-grade抗体 |
| 是否需要交联 | 不需要 | 需要甲醛交联 |
| 是否需要转化 | 不需要 | 需要稳定转化系 |
| 通量 | 高(可同时做几十到上百个TF) | 低(每次一个TF) |
| 物种限制 | 无限制 | 需要有抗体的物种 |
| 染色质结构 | 不反映(裸露DNA) | 反映 |
| 体内修饰影响 | 不反映 | 反映 |
| 成本 | 较低(蛋白表达+一次测序) | 较高(抗体+交联+建库+测序) |
实际选择策略:
大规模转录因子家族筛查:选DAP-seq。比如你想同时研究50个MYB家族转录因子的结合位点,ChIP-seq做50个是不现实的,DAP-seq一次就能搞定。
需要反映体内真实结合状态:选ChIP-seq。DAP-seq测到的是转录因子和裸露DNA的结合能力,但体内结合还受到染色质开放性、其他蛋白竞争、翻译后修饰等因素影响。
非模式物种:选DAP-seq。没有抗体就只能选DAP-seq。
转录因子有磷酸化修饰依赖:选ChIP-seq。体外表达的蛋白可能缺少关键的翻译后修饰,导致结合模式与体内不同。
最佳策略:两者结合。DAP-seq做大规模筛查找候选结合位点,ChIP-seq在关键转录因子上做体内验证。这种"体外筛查+体内验证"的策略在植物转录因子研究中越来越主流。
图1:DAP-seq体外蛋白表达与DNA亲和纯化实验场景
三、DAP-seq实验流程全解:从蛋白表达到文库富集
DAP-seq实验流程可以分成三大模块:体外蛋白表达、基因组DNA文库构建、亲和富集与建库测序。每个模块都有需要优化的关键参数。
1、体外蛋白表达
把目标转录因子的编码序列克隆到体外表达载体上,加一个亲和标签。常用的标签是Halo-tag,它和HaloLink磁珠是共价结合,洗脱条件温和、背景低。也可以用His-tag或Strep-tag,但Halo-tag在DAP-seq中的效果最好,是目前的标准配置。
2、基因组DNA文库构建
提取目标物种的基因组DNA,做片段化和接头加注。片段化方法有两种:酶切片段化(使用NEB的酶切片段化试剂盒)和超声破碎。酶切片段化的优势是重复性好、不需要优化超声参数,推荐使用。片段大小目标为150-300bp,便于后续建库。
DNA文库构建后需要做接头连接和纯化。接头序列需要和后续测序平台匹配(如Illumina TruSeq接头)。纯化用AMPure XP磁珠做双轮片段选择(0.6×和0.2×),保留200-400bp的片段。
3、亲和富集
这一步是DAP-seq的核心。把体外表达的标签蛋白固定在亲和磁珠上,然后和基因组DNA文库孵育,让转录因子和DNA自由结合。孵育条件需要优化:
结合缓冲液:20mM HEPES pH 7.5,50mM KCl,1mM DTT,0.5mM EDTA,0.1% BSA。KCl浓度对结合特异性影响很大,50mM是标准推荐,但有些转录因子在100mM下特异性更好。
孵育时间:室温1-2小时或4℃过夜。短时间结合效率低,长时间可能增加非特异性结合。建议做时间梯度(0.5h、1h、2h、过夜)找到最佳条件。
竞争性DNA:加入poly(dI-dC)(2-5μg)来封闭非特异性DNA结合位点。这一步很关键,不加poly(dI-dC)背景会非常高。
4、洗涤与洗脱
孵育后用洗涤缓冲液(含有更高浓度KCl,如100-150mM)洗涤3-5次,去除非特异性结合的DNA。然后用低盐或加热的方式洗脱结合的DNA,做PCR扩增加index,纯化后就可以上机测序。
DAP-seq实验流程中最容易出问题的环节是蛋白表达量。体外表达系统的蛋白产量直接影响结合信号。如果蛋白表达失败或产量太低,后面富集的DNA量会很少,建库困难。建议每次表达后都做Western Blot或荧光检测确认蛋白表达量。
四、DAP-seq体外蛋白表达系统选择与优化
DAP-seq体外蛋白表达系统的选择直接影响蛋白质量和实验成败。目前主要有两个系统被广泛使用。
1、麦胚无细胞表达系统(Wheat Germ Cell-Free System)
麦胚系统是DAP-seq最常用的体外表达系统。优势是:植物来源的翻译系统,能正确折叠植物转录因子;不含内源性哺乳动物蛋白,背景低;可以表达有毒蛋白(因为不涉及活细胞);96孔板格式适合高通量操作。
麦胚系统的优化要点:
模板质量:使用高纯度的质粒或PCR产物作为模板,模板中不能有内毒素或RNase污染。
表达温度:26℃是标准温度,16℃过夜表达可能提高蛋白可溶性。有些转录因子在高温下会形成包涵体。
表达时间:2-4小时通常足够,过夜表达不一定更好。
蛋白可溶性:表达后离心取上清,可溶性蛋白用于DAP-seq。如果蛋白大部分在沉淀中,需要降低表达温度或加分子伴侣共表达。
2、大肠杆菌表达系统
大肠杆菌系统产量高、成本低,但原核表达系统对植物转录因子的折叠可能不理想,尤其是含有较多翻译后修饰位点的转录因子。如果用大肠杆菌系统:
用BL21(DE3)菌株,IPTG诱导浓度0.1-0.5mM
诱导温度16℃过夜,提高可溶性蛋白比例
表达后做镍柱纯化,纯度>80%再做DAP-seq
注意:大肠杆菌表达的蛋白可能缺少磷酸化等修饰,影响结合特异性
两个系统的选择建议:优先用麦胚系统,如果蛋白在麦胚系统中表达量不够再考虑大肠杆菌。做之前先做一个小规模表达测试,确认蛋白可溶性和表达量再大规模做。
五、DAP-seq建库策略:DNA文库构建与片段化
DAP-seq建库和ChIP-seq建库有相似之处但有关键差异。DAP-seq的建库分两个阶段:第一阶段是基因组DNA文库的构建(在蛋白结合之前),第二阶段是富集后DNA的index加注和扩增(在蛋白结合之后)。
1、基因组DNA文库
从目标物种提取高质量基因组DNA。植物基因组DNA提取需要注意CTAB法或试剂盒法,确保DNA纯度(A260/A280在1.8-2.0之间,A260/A230>2.0)。DNA质量不好的话后续建库效率会大打折扣。
片段化推荐用酶切片段化(NEBNext Ultra II FS Module),3-5分钟处理可以打断到200-300bp。酶切片段化的重复性远好于超声破碎,DAP-seq做多个转录因子时这一点尤为重要——所有转录因子要用同一批DNA文库,保证可比性。
片段化后做末端修复和接头连接。接头序列选择取决于后续建库策略和测序平台。如果后续用Illumina平台,用标准的TruSeq接头。接头连接效率可以用qPCR检测,确保文库浓度达标。
2、富集后建库
亲和富集后的DNA量通常很少(皮克级),需要用PCR扩增来达到上机要求。PCR循环数通常12-15个,过多会增加PCR bias。扩增后用AMPure XP磁珠纯化(1.0×),去除引物二聚体和小片段。
建库质控用Bioanalyzer或TapeStation检查片段分布。理想的主峰在250-400bp(插入片段200-300bp+接头约100-120bp)。如果有大量接头二聚体(约120-150bp),说明PCR过度扩增或起始DNA量太少,需要调整。
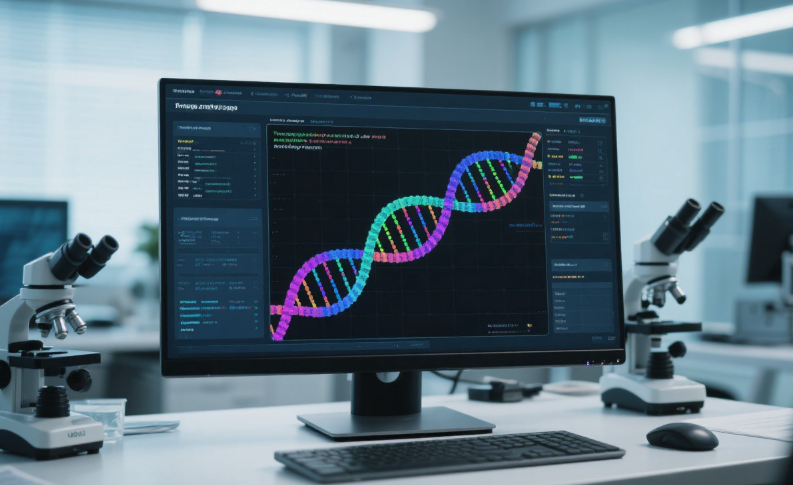
图2:DAP-seq数据分析中的转录因子结合位点与Motif可视化
六、DAP-seq数据分析全流程:从原始数据到结合图谱
DAP-seq数据分析流程和ChIP-seq有很多相似之处,但也有特殊的地方。主要步骤包括数据质控、序列比对、peak calling和下游分析。
1:数据质控
用FastQC检查原始数据质量。DAP-seq数据的质控指标和ChIP-seq基本一致:碱基质量值、GC分布、接头污染、重复序列比例。DAP-seq的duplicate rate通常比ChIP-seq略高(15-25%),因为起始DNA量较少,PCR扩增次数可能多一些。
2:序列比对
用Bowtie2比对到参考基因组。比对参数和ChIP-seq一样,但植物基因组有一些特殊需要注意的地方:
植物基因组经常是多倍体(如小麦六倍体、棉花四倍体),同源序列多,比对时需要处理多比对reads(multi-mapped reads)。一般保留唯一比对的reads(MAPQ>30),但有些研究允许保留最多3个比对位点的reads来提高覆盖度。
叶绿体和线粒体基因组reads需要去除——DAP-seq用的是基因组DNA,叶绿体DNA占了很大比例,不去除会干扰分析。
去除PCR duplicates(Picard MarkDuplicates)。
3:DAP-seq Peak Calling
DAP-seq peak calling和ChIP-seq一样可以用MACS2,但参数设置有差异。DAP-seq的Input对照是未做蛋白结合的基因组DNA文库("no-protein control"或"input library")。
DAP-seq的MACS2参数建议:macs2 callpeak -t DAP_sample.bam -c input_library.bam --bw 200 -q 0.01。--bw设为文库片段主峰大小。如果不加-c参数不做Input校正,背景会很高,peak数量虚高。
DAP-seq的peak特征和ChIP-seq有一些不同。DAP-seq的peak可能更分散,因为体外结合不受染色质结构限制,转录因子可以结合到基因组中所有可及的区域。这意味着DAP-seq的peak数量通常比ChIP-seq多,但其中一部分是体内不会结合的"潜在结合位点"。所以对DAP-seq的peak结果做motif验证非常重要——如果peak区域确实富集了该转录因子的已知motif,说明结果是可靠的。
4:Peak数量与质量评估
一个好的DAP-seq实验应该满足几个指标:
Peak数量:取决于转录因子,通常几千到几万个。如果一个转录因子只call出几十个peak,可能蛋白表达失败或结合条件需要优化。
FRiP(Fraction of Reads in Peaks):落在peak区域的reads占总reads的比例。FRiP>1%是最低要求,好的DAP-seq数据FRiP可以达到5-10%。
IDR(Irreproducible Discovery Rate):评估生物学重复间peak的重复性。IDR<0.05的peak才算高置信度peak。
七、DAP-seq Motif分析:发现转录因子识别序列
DAP-seq motif分析是验证实验可靠性和发现转录因子结合特异性的核心步骤。如果DAP-seq是成功的,那么call出的peak区域应该富集该转录因子的已知motif(如果有的话),或者能发现新的motif。
已知Motif验证
如果你的转录因子已经有已知的结合motif(从JASPAR或DAP-seq数据库获取),可以用FIMO或HOMER的findMotifsGenome.pl做已知motif在peak区域的富集分析。如果已知motif在peak区域显著富集(p-value<1e-10),说明DAP-seq结果是可靠的。
De Novo Motif发现
用MEME-ChIP或HOMER做de novo motif discovery。在peak中心区域(peak summit±50bp)做motif搜索,发现新的结合motif。DAP-seq数据库(http://dapseq.org)已经积累了大量植物转录因子的motif信息,可以做参考。
Motif分析的几个注意点:
Peak summit使用:不要用整个peak区域做motif分析,用peak summit附近的序列效果更好,因为结合位点通常在peak最高点附近。
背景序列选择:用GC-matched的随机序列或启动子区域序列做背景,避免GC含量偏好性影响。
Multiple motif:有些转录因子可以识别多个motif(如bZIP转录因子可以识别ACGT和G-box两种motif),de novo分析时要注意检查是否有多个显著motif。
Motif比较与分类
对同一转录因子家族的多个成员做motif比较,可以发现家族成员间的特异性。比如同一家族的转录因子A和B的motif相似但不完全相同,这种差异可能解释它们调控不同靶基因的原因。用TOMTOM做motif比较,或用Seq2Logo做motif logo可视化。
八、DAP-seq转录因子结合位点全基因组鉴定策略
DAP-seq转录因子结合位点鉴定不仅仅是"call peak"这么简单,还需要做一系列下游分析来确定哪些结合位点是有生物学意义的。
1. Peak注释与功能分析
Peak注释和ChIP-seq类似,用ChIPseeker把peak映射到最近的基因,判断peak落在启动子、5'UTR、3'UTR、内含子还是基因间区。DAP-seq的peak分布特征和ChIP-seq有所不同——DAP-seq可能在基因间区有更多peak,因为体外结合不受染色质开放性的限制。
重点关注启动子区域的peak(TSS上游2kb内的peak),这些更可能是功能性结合位点。对peak附近基因做GO和KEGG富集分析,了解转录因子调控的生物学通路。
2. 与RNA-seq数据整合
DAP-seq找到的结合位点不一定是功能性调控位点。要判断一个结合位点是否有功能,需要结合转录因子的过表达或敲除后的RNA-seq数据:
DAP-seq peak附近基因在转录因子突变后表达发生变化,才是功能性靶基因。
做"peak + DEG"的交集分析,找到既有结合位点又有表达变化的基因,这些是高置信度靶基因。
关注peak区域同时有motif存在且基因表达变化的"三重验证"位点。
3. 多转录因子比较分析
DAP-seq的高通量优势在这里体现。如果你同时做了几十个转录因子的DAP-seq,可以分析:
结合位点重叠:哪些转录因子结合到相同的基因组区域?这可能是协同调控的。
共调控模块:结合到同一组靶基因的转录因子可能形成共调控模块,用网络分析来鉴定这些模块。
家族特异性:同一家族不同成员的结合位点差异,揭示功能分化。
图3:植物基因组学高通量测序与研究平台
九、DAP-seq在植物转录因子研究中的应用场景
DAP-seq植物应用场景非常广泛,以下是一些典型的应用方向和实战策略。
1:转录因子家族系统性筛选
植物中有大量的转录因子家族(拟南芥有约2000个转录因子,水稻约2500个,玉米约3000个)。很多家族有几十甚至上百个成员,逐一做ChIP-seq是不现实的。DAP-seq可以一次性筛选整个家族或亚家族,获得每个成员的全基因组结合图谱。
实战策略:先根据系统发育树选择代表性的家族成员做DAP-seq(比如50个MYB成员中选15个代表性成员),获得初步结合图谱后,再对关键成员做ChIP-seq做体内验证。这种"先广后深"的策略在时间成本和数据质量之间取得了很好的平衡。
2:非模式植物转录因子研究
很多经济作物和药用植物没有成熟的转化体系,做不了ChIP-seq。DAP-seq只要有转录因子序列就能做,不受物种限制。比如研究某药用植物中次生代谢相关转录因子的结合位点,克隆转录因子基因后在麦胚系统中表达蛋白,用该物种的基因组DNA文库做DAP-seq,就能拿到结合图谱。
3:转录因子进化分析
比较不同物种中同源转录因子的结合位点,可以揭示转录因子结合特异性的进化。例如,比较拟南芥和番茄中同源AP2/ERF转录因子的DAP-seq数据,看结合motif和结合位点是否保守。这种比较分析对理解植物转录调控网络的进化有重要意义。
4:环境响应转录因子筛选
植物在胁迫(干旱、高盐、低温)响应中会激活大量转录因子。用胁迫处理前后的材料做RNA-seq找到差异表达的转录因子,然后对这些转录因子做DAP-seq,一次性获得它们的结合图谱。再结合胁迫后的RNA-seq数据做整合分析,就能构建胁迫响应的转录调控网络。
5:育种相关转录因子功能解析
GWAS分析找到的QTL区域如果包含转录因子基因,可以用DAP-seq快速确定这个转录因子的结合位点和潜在靶基因。结合优异等位变异分析,为分子标记辅助育种提供靶位点信息。这种方法在水稻、玉米等主要作物中已有成功的应用案例。
十、DAP-seq实验中的常见问题与优化方案
最后总结DAP-seq实验中常遇到的问题和优化方案:
问题一:蛋白表达失败或产量低
这是最常见的问题。解决方法:检查表达载体序列是否正确(特别是起始密码子位置和阅读框);优化表达温度(26℃→16℃过夜);检查麦胚系统的试剂是否过期;尝试换用大肠杆菌表达系统做备选。
问题二:Peak数量太少或没有Peak
原因可能是:蛋白没有活性(可溶性差或折叠不正确);结合条件不合适(KCl浓度太高或太低);DNA文库质量差;PCR扩增不足。解决方法:做Western确认蛋白可溶性;做EMSA验证蛋白-DNA结合活性;调整结合缓冲液KCl浓度(25mM-100mM做梯度);增加PCR循环数。
问题三:背景太高
原因:poly(dI-dC)用量不够;洗涤不充分;磁珠非特异性吸附。解决方法:增加poly(dI-dC)到5-10μg;增加洗涤次数和洗涤液中KCl浓度;做"no-protein control"来评估背景水平。
问题四:重复性差
原因:蛋白表达批次间差异大;DNA文库不同批次;PCR扩增效率差异。解决方法:同一次表达足够量的蛋白分装保存;一次制备大量DNA文库分装使用;统一PCR循环数和起始DNA量。
问题五:与ChIP-seq结果不一致
DAP-seq和ChIP-seq结果不一致是正常的——DAP-seq测的是体外结合能力,ChIP-seq测的是体内真实结合。不一致的位点可能反映了染色质可及性、其他转录因子竞争、翻译后修饰等体内因素的作用。建议关注两者一致的高置信度结合位点,同时分析不一致位点背后的生物学意义。
DAP-seq技术的出现确实让植物转录因子研究进入了一个新的阶段。不用抗体、不用转化、能做高通量筛选——这些优势让以前做不了的实验变成了可能。当然,DAP-seq不是万能的,它测的是体外结合,不能完全替代体内的ChIP-seq。最好的策略是把DAP-seq作为筛查工具,ChIP-seq作为验证工具,两者互补使用,才能构建可靠的植物转录调控网络。
 X