别再把DAP-seq错当ChIP-seq平替!从HaloTag表达质控、文库参数优化到证据链搭建的全流程
先说一个残酷的现实。DAP-seq 这个名字里的"DAP"(DNA Affinity Purification)听起来像是 ChIP-seq 的平替,但两者回答的根本不是同一个问题。搞混这件事,是 DAP-seq 数据在审稿时被质疑最多的根源。
ChIP-seq 问的是:在细胞里,这个转录因子此刻坐在基因组哪个位置?
DAP-seq 问的是:如果我把这条 DNA 单独拿出来泡在这个蛋白里,它会不会被绑住?
一个是"在场",一个是"能不能"。一个是细胞内的真实状态,一个是体外的序列亲和力。
DAP-seq 给你的不是"转录因子在细胞里结合了哪里",而是"这个转录因子的 DNA 结合域,在没有染色质干扰的情况下,愿意抓住哪些序列"。这句话必须原封不动地写进你的论文 Discussion 里。—— 少写一个字,就会在审稿时被要求补 ChIP
那么,什么情况下 DAP-seq 是对的选择?
(1)没有抗体可用:非模式物种、或者 TF 家族成员太像多而抗体难做。ChIP-seq 需要 ChIP 级抗体,这是一道硬门槛。
(2)没有转基因材料:ChIP 需要敲除内源基因后转入带 FLAG/HA 标签的转基因系,这在很多物种里做不动。
(3)要做大规模家族扫描:一个物种 1000 多个 TF,逐个做 ChIP 不现实,DAP-seq 的单次成本低一个量级。
(4)要做序列本征偏好研究:想系统刻画某个 TF 结合域的 motif degeneracy。
(5)要研究 DNA 修饰(甲基化)的影响:ampDAP-seq 这条路线是它独有的优势,ChIP 做不到这么干净地剥离染色质。
反过来,如果你要回答的是"这个 TF 在我这个组织、这个处理条件下,到底调控哪些基因",DAP-seq 单独用是不够的,必须配合表达组和染色质可及性数据——后面会详细讲怎么配合。
01、原理与 ChIP-seq 的本质差别:一条染色质的分界线
搜"DAP-seq 原理 与 ChIP-seq 区别"的人,多半是在做技术选型。这里我用一个具体的对照来把差别讲透,而不是背定义。
| 维度 | ChIP-seq | DAP-seq |
|---|---|---|
| 结合发生的场所 | 活细胞内,天然染色质环境 | 体外试管里,裸露 DNA + 纯化蛋白 |
| 需要什么 | ChIP 级特异性抗体(或转基因标签) | 只要 TF 的 CDS 序列,能体外表达即可 |
| 能看到什么 | 生理条件下的真实占位 | 序列本征亲和力 / motif 偏好 |
| 看不到什么 | 序列本征偏好(被染色质掩盖) | 染色质可及性、辅因子协同、组织特异性 |
| 甲基化的影响 | 混杂难分离 | 可设计保留或去除(ampDAP-seq) |
| 通量 | 一个 TF 一套抗体,一次一个 | 一个文库可复用,几十上百个 TF 并行 |
| 物种限制 | 必须有可用抗体 / 可转化 | 理论上任何能提取基因组 DNA 的物种 |
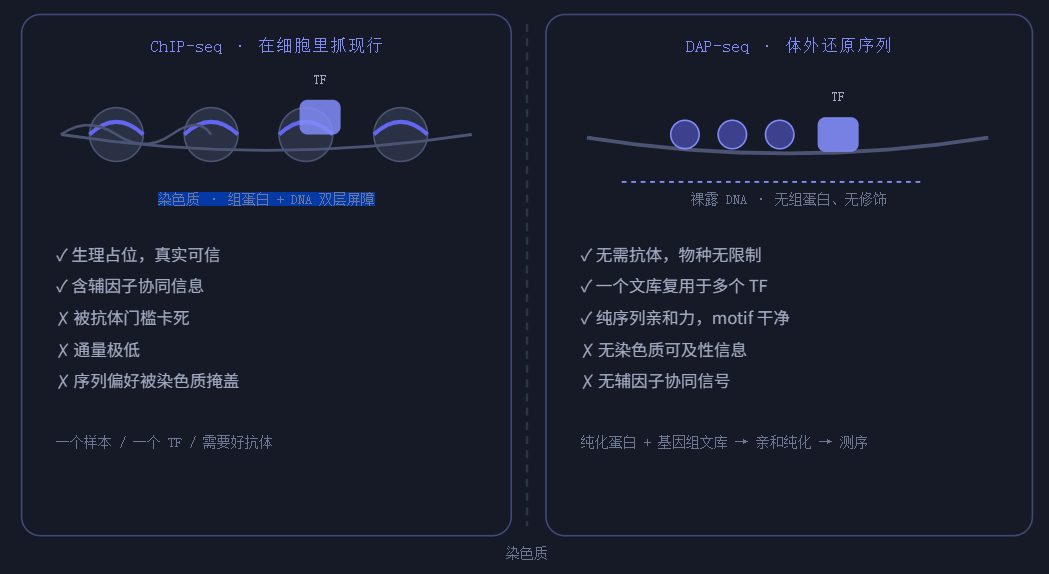
图 1 · 染色质是两种技术的分界线。ChIP-seq 在完整的染色质环境里抓取 TF,拿到的是"细胞此刻的真实占位";DAP-seq 把染色质整个剥掉,只留一条裸露的 DNA 和一个纯化的 TF,因此测到的是纯粹的序列亲和力。理解这一点,后面所有的假阳性讨论才说得通。
怎么在论文里措辞,才不会被审稿人挑
不要写"DAP-seq 鉴定了 XX 转录因子的全基因组结合位点"——这个说法过界了,因为"结合位点"暗示了生理占位。更准确的表述是:"DAP-seq 揭示了 XX 转录因子体外结合偏好及潜在结合位点",或者"基于序列亲和力的候选结合位点"。
同时,主动在 Figure 1 旁边画出这个体外/体内的对照关系图,审稿人一眼就知道你清楚这个边界在哪,反而会加分。一个对自己方法边界有清醒认知的作者,和一个把所有数据都当生理证据的作者,审稿人给的分是完全不同的。
02、蛋白这一端:HaloTag 无细胞表达的三种体系
搜"DAP-seq HaloTag 无细胞体外表达"的人,多半卡在一个现实问题上:我要做 80 个 TF 的 DAP-seq,但每个 TF 都要做一次 IP、一次蛋白纯化、一次浓度定量。这个工作量直接劝退。
DAP-seq 的核心工程创新,正是把这一步变成了"两小时、无需纯化柱、可以批量做"。
为什么是 HaloTag
HaloTag 是一种工程化的酶结合标签。它的特别之处在于:标签自身没有抗体。你不需要为每种标签开发亲和纯化方案,只需要在纯化磁珠表面共价接上氯烷基(chloroalkane)配基,标签就会自己"跳"上去被抓住。这个反应是不可逆的、选择性极高的,而且不需要低温、不需要维持蛋白活性。
对比一下传统方案:His 标签要 Ni-NTA,FLAG 要抗 FLAG 磁珠,GST 要谷胱甘肽琼脂糖——每换一个标签,磁珠和缓冲液体系就得跟着换。HaloTag 让你所有 TF 用同一套磁珠、同一个操作流程,这就是它能做规模化的原因。
| 无细胞表达体系 | 原理 | 产量 | 适用场景 | 坑 |
|---|---|---|---|---|
| 兔网织红细胞裂解液(reticulocyte) | 哺乳动物翻译系统,接近天然折叠 | 约 50–100 ng / 2 h | 哺乳动物来源 TF,含复杂修饰的蛋白 | 成本偏高;背景翻译产物多 |
| 小麦胚提取物(wheat germ) | 植物来源翻译系统,成本低 | 同上量级,单价更便宜 | 植物 TF、大规模筛选的首选 | 对哺乳动物序列的翻译效率可能偏低 |
| 大肠杆菌体外表达 + 纯化 | 常规重组表达 | 高,但需多步纯化 | 需要高浓度或特定 TF(家族成员多) | 包涵体、不溶、纯化慢,丧失规模优势 |
三个必须检查的质量指标
体外表达最大的风险是蛋白没表达出来,或者表达成了不溶的包涵体,而这两种情况在跑完 DAP-seq 之前你完全看不出来——最后得到一张空图,你根本不知道是"这个 TF 不结合任何序列"还是"这个 TF 压根没表达出来"。
所以在正式做 DAP-seq 之前,每个 TF 至少要过三关:
(1)产量检测:跑一小段 SDS-PAGE,看有没有预期分子量的条带。至少要在银染或考马斯亮蓝下看得见。
(2)可溶性检测:离心后上清里要能看到蛋白。如果全在沉淀里,翻译体系的条件(温度、离子强度、还原剂)需要调。
(3)结合活性阳性对照:这是最关键的一关。用一个已知能结合特定 motif 的探针(比如一个强结合的通用 TF),走一遍你的结合-洗涤-洗脱流程,确认能拉下来。活性验证不过,后面所有数据都不可信。
最常见的一种"空图"故障
跑完 DAP-seq,发现某个 TF 的 peak 一个都没有。不要立刻下结论"这个 TF 不结合 DNA"。按下面的顺序排查:
(1)蛋白真的表达出来了吗?(银染 SDS-PAGE)
(2)蛋白是 soluble 的吗?
(3)蛋白有活性吗?(用已知 motif 探针做阳性对照)
(4)结合缓冲液的离子强度对吗?(某些 TF 需要特定 KCl/NaCl 浓度,Mg²⁺ 或 Zn²⁺)
(5)洗涤强度是不是太强了?(序列亲和力弱的 TF 很容易被洗掉)
五项都排除了,"这个 TF 不结合"才是可信的结论。
03、DNA 这一端:文库制备的四个决定性参数
搜"DAP-seq 基因组 DNA 文库 制备 片段化"对应的实际操作,其实是整个流程里最容易出岔子的地方。因为文库一旦制备完成,它决定了后面所有 TF 的实验结果——文库有问题,你做 100 个 TF 也是 100 份坏数据。
片段长度:200–500 bp 的取舍
主流做法是随机片段化到 200–500 bp。这个范围不是随便定的:
(1)下限 200 bp:太短的片段(<100 bp)在后续纯化中容易通过过滤或者在磁珠上挂不住,洗脱效率骤降。
(2)上限 500 bp:太长的片段会显著降低测序读长利用率,且在 PCR 扩增时容易产生偏好性扩增(长片段扩增效率低),最终导致测序深度在片段长度上分布不均。
(3)最佳区间 250–350 bp:大多数流程的实际落点。这个长度足以容纳一个完整的转录因子结合motif(通常 6–20 bp)加上足够的侧翼序列,同时保证读长利用率。
片段化方式上,酶切(随机限制酶)比超声打断更可控。超声的剪切分布依赖仪器参数和样本状态,不同批次的片段长度分布会有差异,这会直接影响不同实验之间的可比性。做全套 DAP-seq 的时候,酶切几乎是必须的选择。
接头连接:这一步决定了文库能不能被测
基因组 DNA 片段化之后要接上测序接头(Illumina 平台)。这里有个关键的分支决定,直接影响你能做什么分析:
| 建库方式 | 是否保留天然修饰 | 能做的额外分析 | 代价 |
|---|---|---|---|
| PCR-free 建库 | 保留(甲基化状态不变) | 可做甲基化敏感位点分析 | 建库效率略低,需要更多起始 DNA |
| PCR 建库 | 部分保留(PCR 前几轮保留,后续循环会被洗掉) | 一般不做修饰相关分析 | 标准做法,量大、效率高、库浓度可控 |
一个文库复用于多个 TF:省时间也省钱的关键设计
DAP-seq 最有商业价值的特性是:你只需要制备一次基因组文库,就可以用它做几十个乃至上百个 TF 的结合实验。
这一点带来的不只是省钱,更重要的是消除了实验间变异。如果每个 TF 各自制备一份文库,那么不同 TF 之间的 peak 差异里,就混杂了"文库批次差异"这个无法区分的变量。而用同一份文库,所有 TF 都在完全相同的底物上竞争,TF 之间的差异才真正反映序列亲和力的差异。
起始 DNA 量与组织材料的换算
常见要求是:纯化基因组 DNA 约 10 μg,或者新鲜组织 5 g(植物)/ 2 g(动物、微生物)。如果你的物种 DNA 提取效率低,这个量要相应放大。更好的策略是一次性多提一些 DNA、制备一个大库、分装冻存,这样后续所有实验都用同一批底物,样本间一致性最好。
文库 QC 该看什么
在拿去跟 TF 结合之前,文库至少要过两个检查:
(1)片段分布:Bioanalyzer 或 TapeStation 跑出来应该在 200–500 bp 之间出现主峰,且分布集中。如果出现明显的小片段拖尾(<100 bp),说明片段化过度或者接头连接后有降解。
(2)浓度与摩尔量:qPCR 定量。文库摩尔浓度要换算成"每反应加入多少 pmol",而不是简单加体积——这是不同 TF 之间保持可比的关键。
(3)可选但强烈推荐:把文库测一遍(哪怕只有 1/10 的量),确认它的比对率和 GC 分布符合预期。这一步能提前发现"文库质量不行"这种要等一个月后才发现的灾难。
04、input 对照:它不是"多余的那个孔"
搜"DAP-seq Input对照 作用"的人,大概是想搞清楚:input 到底要不要做,不做会怎样。
答案很明确:必须做,而且它是整个分析的基石。
input 的定义是:亲和纯化之前的文库本身。也就是那份基因组 DNA 文库,不加任何 TF,直接建库测序。
它在算法层面到底做了什么
peak calling 的基本逻辑是:比较"洗下来什么"和"本来就有什么"。
基因组 DNA 文库里,每个片段都会以接近随机的方式被测到——包括那些 GC 含量高、复杂度高、容易形成二级结构的区域。这些区域有个特点:它们在任何一次 pull-down 里都会以较高的比例出现,跟你有没有加 TF 无关。这叫"背景偏好"(GC bias、mapping bias、重复序列偏好)。
如果不减掉这一层背景,你的 peak calling 会把所有高 GC 的区域都报成"TF 结合位点"。这时候你会发现 peak 数量多到离谱,而且全都挤在基因组某些区域——这个现象有个专门的名字叫"信度陷阱"(hyper-ChIPable regions),是 ChIP-seq 领域最著名的假阳性来源。
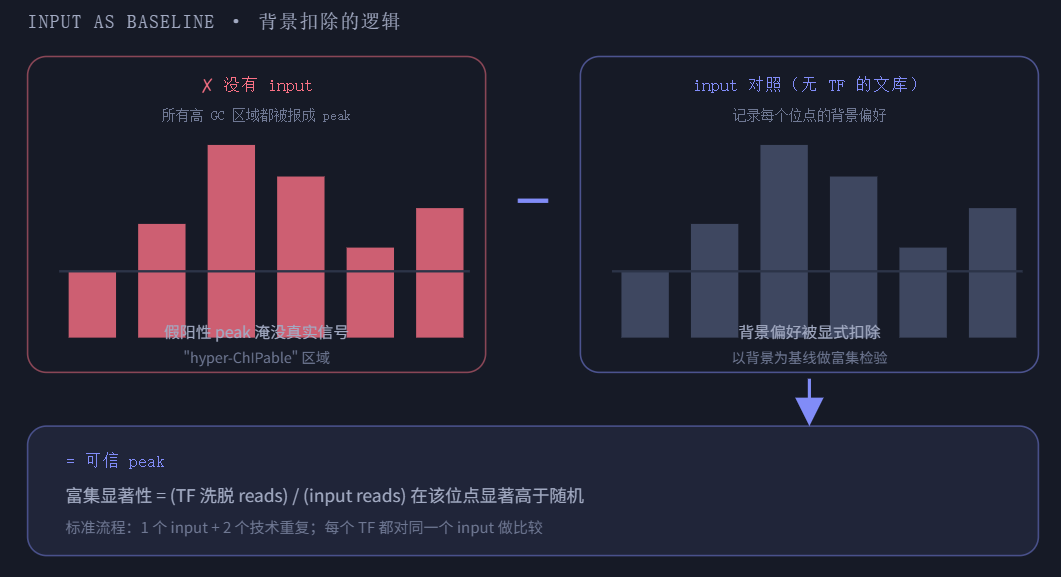
图 2 · input 对照是 peak calling 的减数项。左图是没有 input 时的情形——所有高 GC、高复杂度的区域都会被误判为结合位点。右图是 input 本身,它记录了每个位点在没有 TF 参与时的固有偏好。两者相减(富集比),剩下的才是 TF 真正带来的特异信号。这就是为什么 input 缺一不可。
测序量和重复怎么定
常规推荐测序深度是基因组的 3×–5×。需要加量的两种情况:一是物种与参考基因组匹配度低(比对率会掉),二是样本本身复杂(比如植物根部混有大量微生物共生体,会稀释有效 reads)。
重复方面,标准流程是一个 input 对照 + 两个技术重复。这里的技术重复不是"做两遍一模一样的东西"——技术重复共享同一个 input,衡量的是 pull-down 过程本身的重复性;而生物学重复需要重新制备文库,衡量的是独立样本间的稳定性。如果你要论证"这个 TF 在不同组织里结合模式不同",那就必须有生物学重复,因为那已经不是在测技术波动了。
05、ampDAP-seq:把 DNA 修饰留着,还是去掉
搜"ampDAP-seq DNA 修饰 甲基化 保留"对应的其实是两个不同的技术路线,选哪个取决于你想问什么问题。
| 路线 | 原理 | 能回答 | 注意 |
|---|---|---|---|
| 标准 DAP-seq | PCR-free 建库,保留 DNA 天然修饰 | TF 结合是否受甲基化影响 | 建库效率较低,对 DNA 质量要求高 |
| ampDAP-seq | PCR 扩增过程中修饰被"洗掉" | 纯序列亲和力(排除修饰干扰) | 更适合做 motif 谱系分析 |
这个区分在实际研究中经常被忽略,但它决定了你的数据能不能和别人的数据合并分析。如果你的 DAP-seq 数据是 PCR-free 的(保留甲基化),而同一篇文章里另一个 TF 的数据是 ampDAP-seq 的(去除了修饰),那么这两个 TF 的 peak 数差异里,就混进了"修饰是否保留"这个技术变量。
甲基化这件事,DAP-seq 比 ChIP-seq 强在哪
ChIP-seq 里,DNA 甲基化的影响是完全混杂的——你无法区分"这个 TF 不结合甲基化区域"和"这个 TF 在这个区域根本接触不到"。因为在体内,甲基化的 CpG 通常位于核小体定位的富集区,本来就可能处于闭合状态。
而 DAP-seq 是把 DNA 单独拿出来泡,甲基化的影响被完全暴露出来。你可以拿同一条序列的甲基化版本和非甲基化版本做对照实验,直接测出甲基化对结合亲和力的影响。这个能力是 ChIP-seq 结构上做不到的。
如果你的目标 TF 对甲基化敏感
有一类 TF 的结合位点明显偏好或排斥 CpG 甲基化——比如某些含锌指的 RFX 家族、以及依赖 CpG 岛结合的锌指蛋白。对这类 TF 做 DAP-seq 时,PCR-free 是必须的,否则你会得到"这个 TF 只结合 GC 富集区域"的假象,而真实原因只是那些区域恰好也是甲基化的。
反过来,如果你要刻画 TF 的 motif 本征偏好(motif 谱系分析、去冗余、找共识 motif),ampDAP-seq 反而更干净,因为修饰被剥掉了,信号更纯粹地反映序列本身。
一句话判断:你想问"这个 TF 会不会结合甲基化区域",用 PCR-free;你想问"这个 TF 喜欢什么序列",用 ampDAP-seq。在写 Methods 的时候,把这条路线写清楚,审稿人就不会质疑你的数据可重复性了。
06、假阳性地图:体外结合的四个系统性盲区
搜"DAP-seq 假阳性 ATAC-seq 联合分析"的人,说明已经意识到单靠 DAP-seq 的结论不够扎实了。这一节把问题讲透,并给出可操作的补救方案。
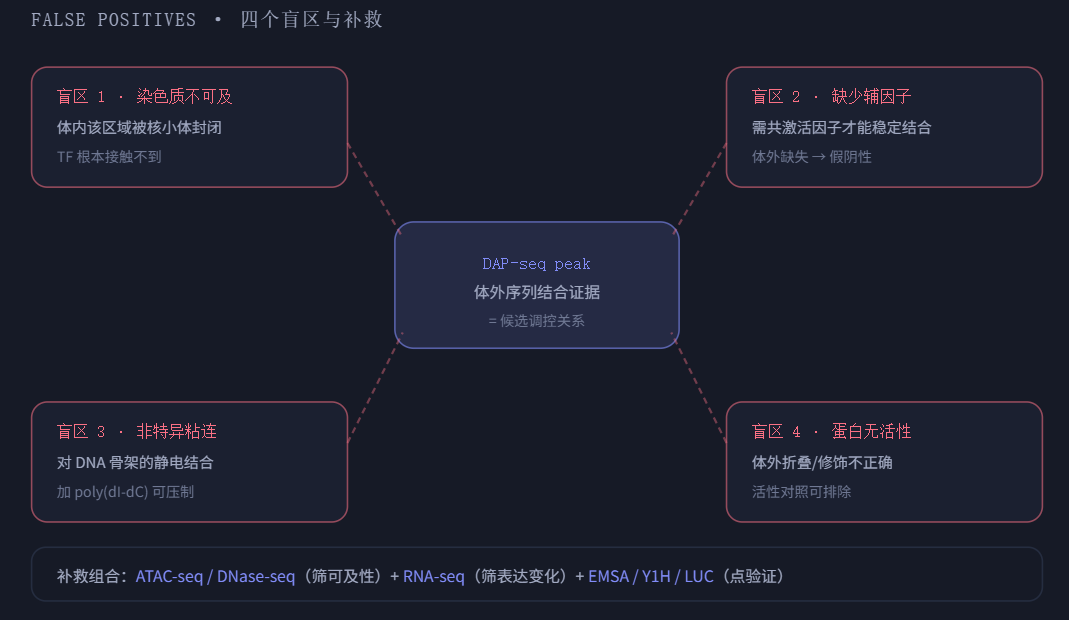
图 3 · DAP-seq 的四个系统性盲区。左上:体外能结合但体内染色质关闭的位点(假阳性);右上:需要共激活因子才能结合的位点(假阴性);左下:与 DNA 骨架的非特异静电结合;右下:体外表达蛋白失去活性。这四类问题无法靠重复实验消除,必须靠联合分析(ATAC-seq 筛可及性、RNA-seq 筛表达变化)和点对点验证(EMSA、Y1H、双荧光素酶)来收敛结论。
补救方案一:用 ATAC-seq 过滤
这是最直接有效的一招。ATAC-seq 或 DNase-seq 给出的是细胞里真正开放、可被 TF 接触的染色质区域。把你的 DAP-seq peak 和 ATAC-seq peak 做重叠,取交集:既体外能结合、体内又开放的位点,可信度立刻上一个台阶。
反过来,如果你只有 DAP-seq 数据但没有 ATAC-seq,至少可以退一步用公开的 ATAC-seq 数据集(ENCODE、原始数据数据库里同物种同组织的),作为外部参照。
补救方案二:用表达组做关联
DAP-seq 给你的是"TF 可能结合这些位点",但没告诉你"这些位点有没有在起调控作用"。如果某个 DAP-seq 靶基因在你的处理组里表达显著变化(来自 RNA-seq 或 qRT-PCR),那么"这个 TF 在调控它"的可能性就大幅提升。
补救方案三:点对点验证不能省
无论前面做了多少联合分析,最终都必须做几个位点的点对点验证,否则结论停在"候选"层面,永远发不出有说服力的文章。各方法的分工:
- Y1H(酵母单杂交):验证 TF 能否结合该位点。优点是快、便宜、可高通量;缺点是酵母内源激活因子会造成假阳性,融合蛋白毒性会造成假阴性。bait 序列长度建议 200–300 bp,太短结合不上、太长自激活严重。
- EMSA:体外结合特异性的金标准。必须做三组对照——冷探针竞争(信号应减弱消失)、突变探针对照(不应有 shift)、无关蛋白对照。只有三组都做,结论才有说服力。EMSA 的局限是难以检测低亲和力结合,也无法反映复合体状态。
- 双荧光素酶报告基因(LUC):验证调控功能。注意 nLUC 与 cLUC 互换后信号应保留,如果互换后信号丢失,说明存在标签位阻。
- ChIP-qPCR:连接体外与体内的桥梁。如果有 ChIP 级抗体,做 ChIP-qPCR 是最直接的体内验证——靶启动子区域相对阴性区域富集 2 倍以上且统计显著,即为阳性。
一个常被问到的顺序问题
"Y1H、EMSA、LUC、ChIP-qPCR 要做几个、怎么排序?"
一般路径是:Y1H 筛选 → EMSA 验证体外直接结合 → LUC 验证功能 → ChIP-qPCR 验证体内占位。EMSA 排在后面是有道理的——它需要你先知道启动子上可能的结合 motif 序列才能设计探针,而 Y1H 或者 DAP-seq 正是提供这个信息的来源。
从证据强度看:体外(Y1H/EMSA)和体内(LUC/ChIP-qPCR)至少各要有一个,因为它们回答的是完全不同的两个问题。只做体外,可以说"能结合";只做体内,说不清"直接结合还是间接结合"。
07、从峰到靶基因:motif、peak calling 与注释
搜"DAP-seq motif HOMER MEME peak calling"对应的是数据处理的完整链条。这一节讲怎么把测序数据变成生物学结论,以及每一步的常见坑。
| 步骤 | 常用工具 | 关键参数 | 坑 |
|---|---|---|---|
| 质控 | FastQC / MultiQC | — | 不要跳过 rRNA、接头残留的检查 |
| 去接头、过滤 | fastp / Trimmomatic | 最低质量阈值、读长下限 | 过滤太狠会显著降低有效深度 |
| 比对 | Bowtie2 / bwa mem | 唯一比对优先、配对端参数 | 多比对 reads 的处理策略要一致 |
| 去重复 | Picard / samtools | 坐标是否跨读段 | DAP-seq 重复率天然高,去重尺度要统一 |
| Peak calling | MACS2 / SEACR / Genrich | 必须有 input 作为对照、q 值阈值、峰宽 | 不传 input 是最常见的数据事故 |
| Motif 发现 | HOMER / MEME / FIMO | 背景集、显著阈值、去冗余 | 不同工具给出的 top motif 可能不一致,要交叉验证 |
| 靶基因注释 | Homer annotatePeaks / 近端远端定义 | 启动子上游 2 kb、下游 1 kb | 远端增强子不要漏,要结合 ATAC/ChIP 数据 |
| 功能富集 | GO / KEGG | 背景集必须用全基因组或检测到的基因 | 背景集选错,p 值毫无意义 |
peak calling 的参数怎么定
最常见的做法是用 MACS2,配 input 作为对照,q 值阈值取 0.01 或 0.05。几个实操建议:
(1)q 值不要一味收紧。DAP-seq 的信号本身弱,如果把 q 值压到 0.001,可能几千个真峰都被砍掉。可行的做法是先跑一版宽松的 q=0.05,然后看 peak 数量的量级是否合理——一个 TF 通常给出几百到几千个 peak。如果出来几十个,可能太严;如果出来十几万,一定是背景没扣干净。
(2)峰宽(--bw)要匹配片段长度。文库片段是 200–500 bp,峰宽设成 200–300 比较合适。设成 50 会把一个真实结合区域切成碎片。
(3)不同 TF 之间要统一参数。这是整套 DAP-seq 最容易翻车的地方。如果 TF-A 用 q=0.05、TF-B 用 q=0.01,你就不能直接比较两者的 peak 数量来推断哪个结合更多。要么统一参数,要么各自取 FDR 相同但用 GSEA 那种"看排序不看绝对值"的思路来分析。
motif 分析:为什么要去冗余
HOMER 的 findMotifs 或 MEME 都能给出富集 motif。但这里有个必须做的操作:去冗余(--makeFasta / -noredundant)。
原因很简单:一个大 TF 结合域通常有几十个峰,每个峰都贡献一堆 motif 序列。如果你把所有峰序列直接扔进去,findMotifs 会返回一堆彼此高度相似的次优 motif,看起来像有二十个不同的结合模式,实际上只是同一个 motif 的各种变体。去冗余之后,你通常会看到三到五个真正有意义的 motif,这才是 TF 的真实结合模块组成。
从 motif 到靶基因:不要只看最近的那一个
如果你的 TF 结合的是启动子区,最近的基因通常就是靶基因。但很多 TF 结合的是远端增强子——距离 TSS 几十 kb 甚至几百 kb。这时候只用"最近的基因"做注释会完全漏掉真实靶基因。
改进方案:结合 ATAC-seq 或 ChIP-seq 的数据来找远端调控元件,然后再做三维基因组学关联(如 HiChIP / Hi-C / ChIA-PET)确定物理接触的靶基因。如果这些数据都没有,至少要在 Discussion 里承认这个局限性,不要过度声称。
08、非模式生物:这套方法最大的价值场景
搜"DAP-seq 非模式生物 物种 应用"的人,抓住了 DAP-seq 最大的差异化优势:它把"做 TF 结合图谱"这件事的门槛,从"需要抗体和转基因材料"降到了"需要一段 CDS 序列"。
这意味着:只要你能拿到某个物种的基因组和一个 TF 的 CDS 序列,你就能得到这个 TF 的结合偏好图谱。这对于水稻、玉米、大豆、番茄、葡萄、杨树、棉花、油菜这些作物,以及大量微生物物种,是决定性的。
大规模家族扫描:把"逐个研究"变成"一次扫描"
这类项目最有说服力的产出形式是全家族图谱。典型的执行路径是:
- 从基因组里鉴定出目标 TF 家族的全部成员(拟南芥里一个家族常有 50–150 个成员)
- 批量克隆 CDS,构建带 HaloTag 的表达载体
- 用同一份基因组文库,逐个做 DAP-seq
- 统一参数做 peak calling 和 motif 分析
- 横向比较:哪个成员结合哪种 motif,结合位点有多少,哪些靶基因重叠
第 5 步产生的信息量远超单个 TF 的研究。你会得到一张"家族成员 × 结合模块"的矩阵,直接告诉你哪些成员功能冗余、哪些发生了功能分化(motif 偏好不同)。这类图放在论文里非常有分量,而且审稿人很难质疑——因为它是体系性的,不是单点的。
物种特有的表型问题,DAP-seq 特别擅长回答
举几个真实场景:
(1)抗旱性主效基因的挖掘:一个 MYB 或 NAC 转录因子家族有 100 个成员,先用 DAP-seq 扫描出每个成员的靶基因集合,再与干旱胁迫下的差异表达基因取交集,交集大的成员就是优先候选。这比逐个做 Y1H 快几个量级。
(2)驯化选择的分子机制:把栽培种和野生种的同一 TF 序列分别做 DAP-seq,比较结合位点差异,结合群体遗传学定位驯化区间,能推断出"是哪个 TF 的哪种 motif 变化驱动了性状改变"。
(3)共生与病原互作:在微生物里,效应蛋白识别宿主靶基因的机制是核心问题。DAP-seq 可以快速筛出哪些转录因子是效应蛋白的潜在靶标。
一个必须写进 Limitations 的短板
DAP-seq 在作物上的应用有个绕不开的问题:你用的是哪个组织的基因组 DNA?
如果一个 TF 只在根里表达,而你的文库是从叶子的 DNA 做的,那么 DAP-seq 测的是"这个 TF 的结合域在叶子的 DNA 背景里喜欢什么序列",而不是"它在这个物种里做什么"。
更根本的一点:你需要有该物种高质量的参考基因组和可靠的基因组 DNA 提取。基因组组装质量差、重复序列多,都会直接损害比对率和 peak 质量。对于基因组质量堪忧的物种,DAP-seq 的数据质量天花板是肉眼可见的。
09、交付前的自查清单
下面这份清单是按"审稿人最可能挑刺的顺序"排的。
方法学描述(Methods)
(1)写清楚是 PCR-free 还是 ampDAP-seq 路线,两者不能混用比较
(2)写清建库方式、片段长度分布、起始 DNA 量、文库是否跨 TF 复用
(3)写清体外表达体系(reticulocyte / wheat germ)、每个 TF 的蛋白产量与活性验证方式
(4)写清结合缓冲液成分、盐浓度、金属离子、洗涤次数与盐浓度
(5)写清测序平台、读长、深度(基因组的几倍)、重复设置
(6)工具与参数全部写明版本号(软件 + 参数),这是可重复性的底线
数据质量
(1)input 对照已上机,且所有 peak calling 都用同一个 input
(2)各 TF 之间的 peak calling 参数完全一致
(3)peak 数量在合理量级(几百到几千),不是几十也不是几万
(4)top motif 去冗余后,数目收敛到 3–5 个
(5)top motif 与该 TF 已知的 DNA 结合域类型相符(如锌指 → C2H2 类 motif,bZIP → 变回文序列)
(6)生物学重复之间的 peak 重叠率(IDR 或直接算 Jaccard)达到可接受水平
结论强度
(1)全文用"体外结合偏好""候选结合位点",不用"直接调控""生理结合位点"
(2)至少做了一个维度的联合分析(ATAC-seq 交集 / RNA-seq 关联)
(3)至少做了 2–3 个位点的点对点验证(EMSA 或 Y1H,其中至少一个是 EMSA)
(4)没有只靠 DAP-seq 就下"直接结合"的结论
(5)远端增强子靶基因的讨论没有只依赖"最近的基因"注释
(6)功能富集的背景集用的是正确的全集或检出集
DAP-seq 的真正价值,不是"替代 ChIP-seq",而是把基因组层面的 TF 结合图谱从"少数物种、少数 TF"的状态,扩展到了"任何物种、任意 TF"的可能性。2016 年 O'Malley 等人在拟南芥里一次扫了近 400 个 TF,才有了后来作物领域大量 DAP-seq 项目的模板。
但它的边界也必须说清楚:DAP-seq 是"能结合"的证据,不是"在调控"的证据。体外世界没有染色质、没有辅因子、没有时空特异性。你从 DAP-seq 拿到的每一个 peak,都是一个待验证的假设,而不是一个结论。
所以最专业的用法,是把它放在证据链的上游——用它高效地产生候选,然后用 ATAC-seq、RNA-seq、EMSA、LUC、ChIP-qPCR 逐层收敛。这条链条上任何一环缺失,你的结论就会在审稿时被拆成"只是序列偏好而已"。
最新动态
-
11.04
DNA Pulldown避坑指南:从探针设计到质谱送样的零翻车实操手册
-
11.04
别再乱换试剂盒!Co-IP失败90%的坑,都藏在裂解前的样品制备里
-
11.04
别再盲目抄GAPDH、乱套2^-ΔΔCt公式!qRT-PCR从逆转录细节到统计规范的避坑手册
-
11.04
别再把DAP-seq错当ChIP-seq平替!从HaloTag表达质控、文库参数优化到证据链搭建的全流程
-
10.16
当Cq值不能直接比:荧光定量PCR中被误用的六个假设
-
10.16
噬菌体展示的工程学真相:库容、遗传漂移与淘洗压力之间的三角关系
-
10.16
CUT&Tag的真实门槛:从"一万个细胞起"到"可信图谱"之间那些没人写在protocol里的失败
-
10.16
ChIP-seq实验设计的六道关口:从交联参数到生物学结论之间的断层带
-
10.15
酵母双杂交筛库的质量控制:从诱饵可用性到阳性克隆归一化的实战判据
-
10.15
酵母质粒小提的性能边界:破壁效率、纯度诊断与下游用途匹配
 X