序列一致不等于交付合格:全基因合成的13道工程判据
这篇不解释基因合成是什么,也不复习碱基配对。默认你已经做过克隆、跑过表达、被测序峰图坑过。我们把整件事当成一条工程交付链:先把「什么叫合格」谈死,再倒推序列设计、Oligo 拆分、组装路线、宿主承载与验证深度,最后把返工成本算清楚。文中数值都是方法讨论里的典型量级,用来说明判读逻辑和取舍方向,不构成现成实验方案,落到自己的体系里仍需验证。合成厂交付的是一支管和一份图谱,而判断这份图谱能不能信,是下单方自己的事。
01、先把「合格」写进合同:交付标准倒推整条设计链
拿到一支甘油菌和一份测序图谱之前,最该先定下来的不是序列,而是「什么叫合格」。这事儿吧,大量返工并不是合成做错了,而是双方对合格的定义压根不在一个坐标系里。把验收条款写进需求单,等于把后面十二节的判据全部倒推了一遍:你要哪种验证深度,直接决定 Oligo 怎么拆、组装走哪条路、克隆用哪个宿主、以及最后愿不愿意为 NGS 买单。
验收条款必须落到可判的项上
一份能执行的交付标准至少覆盖四类:序列一致性、物理交付物、文件交付物、周期与责任。序列一致性要先写清楚比对的是哪条参考序列——带不带载体骨架、带不带两端酶切位点或同源臂、简并碱基按什么规则判定、出现 N 怎么处理;参比文件必须带版本号和哈希(比如提交当天序列文件的 md5),别用「以附件为准」这种模糊说法,否则三个月后谁也说不清哪个版本才是靶标。物理项包括质粒量(常规 2–5 µg,溶于 TE 或水,浓度不低于 100 ng/µL)、甘油菌或穿刺菌、抗性标记、宿主菌株,以及转染级需求下的内毒素(常见量级 < 0.1 EU/µg)与无菌、支原体项。文件项至少要有 GenBank 注释、ab1 峰图原始文件、COA 和所用测序引物列表——只给一张 PDF 序列图、不给 ab1,等于把复核能力交了出去。
周期也得拆开谈。1.5–3 kb、GC 正常的常规基因,10–15 个工作日是常见量级;超过 5 kb、含高 GC 或长重复的难度序列,20–30 个工作日甚至更久并不罕见。真正要在合同里锁死的是「加时与加价的触发条件」和「不合格时的返工责任」:合成错误、克隆过程引入的突变、参考序列本身写错,这三种归责完全不同,事前不切干净,事后就是扯皮。
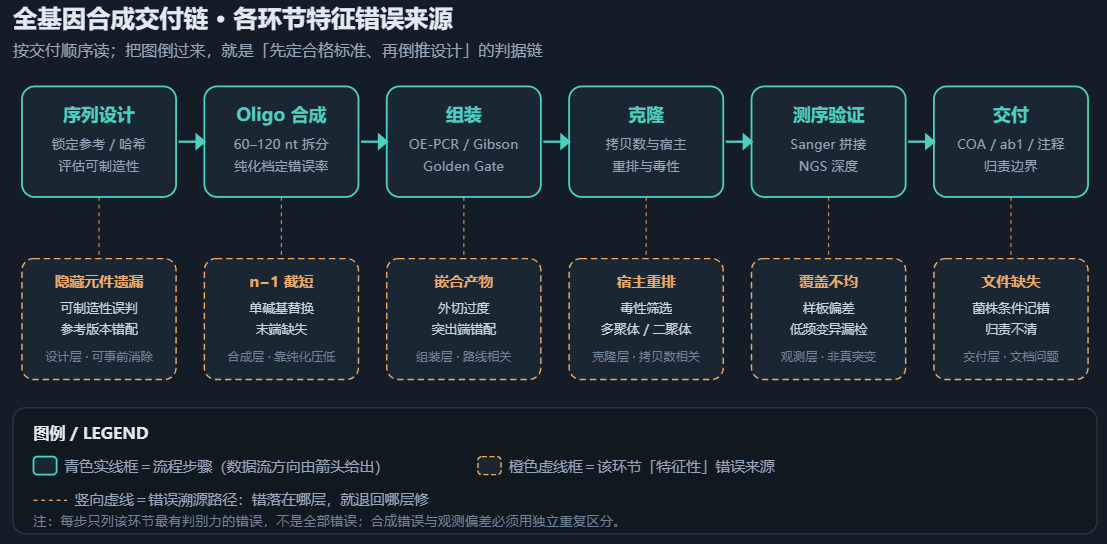
图 1|全基因合成交付链与错误来源图谱。每个环节旁边标的是该步骤「特征性」的错误,而不是全部错误:设计阶段丢的是功能元件与可制造性,Oligo 阶段堆的是末端缺失与单碱基替换,组装阶段冒出的是嵌合与缺失,克隆阶段是宿主重排,验证阶段才是「看不看得见」的问题。把图倒过来读,就是第 1 节的倒推逻辑。
把归责边界提前切干净
| 质检项 | 典型判定阈值 | 证据文件 | 触发返工的条件 |
|---|---|---|---|
| 全长序列一致性 | 与锁定参考序列 100% 一致,含侧翼与酶切位点 | 拼接 contig + 峰图/比对报告 | 任一非简并位点替换、插入、缺失 |
| 插入方向与读框 | 方向正确、ORF 无移码、无内部提前终止 | GenBank 注释 + 双酶切图谱 | 反向插入、读框错位、接头残留 |
| 末端完整性 | 两端各 ≥ 20 bp 与参考一致,无截短 | 两端测序读长覆盖 | 末端碱基缺失、接头连带缺失 |
| 质粒量与浓度 | 2–5 µg,≥ 100 ng/µL,A260/280 1.8–2.0 | 定量报告 + 电泳图 | 总量不足、RNA 污染、明显降解 |
| 内毒素(转染级) | < 0.1 EU/µg | 鲎试剂检测报告 | 超标或未提供检测 |
| 参考版本与哈希 | 版本号 + md5 与需求单一致 | 参比序列文件 | 版本不符、简并位点规则未约定 |
还有一个常被忽略的点:交付的到底是「原始序列」还是「经密码子优化后的序列」。两件事都合理,但如果你按野生型序列设计好了下游引物、探针或 CRISPR 靶点,拿到手的却是优化版,整套检测就得重做。所以需求单里必须显式声明交付序列与设计序列的映射关系,以及优化是否允许改动氨基酸以外的任何位点。判读顺序也定死:先核对参考版本与哈希,再核对比对边界,然后才看一致性百分比,最后才谈功能。
02、可制造性评估:下单前把 GC、重复与发夹标在序列图上
序列丢给合成厂之前,自己先跑一遍可制造性评估,性价比最高。别急着下结论说「这段能合成」,先把几个维度的数值摊在序列坐标轴上:全局 GC、局部 GC 极值、正向与反向重复、低复杂度区、以及二级结构自由能。这些不是玄学指标,它们分别对应寡核苷酸合成时的偶联效率下降、组装时的错配与滑动、聚合酶在模板上的停顿,以及克隆后在大肠杆菌里的重组缺失。
各个维度的报警线
全局 GC 在 40%–60% 属于舒适区,超过 65% 或低于 25% 就该亮黄灯。但真正坑人的是局部:以 50–100 bp 为窗口、10 bp 为步长滑一遍,某个窗口 GC > 80% 或 < 20%、连续 G/C ≥ 6、同碱基 homopolymer ≥ 8–10(尤其是 GGG 串联形成的 G4 四链体 motifs),都比全局均值更有预测力。重复维度要同时看单元长度与间距:正向或反向重复 ≥ 12 bp、同一单元重复 ≥ 3 次、且两份拷贝间距 < 200 bp,在组装和质粒扩增中特别容易发生 slipped-strand 错配或 RecA 依赖的重组。二级结构看茎长 ≥ 8 bp、环 4–8 nt、最小自由能 ΔG 落到 −9 至 −12 kcal/mol 以下(37℃、近生理离子强度近似)的发夹,这类结构会让聚合酶与连接酶都变慢。低复杂度区用序列熵或 DUST 类打分卡一下即可,别让一整段 Gly-Ser linker 或 poly-A 编码区悄悄堆满错配。
- 必须保留的结构先圈出来:启动子、ribozyme、ITR、复制子、核糖体结合位点、以及故意设计的重复编码序列,先标记为「不可动」,再谈优化。
- 参数要跟体系对齐:折叠预测的溫度、Na⁺/Mg²⁺ 浓度若和组装反应差一个量级,算出来的 ΔG 参考价值有限,别拿默认参数当结论。
- 输出要带坐标:合格的评估报告给的是「第 412–466 位 GC 84%、第 780/802 位一对 14 bp 反向重复」,而不是一句「高 GC,建议优化」。
口语提示报「这段合成不了」之前,先自己把滑窗曲线和重复点阵拉出来看一眼。很多时候不是整条序列难,就是某一两处 30 bp 的极端窗口在拖后腿,打散那十几个碱基就够了,犯不上把全长重设计一遍。
评估结论怎么转成设计动作
评估的产出应当是一张带坐标的「风险表」,每一项挂一个动作:可同义替换打散的、必须保留但可换组装路线的、以及必须保留且只能靠纯化等级和测序深度硬扛的。举例说,一段 68% GC 的 5′ 区若同时承担翻译起始功能,宁可用松弛折叠的同义替换去降 ΔG,也不要动它的氨基酸序列去换 GC;一段必须保留的串联重复,与其反复优化,不如在拆分时把重复区整体放进同一条 Oligo、避免跨重复设重叠。判读逻辑是:先分类,再定动作,最后才回写序列。反过来先改序列再评估,往往优化了 A 处、在 B 处造出新的发夹,来回打转。
03、密码子优化远不止同义替换:CAI、稀有簇与 5′ 折叠的拉扯
把密码子优化理解成「查表换成高频密码子」,挺容易翻车的。它其实是个多目标约束问题:宿主 tRNA 丰度、翻译速率剖面、mRNA 二级结构、GC 分布、可制造性、以及隐藏功能元件,彼此是互相拉扯的。目标函数定错,CAI 拉到 0.98 也可能比 0.85 表达得更差,甚至整条蛋白进包涵体。
CAI 不是越高越好,宿主表更要选对
CAI 的实用区间一般落在 0.8–0.95,追到接近 1.0 往往意味着全篇使用最偏好密码子,结果是对应 tRNA 被快速耗竭、核糖体在高频密码子簇上排队,翻译 elongation 反而失去节奏。更基础的错误是拿错偏好表:大肠杆菌 K-12 与 BL21(DE3)、毕赤酵母与酿酒酵母、CHO 与人源细胞系的密码子使用谱并不通用,用人的表去优化原核表达,等于系统性引入一堆低频密码子。稀有密码子簇也别一律清掉——连续 2–5 个使用频率 < 10%–15% 的密码子,常出现在结构域边界和 linker 附近,起到给共翻译折叠留时间的作用;把它们全换成高频密码子,表达量可能上去了,可溶性却塌了。取舍理由是:慢速区段是翻译速率剖面的一部分,不是需要消灭的噪声。
5′ 端折叠与 GC 的冲突
起始区(从 RBS 或 Kozak 到 +30 左右,约前 30–50 nt)对 mRNA 折叠最敏感,这一段若形成稳定茎环、把起始密码子或 SD 序列包进茎里,起始效率会断崖式下降。工程上常把这一窗口的折叠自由能约束在较松的范围(例如不形成 ΔG 低于 −5 至 −6 kcal/mol 的稳定结构),必要时用同义替换把茎打断。可一旦开始同义替换,就会撞上 s2 的指标:把 GC 压回 45%–60% 常常和「用最优密码子」直接冲突,而优化又可能新造出内部酶切位点(BsaI、BsmBI、EcoRI 一类),把后面 Golden Gate 的路线堵死。所以优化必须回灌可制造性评估:每改一版,重跑 GC 滑窗、重复点阵、发夹 ΔG 和内部位点扫描,而不是优化完就封版。
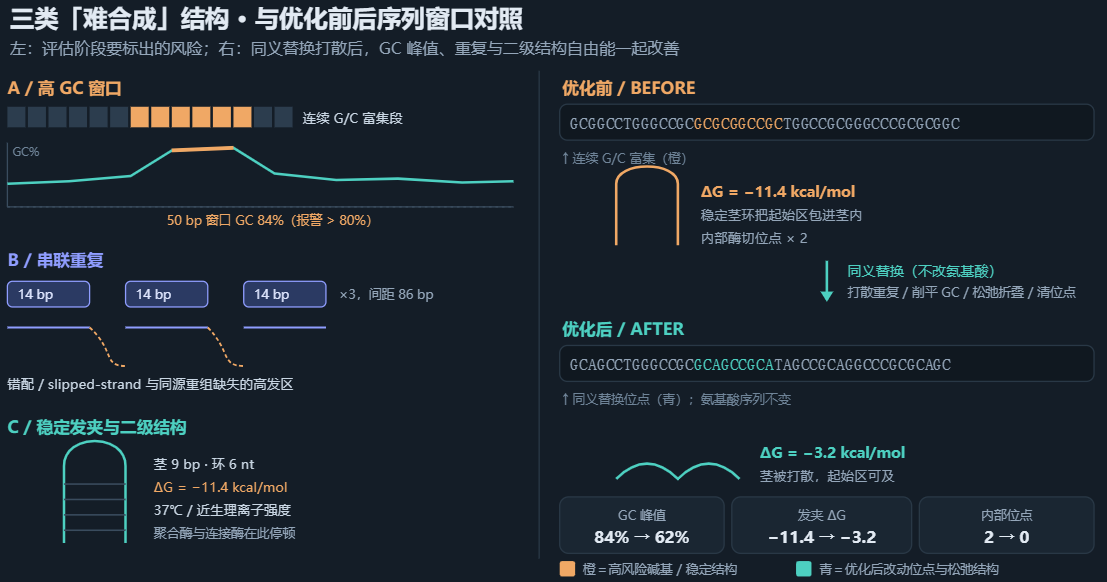
图 2|三类难合成结构及其优化前后对照。左侧是评估阶段要标出的高 GC 窗口、串联重复与稳定发夹;右侧是同一序列窗口经同义替换后的结果:GC 峰值被削平、重复被打散、茎区自由能明显上移。注意优化动作只改了碱基、没动氨基酸,且改完必须重新扫描内部酶切位点与新的低复杂度区。
还要一起算进去的几项
- 密码子对偏好与二核苷酸频率:CpG、UpA 的占比会影响先天免疫识别与 mRNA 稳定性,哺乳动物表达与疫苗类构建尤其要盯。
- 内部 SD 样序列:原核体系里编码区内部出现 Shine-Dalgarno 样 motif 会造成核糖体暂停与截短产物。
- RNase 切割相关序列:大肠杆菌里富 A/U 的单链区段与 RNase E 偏好位点会缩短 mRNA 半衰期。
- 多解与可复现性:优化算法常带随机性,同一条序列两次跑出不同结果;需求单里应固定工具版本、权重与随机种子,否则交付序列无法复现。
一句话收口:优化的输出不是「一条更漂亮的序列」,而是一份带约束满足清单的设计说明——CAI 落在哪个区间、5′ 折叠 ΔG 是多少、哪些稀有簇被刻意保留、内部位点是否清零、GC 与重复有没有回弹。缺了这份说明,表达量一旦不达标,你连该往回查哪一步都不知道。
04、隐藏功能元件清理:不编码却能让表达崩掉的序列
序列过了可制造性这一关,还有一类坑不体现在 GC 曲线上:那些不改变氨基酸、却自带调控含义的短 motif。老实讲,很多「表达量莫名其妙低」「Western 上出现一条截短带」的案例,追到最后都不是密码子没优化好,而是编码区里藏了一段宿主读得懂的信号。
按宿主分开扫,别用一张清单包打天下
原核表达要重点扫四类:一是启动子样序列,−35 区 TTGACA 与 −10 区 TATAAT、间隔 16–18 bp 的组合,落在编码区内部会启动反义或内部转录,带来截短产物与代谢负担;二是 rho 非依赖终止子样结构,一段 7–9 bp 的 GC 富集茎环紧跟 ≥ 6 个 T,会让转录提前收尾;三是内部 SD 样 motif 与内部起始密码子,造成核糖体暂停或产生 N 端截短的异构体;四是宿主菌株相关的泄漏元件,比如 BL21(DE3) 体系里内部 T7 启动子样序列会诱发本不该有的表达。真核表达则换一套重点:隐蔽剪接供体 GT/受体 AG、分支点 A 与多聚嘧啶区,polyA 信号 AATAAA 及其变体 ATTAAA、AU/CU 富集的不稳定元件(如 AUUUA 串联),以及未甲基化 CpG 与免疫刺激基序——CpG 二核苷酸密度升高会通过 TLR9 通路影响先天免疫,在 DNA 疫苗、病毒载体和部分瞬时转染体系里是硬约束。
清理动作与优先级
- 先确认「不可动」元件:IRES、WPRE、ribozyme、ITR、loxP/FRT、以及故意保留的调控序列,一律先锁死再谈同义替换。
- 按表达宿主给 motif 清单排权重:原核先清内部启动子与终止子,真核先清隐蔽剪接与 polyA,载体生产场景额外盯 CpG。
- 每一次同义替换后重跑整套扫描:把
AATAAA打散很可能在别处拼出新的ATTAAA,把高 CpG 压下去又可能抬升 GC 或造出新的发夹。 - 顺手清一遍下游要用到的酶:BsaI、BsmBI、SapI、EcoRI、XhoI 等识别位点,以及测序引物结合区里的二级结构。
这里有个挺反直觉的失败模式:真核密码子优化常常偏向人源高频密码子,结果把 CpG 和隐蔽剪接位点一起抬了上去,表达盒在 HEK 或 CHO 里反而被先天免疫或错误剪接拖垮。所以清理不是优化的收尾,而是和优化并行的第三套约束。判读上建议把「扫描—替换—重扫」做成闭环,输出一张带坐标的 motif 清单,标出每个位点被保留或清除的理由;否则一旦出现截短条带,你根本分不清是蛋白酶切、提前终止,还是内部启动子在作怪。
05、Oligo 拆分与合成质量:重叠区、片段长度与末端错误预算
序列定稿后进入拆分。这一步的目标不是「切得整齐」,而是把错误预算和组装风险一起分下去:哪条 Oligo 承担多长、重叠落在哪、纯化等级选哪档,直接决定后面要挑多少个克隆、测多少条才有机会拿到一支完全正确的。
长度、重叠与末端的取舍
化学合成的单步偶联效率典型在 99.0%–99.5%,一条 120 nt 的 Oligo 理论全长正确比例只有 0.995120 ≈ 55% 量级,60–90 nt 的区段则明显更干净——所以常规拆分把单条控制在 60–120 nt,超过 120 nt 就该问一句值不值。重叠区长度按路线定:OE-PCR 常用 15–25 bp,Gibson 需要 20–40 bp,Golden Gate 靠 4 bp 突出端、根本不设长重叠。重叠的 Tm 建议落在 60–68℃、GC 40%–60%,并且绝不压在重复区、极端 GC 窗口或稳定发夹上,否则退火时不是错配就是干脆不延伸。片段长度分布也要尽量均匀,一条 200 nt 配一条 40 nt 的组合,短片段在反应中会被外切酶或PCR偏倚吃掉。高风险区(长重复、G4、高 GC 茎)宁可整体塞进同一条 Oligo 内部,也别让它横跨重叠或落在 3′ 末端。
纯化等级决定基线错误率
合成产物里最主要的错误是 n−1/n−2 截短(尤其 5′/3′ 末端)和内部单碱基替换;末端截短进了组装体就是缺失或移码,比内部替换更致命。不同纯化档对应的可用全长比例差别很大,这是选档的核心依据:
| 纯化方式 | 全长产物富集 | 单碱基错误率量级 | 适用场景 |
|---|---|---|---|
| 脱盐(Desalt) | 低,截短与失败序列占比高 | 约 1/100 – 1/200 | 普通 PCR 引物、筛选探针 |
| OPC / cartridges | 中 | 约 1/200 – 1/400 | 常规克隆、短片段组装 |
| HPLC | 较高,对 n−1 分离好 | 约 1/300 – 1/600 | 长片段组装、定点突变库 |
| PAGE | 高,长度分辨率最好 | 约 1/400 – 1/1000 | 长 Oligo、高保真拼接 |
| PAGE + HPLC 双纯 | 最高 | 可达约 1/1000 量级 | 难度序列、突变体库骨架 |
| 芯片合成 Oligo 池 | 需靠 NGS 或酶法纠错 | 约 1/100 – 1/1000 | 大规模库、需后续筛选 |
把量级代进一个 3 kb 基因算笔账:用约 40 条 80 nt 的 Oligo,总合成量 3200 nt,即便按 1/400 的错误率,初始产物里也期望有 8 个左右的错碱基——换句话说,「一次拼出来就 100% 正确」本来就是小概率事件。工程上的正确姿势是把它当成统计问题:要么提高纯化档 + 减少 Oligo 数,要么靠挑单克隆 + 全长测序去筛出正确克隆,要么引入体外错配纠错(错配内切酶处理、或把片段打散重拼)。这事儿吧,把纠错写进流程是默认项,不是出了错才补的救火动作。另外提醒一句,芯片合成的 Oligo 池浓度极不均一、错误率也更高,直接拿来拼长基因而不做 NGS 预筛,后面覆盖度会很难看。
06、组装路线选型:OE-PCR / Gibson / Golden Gate 的边界与翻车模式
路线选型没有「最好」,只有「这条序列、这个片段数、这套下游用途下最不容易翻车」。说白了,选路线就是在选错误的可控性:哪类错误会出现、出现了能不能被测序抓到、返工要退回到哪一步。
三条主线的机制边界
OE-PCR(重叠延伸)靠 15–25 bp 重叠先互为引物延伸、再用外侧引物扩增,不加外源酶、成本最低,适合 ≤ 2–3 kb、由少数几条 Oligo 先拼小段的场景。它的天花板是 PCR 本身:片段数一多、模板一复杂,嵌合产物和引物二聚体就指数级冒出来;高 GC 与稳定发夹会让聚合酶停顿,产出截短体;哪怕用高保真酶(约 10−6/碱基/循环量级),30 循环扩 3 kb 也会积累可观的 PCR 引入突变。Gibson 用 T5 外切酶从 5′ 端啃出 3′ 单链突出、互补片段退火后由高保真聚合酶补平、Taq 连接酶封口,典型 50℃、15–60 min 一锅;需要 20–40 bp 重叠,一次拼 2–6 个片段、总长做到 10 kb 以上都不夸张。它的失败几乎都出在末端:外切酶过量或孵育过久把单链啃过头、重叠 Tm 太低或有二级结构、片段里残存的盐/EDTA/引物抑制酶活、以及重复序列导致的错配组装。Golden Gate 用 Type IIs 酶(BsaI、BsmBI、SapI)在识别位点之外切出可编程的 4 bp 突出端,一锅温度循环(如 37℃ 切割 / 16℃ 连接交替 30 循环,末尾 50–65℃ 失活)同时完成消化与连接;突出端序列决定片段顺序与方向,可一次拼十几个片段,天然适合层级化与标准化。代价是必须先做 domestication——把片段内部所有同类 Type IIs 位点用同义突变清干净,否则片段会被从中间切断。
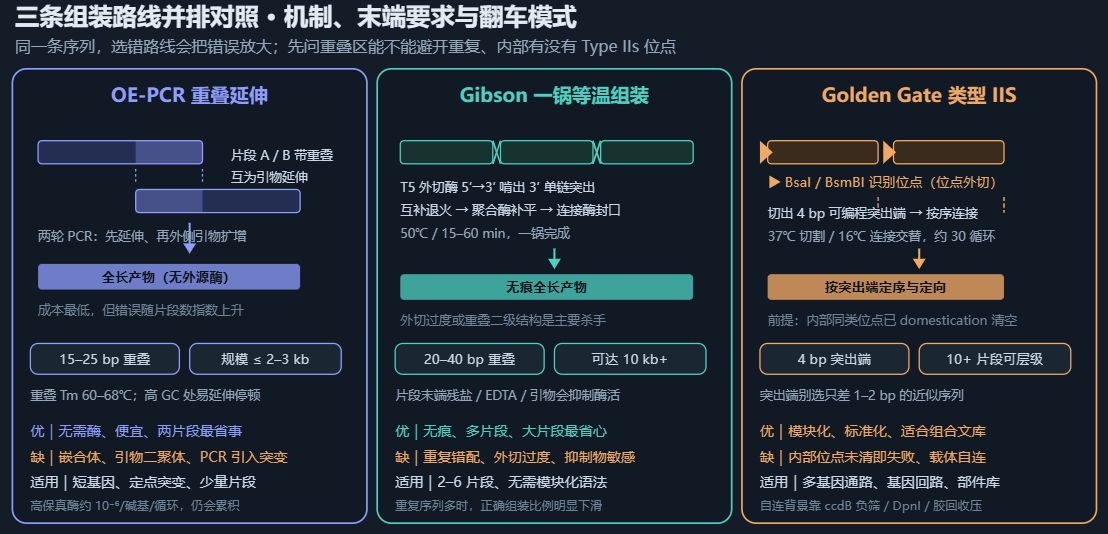
图 3|三条组装路线的机制与边界对照。左中右分别是依赖重叠延伸的 OE-PCR、依赖 5′ 外切酶产生单链突出的 Gibson、以及依赖 Type IIs 在识别位点外切出 4 bp 突出端的 Golden Gate;右侧对比栏归纳了各自的片段规模、温度条件与最典型的失败模式。选型时先问「内部有没有 Type IIs 位点」「重叠能不能避开重复区」,再谈效率。
一张对照表把边界钉死
| 路线 | 末端要求 | 关键酶 / 条件 | 规模上限(量级) | 特征失败模式 |
|---|---|---|---|---|
| OE-PCR | 15–25 bp 重叠 | 高保真 PCR 酶,两轮扩增 | ≤ 2–3 kb,≤ 6–8 片段 | 嵌合体、引物二聚体、PCR 引入突变 |
| Gibson | 20–40 bp 重叠 | T5 外切酶 + 聚合酶 + Taq 连接酶,50℃ | 2–6 片段,可达 10 kb+ | 外切过度、重复错配、末端抑制物 |
| Golden Gate | 4 bp 突出端,需先清内部位点 | BsaI/BsmBI 等 Type IIs + T4 连接酶,温度循环 | 10+ 片段,可层级化 | 内部位点未清、突出端错配、载体自连 |
| 连接酶法 / LCR | 黏末端或 bridging oligo | T4 连接酶 / 耐热连接酶 | 少片段、位点依赖 | 平末端效率低、自连、多拷贝串联 |
几个落地判断:片段里有重复,优先 Golden Gate 或把重复整体放进同一片段,别用长重叠的 Gibson 去硬碰;要无痕、要一次拼多个大片段,Gibson 最省心;要做模块化、多基因通路、组合文库,Golden Gate 的突出端语法几乎不可替代,前提是先把内部位点 domestication 做干净;只有两三个短片段且预算紧,OE-PCR 足够。还有一条容易被漏掉的判据:Golden Gate 的突出端别选彼此只差 1–2 bp 的近似序列,也别用回文突出端,否则错配和自连会让正确克隆比例断崖下跌;载体自连背景要靠 ccdB 负筛选、DpnI 处理或胶回收压下去,不能只靠蓝白斑碰运气。
07、分级组装:从长片段到多基因通路与基因回路
片段一多,一次拼完就是跟概率对着干。踩过坑的都懂:单次连接里每多一个片段、每多一个接头,正确产物的比例是乘性往下掉的,而不是线性。假设每个接头的正确连接概率 0.9,十个片段一步到位只剩 0.99 ≈ 0.39;换成两层分级、每层只处理 3–4 个片段,每层的正确率都在 0.7 以上,整体反而更稳,而且错在哪一层可以直接定位、只重做那一层。
层级怎么切,接头怎么给
常见切法是四级:Oligo → 0.5–1.5 kb 的模块(block/Level 0)→ 3–6 kb 的完整转录单元(启动子+RBS+CDS+terminator,Level 1)→ 10–30 kb 的多基因通路或操纵子(Level 2)→ 更大的 BAC/酵母体内组装。关键在于每级用不同的酶与突出端语法,比如 BsaI 拼 Level 0、BsmBI/BpiI 拼 Level 1,交替使用避免跨层串扰;每级之间留一个固定的测序验证点,别把错误一路带到顶层再回头拆。模块化的另一半是部件标准化:把启动子、RBS、CDS、terminator 当成带标准 4 bp 融合位点(scar)的 part,接头方向定死,任何组合都能按同一套语法复用。做组合文库时这套语法的价值会放大——换个 CDS 不用重设计整条通路。
多基因通路的额外约束
- 表达平衡而非各自最强:通路里每个酶的比活、周转数不同,全部上最强启动子往往堵在中间代谢物、拉高负担;用启动子强度梯度、RBS 强度与拷贝数配平,比逐个拉满更有效。
- 转录读穿与极性效应:操纵子下游基因常被上游 terminator 强度影响,基因顺序不是随便排的,必要时给每个基因独立启动子 + 强 terminator 做绝缘。
- 同源重复是重排温床:多个相同启动子、terminator、linker 或重复 CDS 会在宿主里同源重组缺失,能换序列就换、不能换就拉开间距并改用低拷贝宿主。
- 大片段换体系:超过 20–30 kb 时,酵母体内同源重组(30–60 bp 同源臂)常比体外连接省力,但它的软肋正是串联重复会被重组缩短,重复多的构建反而要慎用。
口语提示分级最实在的好处其实不是「拼得更长」,是「错得起」。某一级测序不对,你只需要退回那一级重拼一个 block,顶层和其他分支全部保留;一步到位的构建一旦发现错,基本等于从 Oligo 重来。
基因回路再多一层麻烦:正反馈、负反馈、toggle 这类拓扑对拷贝数和宿主负担极其敏感,同样的 part 换到高拷贝载体上,开关阈值可能整体漂移。所以回路构建要把「绝缘」当正式设计项——强 terminator、ribozyme 自切产生固定 5′/3′ 端、绝缘子隔开相邻转录单元——并且把 chassis(宿主菌株、生长速率、质粒拷贝数)写进设计文档,不能只交付一张元件图。分级交付的验收也该分级:每一级中间体留酶切指纹与两端测序,顶层再做全长与功能验证,任何一级不合格都不许往下一级流。
08、克隆与宿主负担:拷贝数、毒性序列与大肠杆菌重排
序列拼对了,进宿主还可能被改写一遍。别被数字骗了——「测序 100% 一致」只说明你测的那管质粒对,不代表这一构建在扩增过程中稳定,更不代表换个人、多传两代还一样。拷贝数、毒性、宿主重组背景,这三件事共同决定你拿到的是目标质粒,还是被选择压力筛出来的「活下来的突变版」。
拷贝数先按毒性定,而不是按产量定
常见复制子的拷贝数量级差得很远:pUC 类高拷贝可以到 500–700 拷贝/细胞,pBR322 类约 15–20,pSC101 低拷贝约 5,BAC/F 因子 1–2。很多人默认选高拷贝图个质粒产量,可一旦 CDS 有毒性(跨膜蛋白、核酸酶、毒素、强疏水片段)、或带强启动子有泄漏表达,高拷贝就是给细胞上刑,结果往往是挑出来的克隆全带缺失、移码或启动子失活突变——不是合成错,是细胞把「表达它」的个体淘汰了。对策是成套的:换低拷贝复制子、用严谨型调控(lacIq、tet、trp 加葡萄糖阻遏)、把诱导温度降到 25–30℃、缩短诱导时间、必要时换无细胞表达或改用耐受菌株。判读信号很直接:转化平板菌落明显偏小、液体培养长得慢、小量制备产量骤降、测序峰图在 CDS 里出现套峰,基本都指向毒性或不稳定。
不稳定重复与宿主重排
大肠杆菌里的 RecA 依赖同源重组最爱的底物是 ≥ 10–12 bp 的完全正向/反向重复、长串联重复、回文、以及能形成 Z-DNA 或 G4 的序列。含 LTR、ITR、病毒重复区、长 Gly-Ser linker 或镜像重复的构建,用普通 DH5α 扩增、37℃ 摇过夜、再传几代,很容易看到质粒变小、酶切指纹多出条带。工程上的组合拳是:用 recA−/endA− 且专门筛过稳定性的菌株(Stbl3、SURE、XL1-Blue 一类)、培养温度压到 25–30℃、减少传代次数、从甘油菌直接接种而不做中间饱和培养、以及避免长时间静置的饱和菌液。大质粒(> 10 kb)转化效率会掉一个量级,电转通常比化学转化靠谱;另外 Dam/Dcm 甲基化与某些限制酶、以及 CpG 甲基化状态会影响后续酶切与转染,宿主背景要和需求单一起记下来。
- 拿到货先做三件事:重新转化单菌落、小量制备、双酶切指纹 + 两端测序,确认没在扩增里被重排,再谈表达。
- 看指纹别只看「一条带」:多聚体、二聚体、开环与线性构型会伪装成大小异常,配合单酶切线性化一起判。
- 把宿主写进交付项:菌株、复制子、抗性、培养温度与传代次数都是可复现性的一部分,缺了这些,别人拿到同一支菌也可能养出不同结果。
一个很典型的翻车链是:高拷贝载体 + 毒性 CDS + 37℃ 过夜 → 平板挑到的全是失活突变体 → 测序显示「与设计不符」→ 误判为合成错误去返工。其实序列从合成那步就是对的,错的是克隆策略。把 s9 的判读逻辑接上就能分开:如果多个独立克隆在同一位点出现不同突变,多半是选择压力下的宿主重排;如果所有克隆共享同一个突变,反而要回头查 Oligo 或 PCR 的样板偏差。
09、序列错误的来源谱:把「样板偏差」和真突变分开
到验证之前,得先有一张「错误从哪来」的地图,否则看到不一致就只会怪合成厂。错误大致分四层:合成层(n−1 截短、单碱基替换,见第 5 节)、组装层(PCR 引入、嵌合、外切过度、突出端错配)、克隆层(宿主重排、选择压力筛出的失活突变,见第 8 节)、以及最容易被当成「真突变」的观测层偏差。把这四层分开,是纠错的前提。
「样板偏差」到底是什么
这个词指的是:你测到的信号并不忠实代表原始分子群体。最常见的来源是 PCR 后的克隆偏倚——如果连接产物里只有少数几个模板分子被有效扩增,随后挑的 6 个单克隆其实全是同一两个模板的后代,六个克隆共享同一个「突变」,看着像铁证,其实是一次早期错误的放大。同类问题还有模板切换(template switching)造成的嵌合读段、PCR duplicates 让 NGS 把同一错误数了很多遍、以及质粒群体本身异质(一管里混着几种不同质粒)导致峰图套峰。判别办法不复杂:用独立的起始扩增、挑来自不同连接/转化事件的克隆、双向测序、必要时加 UMI 做共识序列;如果换一批独立克隆后那个「突变」消失了,它就是样板偏差,不是序列错误。
口语提示看到峰图里一个漂亮的杂合小峰,先别急着写「发现低频突变」。homopolymer、高 GC 窗口、强二级结构处本来就容易出峰型压缩和信号衰减,同一段换个方向、换条引物重测,很多「突变」当场就消失了。
观测层还有哪些系统性坑
- Sanger 的分辨率下限:单次读长 600–900 bp,次要成分低于约 15%–20% 时几乎读不出,所谓「100% 一致」其实只对主峰成立。
- NGS 的覆盖不均:GC 偏倚、低复杂度区、index hopping 会让某些窗口深度掉到几十×甚至更低,深度不够的地方报「无突变」是没有说服力的。
- 低频变异与测序错误的混淆:平台单碱基错误率约 0.1%–1%,要可靠检出 1% 的变异通常得上 ≥ 1000× 有效深度,检出 0.1% 则要 ≥ 10000× 并配合 UMI/双链一致序列压背景,否则「低频变异」就是噪声。
- 比对参考选错:拿优化后序列去比原始设计、或参考里带简并碱基却按确定碱基判,会凭空造出一批「不一致」;参考版本与哈希要和第 1 节锁定的一致。
错误率在片段上也不是均匀的:两端、重叠区、高 GC 窗口、以及 Oligo 末端附近通常更高。把这件事画成沿坐标的曲线(见第 10 节图 4 右下),就能反过来指导验证资源的分配——高风险窗口多测几条、多要一些深度,低风险区按常规覆盖即可。工程上真正该追求的不是「零错误」这种口号,而是把每一类错误都挂到一个可复现的检出手段和一条明确的返工路径上:合成错退回拆分与纯化档,PCR 错换酶/降循环数,克隆错换宿主与拷贝数,观测错换独立重复与双向测序。
10、验证策略:Sanger 拼接、NGS 深度与 100% 一致仍不够的情形
验证不是最后盖个章,而是决定「这份图谱能不能信」的独立环节。说句实在的,很多争议都出在把「测过」当成「测够」:只做了两端 Sanger 就宣称全长正确、或者拿 200× 的 NGS 数据去谈低频变异,结论都站不住。合理的策略是分层,每一层回答不同的问题。
Sanger 拼接与酶切指纹
全长 Sanger 靠 primer walking:单次可靠读长 600–900 bp,相邻测序引物之间留 ≥ 100–150 bp 重叠,双向覆盖,3 kb 的插入通常要 4–6 条反应(两端用载体通用引物,中间加 walking 引物)。判读不只看碱基,还要看峰图质量:主峰 QV ≥ 30 的可信区段、无套峰、无 signal drop、homopolymer 后信号能恢复;两端各 ≥ 20 bp 与参考一致,简并位点按第 1 节约定的规则处理。酶切指纹是便宜且不可替代的一关:双酶切后插入片段大小与预期差在 ± 5%–10% 以内、条带数正确,能一次排掉大片段缺失、重排、多聚体和错误插入——这些结构变异短读长测序未必看得出来。
NGS 的深度与均一性
轮到 NGS,先问「要检出的下限是多少」。平台单碱基错误率约 0.1%–1%,所以报 1% 的低频变异至少要有 ≥ 1000× 的有效深度,报 0.1% 则要 ≥ 10000× 并配合 UMI 或双链一致序列把背景压下去;只看平均深度不够,还要查覆盖均一性——最低窗口深度建议不低于平均值的 20%–30%,重叠区、高 GC 窗口、低复杂度区这些地方最容易掉深度。比对参考必须锁定版本与哈希,homopolymer 附近的 indel 判读要格外保守,变异等位基因频率要跟独立重复一起看。把沿坐标的深度画成柱状、把错误率画成折线(下图右侧),比一句「平均 3000×」信息量大得多。
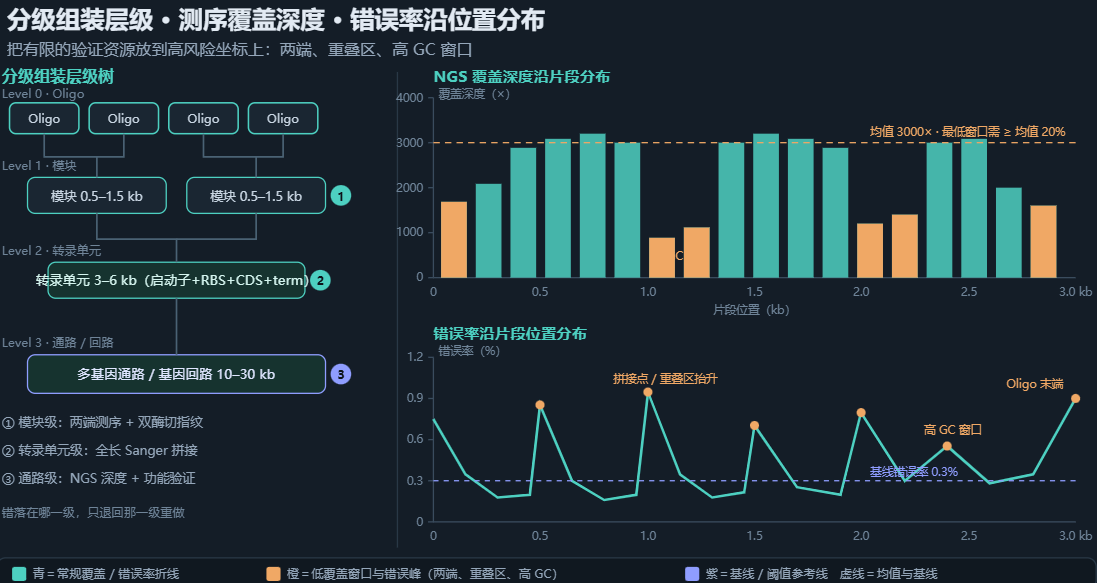
图 4|分级组装、验证覆盖与错误分布的合视图。左:Oligo→模块→转录单元→通路的分级树,每一级之间设一个测序验证点;右上:沿片段坐标的 NGS 覆盖深度柱状图,可见高 GC 窗口与两端深度明显下探;右下:错误率随位置变化的折线,重叠区与 Oligo 末端附近抬升。三者合起来回答一个问题——把有限的验证资源优先放在哪些坐标上。
| 手段 | 分辨能力 | 有效检出下限 | 成本/周期量级 | 主要盲区 |
|---|---|---|---|---|
| 菌落 PCR + 双酶切指纹 | 插入有无、大片段长度 | 几十 bp 以上 indel | 最低,当天 | 点突变、小 indel、低频异质 |
| Sanger primer walking | 主序列单碱基 | 次要成分约 15%–20% | 低,1–2 天 | 低频变异、大结构重排 |
| NGS 常规深度(≥ 1000×) | 单碱基 + 1% 量级低频 | 约 1% | 中,2–4 天 | 覆盖不均窗口、重复区比对 |
| NGS + UMI 深度(≥ 10000×) | 0.1% 量级低频 | 约 0.1% | 较高,含建库 | 同源重复区的结构变异 |
| 功能验证(表达/活性) | 产物是否有功能 | 体系依赖 | 高,数天起 | 不定位具体错因 |
100% 一致仍然不够的几种情形
- CDS 全对,但第 4 节那些隐藏元件没清:内部剪接、提前 polyA、内部启动子照样让蛋白截短。
- 只比对了插入片段,载体骨架上的启动子、ori、抗性、调控区突变没测,功能却归咎于「合成序列」。
- 序列一致但密码子优化改变了共翻译折叠,可溶性、活性、修饰状态全变了——序列对不等于产物对。
- 群体异质:主流分子正确、少量错误质粒共存,短读长和 Sanger 都容易漏,功能实验却会露馅。
- 大片段结构变异(重复缺失、倒位、多拷贝串联)在短读长比对里可能被「拉平」,要靠酶切指纹、长读长或 Southern 补证。
所以分层的正确顺序是:初筛(菌落 PCR + 酶切)→ 全长 Sanger 拼接 → 需要谈低频/异质性时上 NGS → 最终用功能验证兜底。任何一层只回答它能回答的问题,越界下结论就是给自己埋雷。
11、突变体库与高通量设计:库容量、覆盖度与筛库代价
从单基因跳到突变体库,工程量不是加一点,是换了一套算术。核心问题变成三个数:理论库容有多少、实际转化能拿到多少独立克隆、以及筛选通量够不够把它们看一遍。划算不划算,得算——很多库设计得挺漂亮,最后卡在转化量或筛不动上。
简并密码子决定理论库容
单点饱和突变常用的 NNK/NNS 是 32 个密码子、覆盖 20 种氨基酸加 1 个终止(TAG),NNN 是 64 个且含 3 个终止、冗余严重、氨基酸分布极不均。所以「更少密码子、更少终止」的方案更受欢迎:NDT/VHG/TGG 混合的所谓 22-codon 策略能用 22 个密码子覆盖 20 种氨基酸且不带终止,NDT 单独则 12 个密码子覆盖 12 种氨基酸。要注意 NNK 本身也有偏:Leu/Arg/Ser 各占 3 个密码子,Met/Trp 各 1 个,最高与最低氨基酸出现频率能差到 6 倍;叠加上简并寡核苷酸合成时机器混合比例误差,实测覆盖往往比理论更歪。多位点组合的库容按 32N 爆炸:2 位点约 1.0×103,3 位点 3.3×104,4 位点约 1.0×106,5 位点已到 3.3×10⁷。
覆盖度:别拿「转化了 107 个」当覆盖
覆盖度要按概率算。若理论库容为 V、挑了 N 个独立克隆,覆盖到全部变体的概率约为 P = 1 − (1 − 1/V)N;反解出达到 95% 覆盖所需克隆数 N ≈ 3V,99% 覆盖约需 4.6V。代入就很直观:3 位点 NNK 库(V ≈ 3.3×10⁴)要 ~1×10⁵ 个独立克隆才谈得上 95% 覆盖;4 位点(V ≈ 1.0×10⁶)要 ~3×10⁶;5 位点(V ≈ 3.3×10⁷)要 ~1×10⁸,已经顶到电转的实际天花板(大肠杆菌电转常见 109–1010 cfu/µg,但建库实测独立克隆通常只有 106–108)。所以 5 位点全组合基本不可行,得改成聚焦热点位点、分库、迭代饱和突变,或者干脆上展示/选择体系把通量拉到 109 以上。
| 组合位点数 | 理论库容 V | 95% 覆盖所需克隆 ≈ 3V | 常规建库可达性 |
|---|---|---|---|
| 1 | 32 | ~102 | 绰绰有余 |
| 2 | 1.0×10³ | ~3×10³ | 轻松 |
| 3 | 3.3×10⁴ | ~1×10⁵ | 常规可达 |
| 4 | 1.0×10⁶ | ~3×10⁶ | 需高电转效率 |
| 5 | 3.3×10⁷ | ~1×10⁸ | 逼近上限,建议改策略 |
建库质控与筛库代价
- 建库后先测再筛:取 ≥ 10–100 倍库容的 NGS reads 检查覆盖均一性、各氨基酸实测频率、终止密码子比例、移码/缺失与野生型背景污染;模板质粒残留要靠 DpnI 处理压下去。
- 筛库通量对表型负责:96/384 孔板一轮约 103–104 个变体,FACS 一天可到 106–107,噬菌体/酵母展示与遗传选择能上 109 以上;通量选错,覆盖度算得再漂亮也读不完。
- 富集用 NGS 统计而非单点挑克隆:比较筛选前后各变体的 VAF 变化与富集倍数,配生物学重复,并把测序背景误差当基线扣除。
- 防表型平均化:一个细胞带多个不同变体质粒会让强弱信号被平均,低拷贝或单拷贝整合体系更可信。
落到判据上:一个库能不能用,不看「设计了多少变体」,而看「实测独立克隆数 ÷ 理论库容」这个比值、实测覆盖均一性、以及筛选通量是否 ≥ 3V。三样里缺一样,后面的富集数据就只能当定性看。
12、项目级风险:需求文档、序列筛查、IP 边界与返工成本
前面十二节都在谈序列,这一节谈项目本身。单条序列做得再漂亮,需求文档含糊、筛查没走、使用权没谈清、返工成本没算,项目照样会卡住甚至推倒重来。这些不是行政流程,是和 GC 曲线一样硬的工程约束。
需求文档要能当合同附件用
一份合格的设计说明(design brief)至少锁死这些:参考序列及其哈希与版本号、表达宿主与菌株、载体与复制子、最终用途(重组蛋白、疫苗、载体生产还是工业酶)、允许优化的范围(能否改非编码区、能否引入/移除酶切位点)、禁止改动的元件清单、交付格式(质粒/甘油菌/线性片段)、验收项与阈值、简并位点判定规则、以及序列文件的保密与数据归属。每次改动都要留 diff、时间戳和批准人,设计冻结(design freeze)之后任何序列变更都视同新项目——因为重评估、重拆分、重合成一轮下来,成本根本不是线性的。一个特别实际的提醒:未公开的序列别随手贴到公开在线优化或比对工具里,那可能构成披露,既影响新颖性也踩保密条款,本地离线工具能解决的就别往外送。
筛查、合规与知识产权边界
- 序列筛查:订单级双用途筛查通常按窗口(例如 ≥ 200 bp 片段)比对受管制病原体、毒素与毒力因子相关数据库,再结合用途与客户身份做人工复核;不同机构与供应方的清单和阈值并不统一,按所在机构与供方规范执行即可,别自行假设「合成厂会全包」。
- 使用权的几层:序列本身的自由实施(FTO)、载体骨架的使用许可与 MTA、工程菌株的商用限制、标准化部件库(如层级组装部件)的授权条款,是四件彼此独立的事,任一层没谈清都可能让下游产品卡住。
- 交付物的数据归属:ab1 峰图、拼接 contig、注释文件、以及优化版序列本身归谁、服务方是否留存、能否再许可,都要写进条款;只拿到一支菌而没有可复核数据的交付,等于把长期风险留给自己。
周期与返工的成本模型
把项目排成关键路径:设计冻结前的改动最便宜,合成一旦启动,改序列就是 100% 重来。难度序列(高 GC、长重复、毒性 CDS)一次拿到完全正确克隆的概率并不高,按 30%–60% 估算并不过分;这时「至少挑到一个正确克隆」的概率是 P = 1 − (1 − p)N,p = 0.4 时挑 6 个独立克隆约 95% 命中,挑 12 个约 99.8%。所以正确做法不是盲目加挑克隆,而是把「多挑克隆 + Sanger 预筛」的成本和「直接上 NGS 全筛」摆在一起算,再结合第 5 节的错误预算选纯化档。周期上给难度序列留 1.5–2 倍缓冲,把返工成本明确拆成三块:直接重做成本(重新合成、重新测序)、周期损失、以及下游实验排期被顺延的隐性成本。止损规则也要事先定:连续 2–3 轮挑不到正确克隆,就必须退回 G1/G2 复查设计与拆分,而不是继续加克隆数硬碰——那通常说明错误在流程上游,不在运气。
13、一张能直接照着执行的判定清单
把前面十二节压成可执行的关卡(gate),每一关都有「过 / 不过」的硬判据,不写「视情况而定」。说白了,这份清单的用法是逐关打勾,任何一关不过就停在当前关,别把问题往下游带。
- G0 需求冻结:参考序列 + 哈希 + 版本锁定;宿主、载体、用途、优化边界、禁止改动元件、验收阈值、简并规则、筛查与保密条款全部签字确认。
- G1 设计评估:GC 全局 40%–60%、50–100 bp 滑窗无 > 80%/< 20% 极端区、重复单元 < 12 bp×3 且间距 > 200 bp、发夹 ΔG 不落入 −9 ~ −12 kcal/mol 以下;隐藏 motif 与内部酶切位点扫描出带坐标报告;优化版固定工具版本、权重与随机种子。
- G2 拆分与路线:Oligo 60–120 nt、重叠 Tm 60–68℃、重叠避开重复与发夹、纯化档按错误预算选;路线按片段数/重复/无痕需求定,Golden Gate 先完成 domestication;分级层级与每级验证点写进构建图。
- G3 克隆与宿主:毒性序列配低拷贝 + 严谨调控 + 25–30℃;独立克隆数按 1 − (1 − p)N 估到 ≥ 95%;单菌落重转化后做双酶切指纹 + 两端测序,确认无重排。
- G4 验证:Sanger walking 双向全覆盖、相邻重叠 ≥ 100–150 bp;NGS 有效深度 ≥ 1000×、最低窗口 ≥ 均值 20%–30%,谈 0.1% 低频则 ≥ 10000× + UMI;功能验证兜底,并逐条核对「100% 一致仍不够」的例外项。
- G5 交付:COA、ab1 峰图、GenBank 注释、质粒量与内毒素报告、菌株/复制子/培养条件记录齐备;参考版本与哈希复核,归责边界当场确认。
[G0 冻结] 哈希✓ 宿主/载体/用途✓ 优化边界✓ 筛查/保密✓
[G1 评估] GC 40–60% | 局部窗口 <80% | 重复 <12bp×3 | ΔG > −9 kcal/mol
[G2 拆分] oligo 60–120nt | 重叠 Tm 60–68℃ | 末端避重复 | 错误预算→克隆数
[G3 克隆] 毒性→低拷贝/25–30℃ | 独立克隆 ≥3/p | 指纹+两端测序
[G4 验证] Sanger 双向全覆盖 | NGS 有效 ≥1000× | 最低窗口 ≥均值20%
[G5 交付] COA+ab1+GenBank+宿主记录 | 归责复核
[失败判读] 合成错→退回 G2 拆分/纯化 | PCR 错→换酶/降循环
            克隆错→换拷贝数/菌株 | 观测错→独立重复/双向/UMI
[止  损] 连续 3 轮无正确克隆 → 退回 G1/G2,不继续加挑克隆
还有一条贯穿全篇的判读原则值得单独拎出来:错误落在哪一层,就退回哪一层修。所有克隆共享同一处不一致,先查 Oligo、PCR 与参比版本(上游样板偏差);不同克隆在不同位置出错、且伴生长缓慢,先查拷贝数与宿主重排(克隆层);峰图里孤零零一个杂合小峰,先换方向重测再谈突变(观测层)。把这条和上面六个关卡合起来,全基因合成就从「碰运气挑克隆」变成一条可复现、可归责、可估成本的工程链——交付的是一支管,但真正买到的,是这份能被人复核的确定性。
最新动态
-
11.05
拉不下来先别换抗体:把Co-IP拆成13道能判的故障
-
11.05
序列一致不等于交付合格:全基因合成的13道工程判据
-
11.04
DNA Pulldown避坑指南:从探针设计到质谱送样的零翻车实操手册
-
11.04
别再乱换试剂盒!Co-IP失败90%的坑,都藏在裂解前的样品制备里
-
11.04
别再盲目抄GAPDH、乱套2^-ΔΔCt公式!qRT-PCR从逆转录细节到统计规范的避坑手册
-
11.04
别再把DAP-seq错当ChIP-seq平替!从HaloTag表达质控、文库参数优化到证据链搭建的全流程
-
10.16
当Cq值不能直接比:荧光定量PCR中被误用的六个假设
-
10.16
噬菌体展示的工程学真相:库容、遗传漂移与淘洗压力之间的三角关系
-
10.16
CUT&Tag的真实门槛:从"一万个细胞起"到"可信图谱"之间那些没人写在protocol里的失败
-
10.16
ChIP-seq实验设计的六道关口:从交联参数到生物学结论之间的断层带
 X