RT‑qPCR实验质控要点:标准曲线、熔解验证与内参稳定性是数据基石
1、先定量化目标:绝对定量、相对定量、限检出判定,三种目标往回决定全部设计
三种问句,三套板位
这事儿吧,一块板报废多半不是加样手抖,而是立项时没把问句定死。定量目标分三类:绝对定量要报每微升多少拷贝,相对定量要报处理组相对对照组差几倍,限检出判定只回答某个靶在不在、到没到检出线。三者往回决定标准品要不要上板、内参选几个、重复怎么排、以及最后能不能用 2-ΔΔCt,几乎不留妥协空间。
绝对定量必须同板跑已知拷贝数的标准品,5~6 个 10 倍稀释点覆盖 10¹~10⁶ 拷贝,未知样本 Cq 落在这段线性区间内才可读;外推到曲线外的低浓度点,误差能到几倍量级。标准品用质粒线性化片段、体外转录本或定值基因组 DNA 都行,但要单独分装、冻融不超过 3 次,且与样本共用同一批 master mix,否则板间效率差会直接污染拷贝数。
相对定量不报拷贝数,只用一个校准样本把各组 ΔCt 归零,重心转向内参稳定性与生物学重复。典型配置是每个样本 3 个技术复孔、每组至少 3 个独立生物学重复;只堆复孔不出组间方差,审稿人一眼识破。限检出判定最容易被混用:阴性基质加标做 20 个平行,95% 检出率对应的浓度算 LOD,CV≤20% 的最低浓度算 LOQ,NTC 全程无扩增是前提。
失败模式很集中:拿相对定量的板去报绝对拷贝数,拿只做过 3 复孔的数据谈组间差异,或者把 LOQ 之下的 Cq 硬算成倍数。目标定错,后面效率、熔解、内参做得再漂亮,也只是把错误算得更精确。
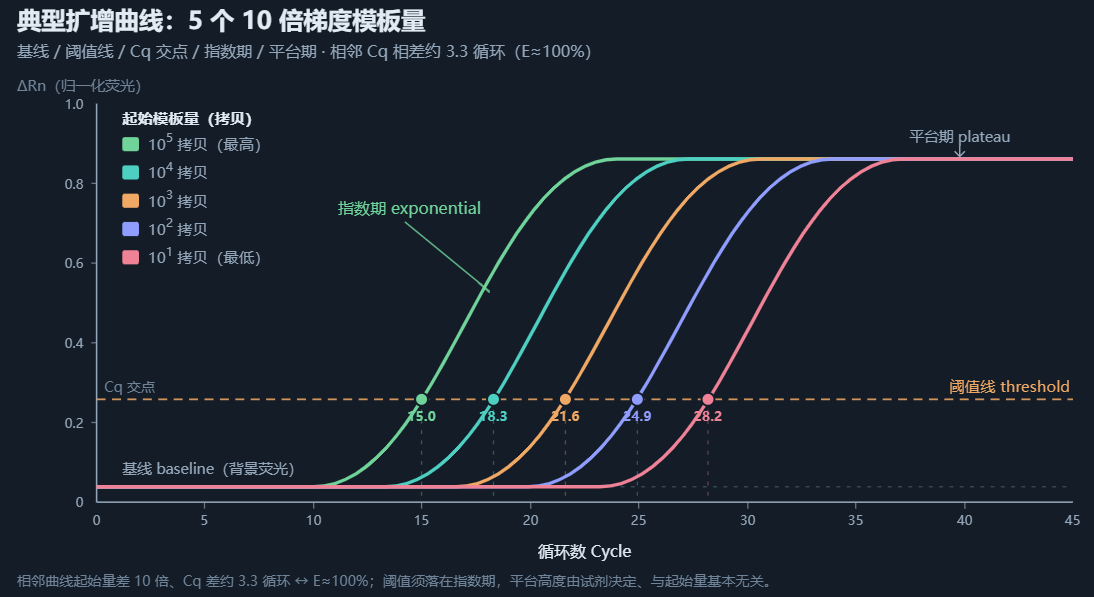
图 1|五条梯度模板量的扩增曲线。阈值线压在指数期早段,Cq 交点随起始量每降 10 倍右移约 3.3 个循环;所有曲线最终汇到相近的平台高度——平台由试剂与仪器决定,与起始拷贝数基本无关,这也是不能拿平台荧光定量的原因。
2、样本与核酸质量:RIN/DIN、A260/230 与抑制物、gDNA 去除与验证、RNA 保存与冻融
三个比值、两个完整性指标
上机前先过一遍硬指标:RNA 的 RIN 建议 ≥7(组织样本可放宽到 ≥6),gDNA 的 DIN ≥7;A260/280 落在 1.8~2.1,A260/230 不低于 2.0、理想 2.0~2.2。230 掉到 1.5 以下基本是酚、胍盐、多糖或乙醇残留,这类抑制物不体现在浓度读数里,却能把扩增效率从 100% 拽到 80% 出头,也就是「浓度够、就是扩不动」。
比比值更可靠的是稀释线性:把同一份 cDNA 做原液、1:5、1:10 三个梯度同板扩增,10 倍稀释在 E≈100% 时应让 Cq 右移约 3.3 个循环。若只移 1.5~2 个,或高浓度原液的 Cq 反而比稀释液更靠后,就是抑制物在作怪——原液里抑制剂浓度最高,稀释后被摊薄,扩增反而变快。这一步能把「样本带毒」和「引物不行」干净地分开。
gDNA 去除别只靠柱上 DNase 一句带过。RNA 用 DNase I 处理后要配一对跨外显子连接的引物,再用 NRT 对照(不加逆转录酶的平行管)验证:NRT 若在 40 循环内出现扩增,说明残留 gDNA 在贡献信号,此时低表达靶的 Cq 会假性提前。RNA 保存用 −80℃ 分装、加 RNase inhibitor,冻融控制在 3 次以内;反复冻融先碎的是长转录本,5′ 端信息悄悄丢掉,qPCR 却仍给出一个漂亮的 Cq。
说白了A260/230 偏低、稀释线性不对,先过一遍柱或做乙醇沉淀把盐带走。老实讲这一步省掉,后面斜率、熔解、内参怎么调都别扭——抑制物不会因为你在板布局上多花了心思就自己消失。
3、逆转录环节:随机引物 / oligo(dT) / 基因特异引物的偏向、酶与抑制剂残留、cDNA 稀释对抑制的缓解
引物策略决定你量到的是哪一段 RNA
随机六聚体覆盖全部转录本、连无 poly(A) 的 RNA 也能带上,代价是 rRNA 片段被一并逆转录、有效 cDNA 占比低;oligo(dT) 只从 poly(A) 尾起始,对降解样本会系统性丢掉 5′ 端信息,靶点若设计在转录本前段,Cq 会假性后移。折中做法是按 1:1~3:1 混用 random 与 oligo(dT),兼顾覆盖与 3′ 偏好;基因特异引物灵敏度最高,但一管只服务一个靶,事后想补测内参就得重做 RT,挺容易翻车的。
酶与条件按量级走:改造型 MMLV 在 42~50℃ 孵 20~50 min,每反应投入总 RNA 100 ng~1 µg,配 20~40 U RNase inhibitor,DTT 与甘油随酶储液带入。这些组分和残留的盐、SDS 一起被带进 qPCR,正是上节稀释线性要抓的东西。同一批样本务必同批 RT、同一管 master mix,否则 RT 效率的批间差会伪装成表达差异。
cDNA 稀释是缓解抑制最省事的一招,常用 1:5~1:20。代价要算清楚:稀释 10 倍让 Cq 右移约 3.3 个循环,低拷贝靶可能从 30 推到 33 以上、甚至掉出 LOQ;所以稀释不是越多越好,而是找到「抑制解除、靶仍在动态范围内」的那个点。判据是稀释后 Cq 位移 ≈ log(稀释倍数)/log(E),偏离即说明还有抑制或已到检测下限。
- 同批 RT:所有样本一次配好、同板逆转录,避免把批次差读成处理效应;
- 外源 spike-in:每管掺 10³~10⁴ 拷贝的已知体外转录本,用它监控 RT 与扩增效率,组间 CV>10% 直接重做;
- 统一稀释倍数:一旦定了 1:10,全板所有样本、所有靶都按 1:10 走,别按 Cq 高低临时改。
4、引物与探针设计进阶:跨外显子连接、扩增子长度与二级结构、Tm 配对、3′ 端稳定性、二聚体热力学、SNP 与假基因规避、MGB/锁核酸探针
跨外显子落点与长度窗口
对付 gDNA 残留,最稳的是让一条引物直接跨 exon–exon junction:3′ 端跨过连接点、至少 4~6 nt 落在下游外显子,gDNA 上找不到连续匹配,自然扩不出东西。退一步也可以把两条引物分放在相邻外显子、让扩增子跨一段内含子,gDNA 模板上的产物动辄几 kb,在 qPCR 的短延伸里基本扩增不起来。扩增子长度取 70~200 bp,SYBR 体系建议 80~150 bp,别超 250 bp——片段越长越怕模板降解,二步法的短延伸也越吃亏。
引物参数按量级卡:长度 18~24 nt,GC 40%~60%,Tm 58~62℃,两条引物 Tm 差 ≤1~2℃(能做到 ≤1℃ 更好)。3′ 端别堆 ≥3 个连续 G/C,也别让两条引物的 3′ 端互补——那是二聚体最高效的起点。3′ 端自由能别太负,局部 ΔG 深于 −9 kcal/mol 时容易在退火温度上自己折回去引发错配延伸。
热力学、SNP 与探针化学
二聚体要查 ΔG,尤其 3′→3′ 互补:整体 ΔG 比 −6 kcal/mol 更负就得警惕,发夹 ΔG 别深于 −3 kcal/mol、且其 Tm 应比退火温度低 10℃ 以上。设计完先跑 55~65℃ 的退火梯度、产物上胶看单带,别直接上 96 孔板;SYBR 下二聚体照样发荧光,等到熔解曲线出现低温峰才发现,一整板就白跑了。常见 SNP(MAF>1%)别压在 3′ 端 5 nt 内,BLAST 顺手排查假基因与同源家族,否则测到的是几个基因的混合信号。
要区分单碱基或做短靶,MGB 与锁核酸(LNA)探针能把 Tm 抬高 8~15℃,于是探针可缩到 13~20 nt、错配 discrimination 更锐;代价是探针 Tm 要比引物高 8~10℃ 才轮得到它先结合,而且错配判别主要靠探针中部,3′ 端一个碱基的容忍度反而没想象中低。探针化学救不了糟糕的引物——扩增子本身跨着假基因,探针再讲究也是把错误的模板量得更准。
5、化学体系选择:SYBR Green I、TaqMan 水解探针、分子信标;多重检测的通道串扰与引物竞争
三种化学,三种「特异性从哪来」
SYBR Green I 便宜、通用、换靶只换引物,靠熔解曲线事后验特异,但所有双链产物都发光,二聚体与非特异扩增会一起计入 Cq;染料按 1× 终浓度加,额外补加反而抑制聚合酶。TaqMan 水解探针靠引物加探针双重识别,特异性与定量线性都更稳,天然适合多重,代价是每条靶单独合成、探针 Tm 被约束。分子信标未杂交时茎环自淬灭,背景最低、适合等位基因判别,但茎部 Tm 要精调,设计门槛最高。
| 体系 | 特异性由谁保证 | 典型用量 / 判读要点 | 多重与成本 |
|---|---|---|---|
| SYBR Green I | 仅引物 + 熔解曲线,任何双链都发光 | 1× 染料;必须看单峰,出现二聚体低温峰即判该孔失败 | 单靶最省,不适合多重 |
| TaqMan 水解探针 | 引物 + 探针双识别,序列层面特异 | 探针 100~250 nM、引物 200~400 nM;探针 Tm 比引物高 8~10℃ | 天然适配多重,每条靶单独合成 |
| 分子信标 | 茎环自淬灭,仅完全匹配时发光 | 背景最低,茎部 Tm 需精调;适合单碱基判别 | 设计门槛高,通道占用多 |
多重的两处暗坑
多重不是把几套引物倒进一管就完事。先是通道串扰:FAM、VIC/HEX、ROX、Cy5 的发射谱有重叠,必须用单染对照跑一遍补偿矩阵,把 spillover 系数写进仪器设置,否则低丰度通道的基线会被高丰度通道抬起,Cq 假性提前。再是引物竞争:几对引物抢同一份酶与 dNTP,高丰度靶先进入指数期、把资源吃光,低丰度靶的 Cq 能后移 2~3 个循环。常规做法是把低丰度靶引物提到 400 nM、高丰度靶压到 100 nM,并验证单重与多重下每个靶的 Cq 差 ≤0.5,超了就别硬凑多重。
6、反应体系与板布局:Mg²⁺、引物浓度矩阵、模板投入量、ROX 校正、边缘效应与随机化布板
先把浓度矩阵跑成一张小表
以 20 µL 体系为基准:2× master mix 10 µL,引物终浓度 100~400 nM,模板 cDNA 1~100 ng(或对应 1~10 ng 总 RNA 的 RT 产物),Mg²⁺ 终浓度 1.5~5 mM——多数商用 mix 已固定在 3 mM 左右,额外补镁前先确认配方,别把两件事叠一起调。新引物上线建议跑 3×3 矩阵:引物 100/200/400 nM × Mg²⁺ 1.5/3/5 mM,九个组合各带 NTC,看 Cq、平台高度与熔解峰。
判读顺序很固定:先挑 Cq 最小、NTC 无扩增、熔解单峰的组合,再看 ΔRn 平台够不够高。引物偏高→低温二聚体峰,Mg²⁺ 偏高→非特异扩增、效率虚高甚至 NTC 起翘,Mg²⁺ 偏低→Cq 整体后移、低拷贝不扩增。矩阵看着费板,却比后面逐孔排查省事得多。
ROX 是被动参比,用来扣掉加样体积与光学路径的孔间差,仪器分低 ROX 与高 ROX 两档,混用会看到基线整体漂移、复孔散射变大。边缘效应同样不能忽略:96 孔板最外圈蒸发更快,Cq 平均比中间孔偏后 0.3~1.0 个循环,封板膜要压边压实,外圈只放 NTC、标准品或参比,讲究的实验室干脆弃用最外一圈。
- 随机化:把处理组与对照组打散到不同行、不同列,别按组整排排布,否则温度梯度或加样顺序漂移会被读成组间差异;
- 复孔判据:3 个技术复孔的 Cq SD ≤0.2~0.3,超了先查加样与气泡,别用平均值掩盖问题;
- 余量:master mix 按总孔数的 1.1 倍配,复孔相邻但不用同一吸头连续分液。
7、扩增程序调参:预变性、二步法与三步法、touchdown、循环数与平台期、升温速率
二步法、三步法与 touchdown
预变性按热启动酶的说明书走,95℃ 2~10 min,拖太长只会白耗酶活;循环数设 40~45。二步法是 95℃ 10~15 s 变性、60℃ 30~60 s 把退火与延伸合并,适合 Tm 60℃ 上下、扩增子 <150 bp 的短产物,SYBR 与探针都通用;三步法把退火(55~60℃)与 72℃ 延伸拆开,给长扩增子或低 Tm 引物留够聚合时间,代价是每循环多一次变温、整板多跑十几分钟。
touchdown 用来压非特异:前 10~15 个循环把退火温度从 Tm+5~8℃ 每循环降 0.5~1℃,之后固定在 Tm−2℃ 跑完。它确实能救一对勉强合格的引物,但程序一改,Cq 就与常规程序不可比——同一项目所有板必须跑同一套程序,否则板间校准失去意义,前面辛苦做的随机化布板也跟着白费。
循环数别贪多。40 循环后还贴着基线的低拷贝,加到 45 往往只是把噪声抬成假阳性;平台期通常在 30~35 循环之后到来,Cq 必须落在指数期内,落到 35 以后的点应按 LOQ 规则报「检出但不可定量」。升降温速率也常被忽视,1~3℃/s 是常见区间,过快会让 60℃ 的实际孵育不足、效率掉几个百分点;换仪器或改程序后,最好用同一批标准曲线把 E 重新验一遍。
8、标准曲线与效率验证:5 点以上稀释系列、斜率/截距/R²、效率 90–110% 两侧的相反成因、抑制剂检测的稀释线性
斜率就是效率,两侧成因相反
标准曲线至少 5 个点、推荐 6 个 10 倍稀释点,每点 3 复孔,覆盖样本预期浓度区间。以 log(起始拷贝数) 为横轴、Cq 为纵轴做线性回归,换算关系是 E = 10^(-1/slope) − 1:slope = −3.32 对应 E = 100%,−3.6 落到 ≈90%,−3.1 抬到 ≈110%。合格线一般卡 90~110%、R² ≥ 0.99,截距即单拷贝理论 Cq,多数体系在 35~40 之间;同一靶的板间截距漂移超过 1 个循环,就要回头查标准品与 master mix 批次。
效率出窗的两侧成因几乎相反:偏陡(斜率负得更多、E 偏低)多来自抑制物残留、引物浓度不足、退火温度过高、酶活衰减或标准品降解,本质是每轮没扩满;偏平(E 偏高)多来自非特异扩增与二聚体叠加、标准品定值虚高、基线窗口设错,本质是荧光里混进了本不该有的信号。看到 E = 115% 先别高兴,那通常不是酶特别猛,而是有别的东西在替你发光。
还有一层容易漏:拿样本本身而非标准品做稀释梯度,把稀释后的 ΔCq 与理论值比对。标准品泡在干净缓冲液里,样本基质却带着盐、蛋白与抑制剂;若样本稀释曲线明显更陡,说明抑制仍在,此时标准曲线合格也不能直接拿去归一化。稀释线性是查抑制剂最省钱的手段,比重新过柱快得多。
| 现象 | 斜率 / E 指向 | 常见成因 | 处置 |
|---|---|---|---|
| 曲线偏陡 | < −3.4 / E < 95% | 抑制物残留、引物不足、退火温度过高、酶活下降、标准品降解 | 稀释模板、重配引物、换新鲜标准品 |
| 曲线偏平 | > −3.1 / E > 110% | 非特异扩增或二聚体叠加、标准品定值偏高、基线窗口设错 | 看熔解曲线、重标标准品、固定基线 |
| R² < 0.99 | 点不在直线上 | 移液误差、低浓度点翘起、稀释系列配错 | 重配梯度、每点 3 复孔、弃离群点须有规则 |
| 截距漂移 | 板间不一致 | 标准品批次、mix 批次、仪器状态变化 | 同批 mix、每板设校准样 |
判读提醒看到 R² = 0.999 就宣布体系合格是常见误判:先确认标准曲线与样本稀释线性一致、熔解单峰、NTC 干净,三项齐了才谈效率达标;任何一项缺位,E 都只是缓冲液里一个漂亮数字。
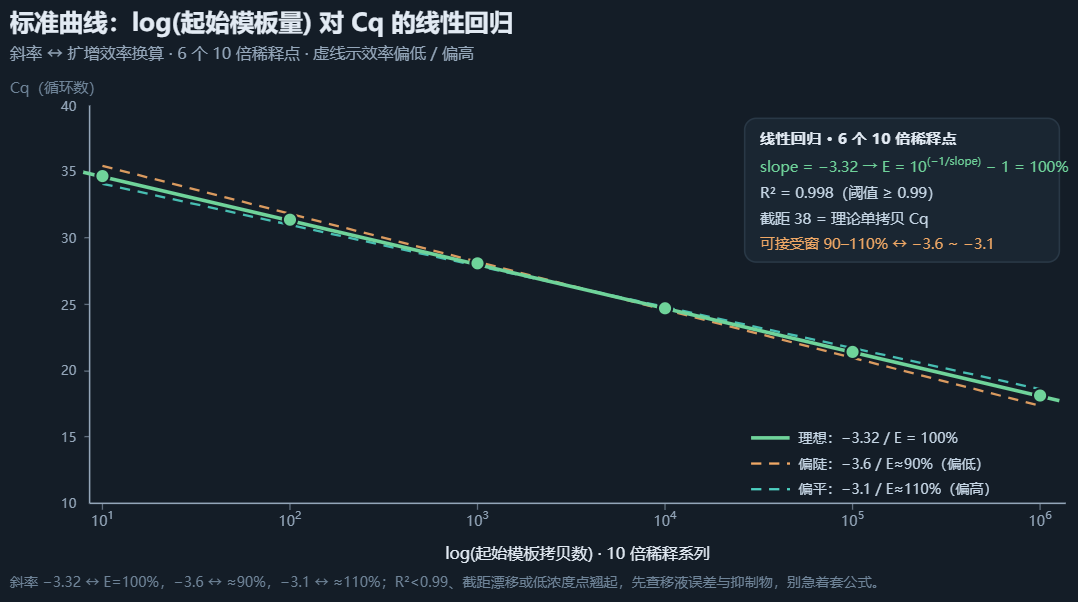
图 2|log(起始模板量) 对 Cq 的标准曲线。实线斜率 −3.32 对应 E = 100% 与 R² = 0.998;橙色偏陡虚线(−3.6,E≈90%)与青色偏平虚线(−3.1,E≈110%)示意效率出窗的两种相反方向,三条线在校准中点交汇。
9、基线、阈值与 Cq:自动 vs 固定阈值、基线漂移、Cq 与 Ct 术语统一、低拷贝区的随机性
阈值放在哪,比怎么算更要紧
基线窗口一般取第 3~15 循环,用来扣掉背景荧光;窗口若把早期扩增圈进去,曲线会被整体压低、Cq 后移。阈值线压在指数期早段、各条曲线平行上升的位置。自动阈值逐孔计算、板内看着整齐但板间不可比;固定阈值全板共用、更适合多板合并,代价是对基线漂移更敏感。同一项目建议固定阈值,再用板间校准样把各板 Cq 拉齐。
基线漂移有可辨认的样子:扩增之前 ΔRn 缓慢爬升,或复孔之间散射明显变大,常见原因是 ROX 档位配错、加样气泡、封板膜反光、孔底划痕。判据很直白——NTC 与前 15 循环的 ΔRn 应当基本水平,斜率明显非零就重设基线窗口或弃该孔,别靠改阈值去把漂移抹平。
术语上 MIQE 统一用 Cq(quantification cycle),Ct、Cp 属于厂商旧称,全文从头到尾只留一个,混用会被审稿人挑出来。低拷贝区另有一层随机性:模板降到 10 拷贝以下、或 Cq 推到 35 循环以后,泊松抽样开始主导,复孔 Cq 的 SD 会涨到 0.5~1,甚至出现「两孔有、一孔无」的分裂。这种点报「低于 LOQ / 未检出」比硬算倍数诚实,把它塞进 2-ΔΔCt 只会把噪声一起放大。
10、熔解曲线:单峰不等于特异、多峰与肩峰的成因、引物二聚体 Tm 特征、HRM 与凝胶验证的补充
导数图的三种峰型
熔解程序从 65℃ 升到 95℃,常规升温 0.1~0.3℃/s 连续采集荧光,再取 −dF/dT 画导数图。一个对称单峰、Tm 与扩增子 GC 含量预期一致(70~200 bp 产物多在 78~88℃),是特异性的必要但不充分条件。HRM 把升温压到 0.02~0.1℃/s、换饱和染料,能分辨单碱基造成的 0.2~1℃ Tm 偏移,但那是另一套验证,不替代常规熔解判读。
单峰不等于特异:Tm 相差不到 1℃ 的两个产物会融成同一个峰,同源扩增子、假基因片段与嵌合产物都能给出漂亮的单一峰。所以判据永远是组合式的——目标孔单峰、NTC 无峰、凝胶单带、扩增子长度对得上,缺一项就别写「特异」两个字。
多峰与肩峰各有来路:主峰旁的肩峰说明两个 Tm 接近的产物部分重叠;比主峰低 8~12℃、常落在 70~78℃ 的独立低温峰,基本是引物二聚体,它随引物浓度升高、模板量降低而变高,NTC 里往往也有;高温侧的额外峰则可能是 gDNA 扩增子或非特异长产物。处置按顺序来:引物从 400 nM 降到 100~200 nM、退火温度抬 2~4℃、重设计 3′ 端互补,再用凝胶确认只剩一条带。挺容易翻车的做法,就是扫一眼「单峰」就把整板判合格。
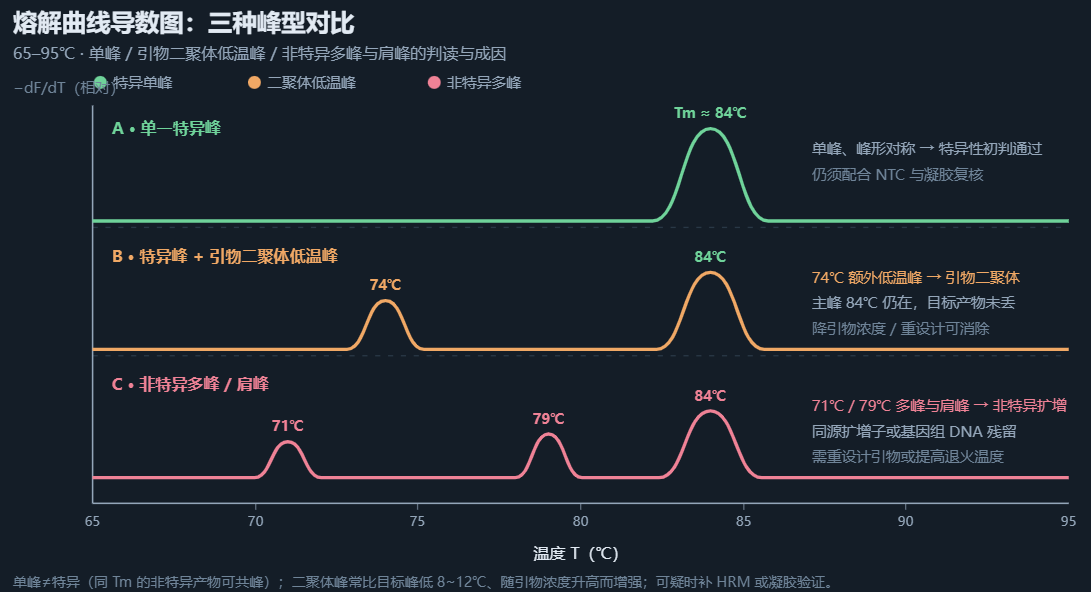
图 3|三种熔解峰型。A 单峰只是必要证据;B 的 74℃ 低温峰来自引物二聚体,主峰仍在说明目标产物没丢;C 的 71℃ / 79℃ 多峰与肩峰指向非特异扩增或 gDNA 残留,必须回到引物设计与退火条件。
11、内参基因:geNorm / NormFinder / BestKeeper 稳定性排序、多内参几何平均、处理条件下的内参漂移与 18S 陷阱
稳定性要验,不能靠习惯
GAPDH、ACTB、18S、TBP、HPRT1、RPL13A 这几个老面孔并不放之四海皆稳,缺氧、药物刺激、分化、细胞周期同步化都会动到它们。稳定性要拿自己的样本跑一遍:geNorm 给平均表达稳定性 M 值,两两比较的变异越小 M 越小,常用阈值 M < 0.5;NormFinder 给 stability value,额外拆开组内与组间方差,有明确分组时比 geNorm 更抗干扰;BestKeeper 看 Cq 的 SD 与相关系数,一般要求 SD < 1、候选不少于 3 个。三者排序打架时,以 NormFinder 的分组结构为主、geNorm 排序为辅。
定下候选后取 M 最小的 2~3 个内参做几何平均当归一化因子,别用算术平均,更别只挑一个。geNorm 的配对变异 V2/V3 < 0.15 说明加第三个内参已不显著改善,可以收手;单内参一旦在处理组里漂移,整批倍数会被系统性带偏,而且从 Cq 数值上完全看不出来。
18S 是个专门的陷阱:rRNA 丰度极高、没有 poly(A) 尾,用 oligo(dT) 做 RT 时它几乎不出现;它的 Cq 常在 10~15,而靶基因在 25~30,两者差十几个循环,稀释线性、抑制物响应、平台期行为全不在一个量级。表面看它「不受 mRNA 调控」,实际会随核糖体生物合成与增殖状态变化。老实讲,18S 更适合当上样量或 RNA 完整性的指示,而不是表达归一化的内参。
常见坑照抄文献里别人用的内参,是最省事也最容易出事的做法:同一处理在你这套细胞里可能正好调控那个基因。先拿 6~8 个候选在自己样本上跑一趟稳定性排序,再定归一化因子,比事后被审稿人追问「为什么用 GAPDH」划算得多。
12、归一化模型与统计:2^-ΔΔCt 的前提与失效条件、Pfaffl 效率校正、多因子推广、技术重复与生物学重复层级、板间校准与离群值规则
别急着算倍数:先把前提摆齐
2-ΔΔCt 的前提写得越清楚越好用:目标基因与内参的效率都接近 100%(E≈2)、两者效率差 <5%,内参跨处理稳定,校准样本定义明确且同板。效率不等的代价不是线性的——ΔCq 到 5、E 差 5% 时,算出的倍数能偏 20%~30%,而 Cq 本身看着毫无异常。失效条件要背下来:E 出 90~110%、内参漂移、靶与参扩增子长度差过大、Cq 推到 35 以后,任一命中就别用这个模型。
Pfaffl 把效率显式写进去:R = E_target^ΔCq(target) / E_ref^ΔCq(ref),其中 ΔCq = Cq(对照) − Cq(样本),E 由各基因自己的标准曲线实测(常见 1.90~2.10)。靶与参效率不等时它仍成立,多个参考基因可推广成各指数项的连乘或几何平均,多靶比较也可把 ratio 连乘。它比 2-ΔΔCt 多要的输入只是一组可信斜率,性价比很高。
| 模型 | 前提 | 适用 | 失效 / 换模型 |
|---|---|---|---|
| 2-ΔΔCt | 靶与内参 E≈2 且差值 <5%,内参稳定 | 单因子、两组比较、体系已验过效率 | E 出 90–110%、内参漂移、效率不等 → 换 Pfaffl |
| Pfaffl | 各基因 E 由标准曲线实测 | 靶与参效率不等、E 偏离 2 | 无可信斜率则退回相对法并说明 |
| 多因子 / 几何平均 | ≥2 个稳定内参、V2/V3 < 0.15 | 多组、多处理、组织样本 | 内参共漂移时全部模型一起失效 |
统计层级是最常被做错的一环:技术复孔只反映移液与光学噪声,不是 n;真正的 n 是独立生物学重复,至少 3 个、能到 5 个更稳。正确顺序是先把 3 复孔取均值、得到每个生物学样本的 ΔCt,再在生物学重复层面做检验,绝不能把一块板上的 9 个复孔当成 n = 9 去算 p 值。跨板比较时每板放同一个校准样,把板效应在 ΔΔCt 之前减掉,或作为随机因子写进模型。
离群值规则必须事先写死:技术复孔 Cq SD > 0.3 按预设规则剔除并重跑,生物学层面的离群用 Grubbs 或 ROUT 检验且在报告里注明;按结果顺眼与否挑孔,是这条链上最不该出现的动作。
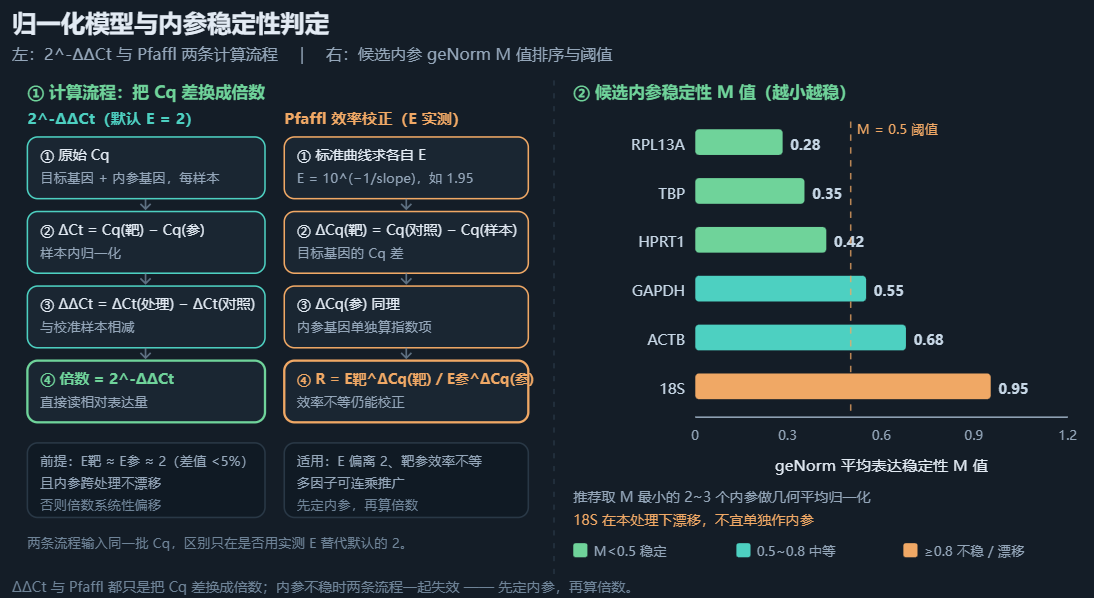
图 4|左侧两条归一化流程:2-ΔΔCt 直接把 ΔΔCt 当 2 的指数,Pfaffl 用标准曲线实测的 E 分别给目标与内参建指数项;右侧为 6 个候选内参的 geNorm M 值排序,M = 0.5 是常用阈值,18S 因处理下漂移排在末位。
13、MIQE / MIQE 2.0 报告清单、NTC / NRT 对照与重复层级、审稿质疑与判定清单
对照体系:一行都不能少
对照是一块板的地基,不是凑数的孔。NTC(无模板,水替模板)每板每对引物至少 2 孔,40 循环内应无 Cq、熔解无峰;一旦出现 Cq < 38 或低温峰,先当作污染或二聚体处理,该引物本板全部数据作废,别只把那两孔删掉了事。NRT(不加逆转录酶)每批 RNA 至少 1 管,专门验 gDNA:出现扩增就说明 DNase 没做干净,低表达靶的 Cq 会假性提前。每板再放一个跨板共用的校准样,用来把板效应从 ΔΔCt 之前扣掉。
| 对照 | 放几孔 / 频次 | 通过判据 | 失败含义 |
|---|---|---|---|
| NTC(无模板) | 每板每对引物 ≥2 孔 | 40 循环内无 Cq、熔解无峰 | 试剂或环境核酸污染,或引物二聚体 |
| NRT(无 RT 酶) | 每批 RNA ≥1 管 | 无扩增,或 Cq 比 +RT 管晚 ≥5 | gDNA 残留,低表达靶 Cq 假性提前 |
| 阳性 / 校准样 | 每板 ≥1 孔,跨板同一个样 | 板间 Cq 差 ≤0.5 | 板效应未扣,多板数据不可直接合并 |
| 抑制物监控(spike-in) | 每批 RT 每管掺入 | 组间 Cq CV ≤10% | RT 效率或扩增抑制存在批间差 |
MIQE 清单与审稿人常问的五句
MIQE 要报的其实是一整条证据链:样本来源与处理、RNA 完整性(RIN、A260/280、A260/230)、DNase 与 RT 试剂型号、引物策略与酶量、每条引物与探针的序列、Tm、扩增子长度、体系中的 Mg²⁺ 与引物浓度、模板投入量、仪器型号与完整程序、标准曲线斜率 / E / R² / 动态范围、基线与阈值如何设定、NTC 与 NRT 结果、内参稳定性用的哪个算法、归一化模型、统计方法与重复层级。MIQE 2.0 更强调数据可追溯:建议把原始 Cq 表、扩增曲线与熔解曲线作为补充材料一并交付。
审稿人翻到 qPCR 图,问来问去就那五句:效率怎么验的、内参凭什么算稳、单峰凭什么算特异、重复是技术还是生物学、NTC 与 NRT 结果在哪。说白了,五句全指向同一件事——从样本到倍数中间那几层证据,你到底补齐没有。补不齐,曲线画得再顺也只是好看。
投稿前的三档判定
- 可投稿:E 在 90~110%、R² ≥ 0.99、熔解单峰且 NTC 干净、内参经验证、n 为生物学重复 ≥3、原始 Cq 可追溯;
- 需补实验:只缺 NRT 或板间校准样,或内参用了单个未验证基因,补齐即可,不必推倒重来;
- 不可投:NTC 起扩增仍报数据、把技术复孔当 n、效率出窗却仍套 2-ΔΔCt、或按结果顺眼与否挑孔。
把这三档贴在实验记录本上,比事后回忆「当时好像跑过 NTC」可靠得多。一块板能给的终究只是这几管里荧光怎么涨,把它写成结论之前,效率、特异性、归一化三层证据得一层层交出来——这正是整篇从头到尾没让「先算倍数」抢跑的原因。
最新动态
-
11.06
RT‑qPCR实验质控要点:标准曲线、熔解验证与内参稳定性是数据基石
-
11.06
EMSA实验质控要点:对照体系比移位条带更决定结果可靠性
-
11.05
Co‑IP总无目的条带?先做故障定位,别急着换新抗体
-
11.05
序列一致不等于交付合格:全基因合成的13道工程判据
-
11.04
DNA Pulldown避坑指南:从探针设计到质谱送样的零翻车实操手册
-
11.04
别再乱换试剂盒!Co-IP失败90%的坑,都藏在裂解前的样品制备里
-
11.04
别再盲目抄GAPDH、乱套2^-ΔΔCt公式!qRT-PCR从逆转录细节到统计规范的避坑手册
-
11.04
别再把DAP-seq错当ChIP-seq平替!从HaloTag表达质控、文库参数优化到证据链搭建的全流程
-
10.16
当Cq值不能直接比:荧光定量PCR中被误用的六个假设
-
10.16
噬菌体展示的工程学真相:库容、遗传漂移与淘洗压力之间的三角关系
 X