酵母单杂交(Y1H)筛选:诱饵设计、假阳性治理与阳性结果验证体系
1、系统选型与载体进化
将酵母单杂交用于植物转录调控研究时,第一个常被低估却决定成败的变量是"诱饵以何种形式存在于细胞中"。经典方案以游离型诱饵质粒 pHis2 配合 Y187 文库宿主:诱饵片段克隆在 HIS3 报告基因上游,猎物以 GAL4 激活域融合蛋白形式在另一交配型菌株中表达。这套体系曾长期作为入门标配,但其底层缺陷在进阶筛选中会被放大,诱饵以多拷贝游离质粒形式存在,细胞间质粒丢失率与拷贝数高度不均,导致诱饵表达量在群体中产生可观波动;加之 Y187 为 a 交配型,必须与 α 型文库菌交配才能完成筛选,流程繁琐、嵌合体比例偏高、转化效率受限,最终表现为背景不一致、可重复性差的"软伤"。
整合型系统(如 YM4271 配合 pHisi-1 / pLacZi)的出现正是为了根治上述痛点。其核心思想是将诱饵序列通过同源重组整合进酵母基因组,形成单拷贝、可稳定遗传的构型。单拷贝意味着每一代细胞携带的诱饵数量恒定,筛选背景因此变得均一、可量化;pLacZi 进一步提供第二个报告基因 LacZ,使研究者第一次具备"双报告"正交确认的能力。然而早期整合体系在整合效率与筛选标记的便利性上仍有提升空间。
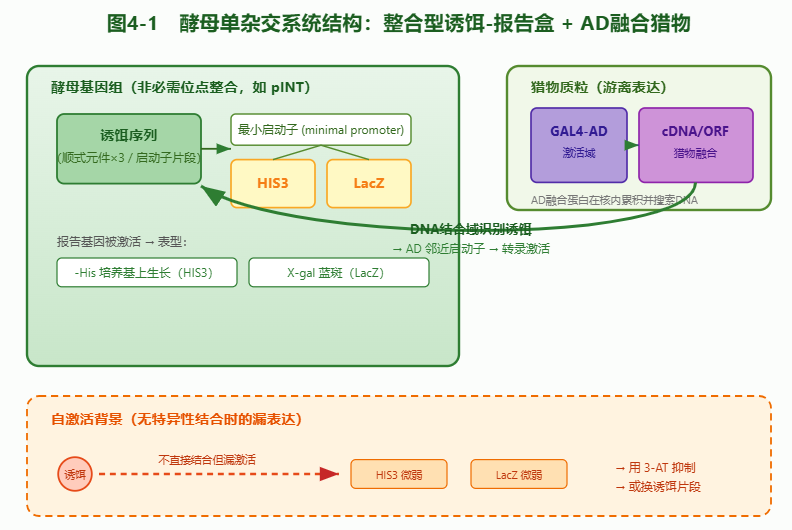
图4-1 整合型 酵母单杂交系统结构。左:诱饵序列整合于酵母基因组非必需位点,上游驱动 HIS3 / LacZ 报告基因;右:GAL4 激活域融合猎物由游离质粒表达并进入核内。当猎物 DNA 结合域识别诱饵即激活转录(绿色逻辑);虚线红框对比诱饵"无特异性结合却漏激活"的自激活背景。
当前主流的 Y1HGold–pAbAi 整合体系代表了这一进化路线的成熟形态。它把诱饵装载在 pAbAi 载体上,利用金担子素(aureobasidin A)抗性标记 AbAr 快速富集已整合的克隆,诱饵以单拷贝稳定整合于基因组;文库侧则使用 pGADT7 系列 AD 融合表达载体。相对游离体系,其优势可归纳为三点:一是整合稳定、传代不丢失,使多轮复筛与跨批次比较成为可能;二是单拷贝消除了拷贝数噪声,背景显著低于多拷贝质粒;三是 AbAr 筛选与后续 HIS3/ADE2 报告可形成层级分明的筛选漏斗。
更值得强调的是"整合到非必需位点"这一工程决策的价值。将诱饵定向整合到基因组非必需位点(如 HO 位点或专门设计的 pINT 接受位点),能够避免随机整合破坏必需基因、规避不同整合位置带来的位置效应(邻近异染色质或强启动子会扭曲诱饵的有效表达)。在 pINT 这类定点系统中,研究者甚至可以对同一菌株多重整合多个不同诱饵,构建标准化的"诱饵菌株库",这不仅是技术优化,更为高通量、可重复的互作筛选奠定了基础设施。我们强烈建议,任何计划进行多基因、多条件 Y1H 筛选的课题组,都应优先投资构建自己的整合型诱饵菌株库,而非反复依赖游离质粒的临时转化。
2、诱饵序列设计的策略学
诱饵设计是 Y1H 成败的"上游旋钮"。我们归纳出三种主流策略,各有清晰的适用边界,不存在放之四海皆准的"最优片段"。
200–300 bp 顺式元件富集区截短法
最常用也最稳健的策略,是将目标启动子内已知或预测的核心调控区截短为 200–300 bp 片段。其优势在于片段短、PCR 与克隆效率高、自发背景低,且一旦命中即可直接定位到具体调控模块。代价是可能丢失远端协同因子结合位点或多层调控所需的空间构象,从而漏掉需要多位点协同才稳定的互作。该方法适合"已有较强元件注释、希望精确验证某一调控区"的场景。
目标基序 3× 串联重复法
当目标基序(如 ABRE、DRE/CRT、MYB 结合位点)亲和力较低、直接截短易假阴性时,可将核心基序串联重复 3 次置于最小启动子之前。多拷贝靶标显著放大结合信号,对低亲和力、瞬时性的互作尤为友好。但必须警惕:重复序列在酵母中易发生同源重组缺失,且重复单元可能形成非天然 DNA 构象,反而引入自激活或构象特异的假阳性。我们的经验是,3× 重复应作为"增强灵敏度"的补充诱饵,而非唯一诱饵。
全长启动子(500–2000 bp)法
保留完整自然上下文的全长启动子能捕获多个协同因子、甚至发现未知的顺式元件,是构建"调控网络"的利器。但其代价同样明确:长片段克隆连接效率低、PCR 易错配缺失;更关键的是,长诱饵包含更多潜在的类激活序列与内源因子结合位点,背景会随长度显著升高。因此全长诱饵必须与更严格的3-AT 滴定和双报告确认配套使用。
就构建难度与背景的权衡,我们给出明确观点:除非目标是发现未知元件,否则优先采用"截短 + 3× 重复"组合,而非盲目上全长。长片段与重复区在酵母体内均不稳定,应通过测序验证整合片段的完整性,并设无关全长片段作平行对照。
为提升发现率,应并行设计 2–3 个不同区域的截短诱饵,覆盖启动子的近端核心区、远端增强子样区与候选基序富集区,相互补足以避免单一截短遗漏关键互作。在生信辅助方面,诱饵序列设计应充分利用公共数据库:PlantCARE 提供植物启动子顺式元件的标准化注释,可精确定位已知基序边界;PlantPAN 3.0 整合了植物转录调控网络与基序预测,能反向提示"该启动子可能受哪些 TF 家族调控",从而指导截短方向;PlantTFDB 则用于转录因子家族的系统注释,既可在 TF-centered 实验中反向设计诱饵,也可在 Gene-centered 命中后快速归属候选蛋白。实操流程为:取目标基因上游 1–2 kb,先用 PlantCARE 注释候选元件,再用 PlantPAN 预测受控的 TF 家族,据此划定截短边界并决定是否需要 3× 重复,最后用 PlantTFDB 校验候选猎物的家族归属。
3、自激活的系统治理
自激活指诱饵本身(无需猎物结合)即可驱动报告基因表达的现象,是 Y1H 背景的最大来源,必须在文库筛选前彻底评估与压制。
筛选前必做的自激活检测流程如下:取已整合诱饵但仅携带空载 AD 的菌株,梯度点板于不同严谨度培养基,-Leu/-His(仅 HIS3 报告)、-Leu/-His 加不同浓度 3-AT、-Leu/-His/-Ade(若启用 ADE2 双报告)、以及含 X-gal 的 LacZ 检测板。记录各条件下的生长强度与蓝斑本底。若诱饵菌株在零 3-AT 的 -His 板上即明显生长,说明存在自激活,必须处理后方可进文库。
严谨度应做成梯度而非单一条件:低严谨(-His,0 3-AT)→ 中严谨(-His + 10–25 mM 3-AT)→ 高严谨(-His/-Ade + 50–100 mM 3-AT)。具体档位由背景强度动态决定,切忌"一刀切"。
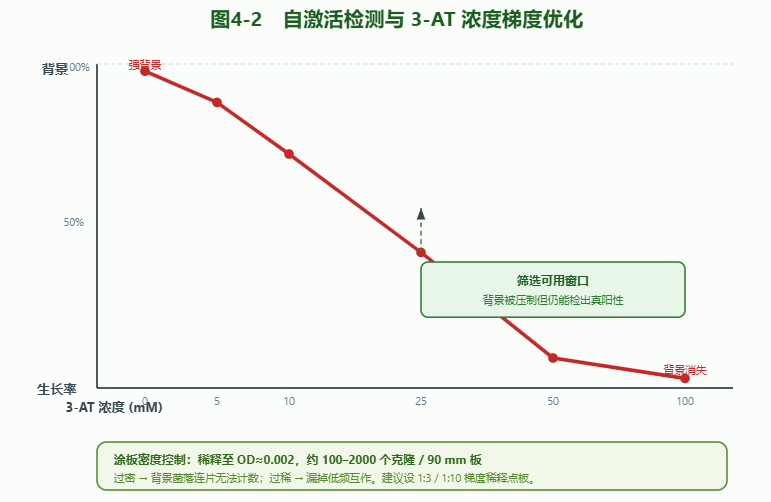
图4-2 自激活检测与 3-AT 滴定。横轴为 3-AT 浓度,纵轴为诱饵空载背景生长率;随浓度升高背景被逐步压制,存在"筛选可用窗口"(背景刚好消失而真阳性仍可长)。底部标注涂板密度控制:稀释至 OD≈0.002,约 100–2000 个克隆 / 90 mm 板。
3-AT(3-氨基-1,2,4-三唑)是 HIS3 编码的咪唑甘油磷酸脱水酶(His3p)的竞争抑制剂。提高 3-AT 浓度可竞争性阻断背景水平的 HIS3 表达,却通常不足以压制由 AD 强力激活的真实互作,前提是真互作足够强。因此 3-AT 滴定的本质是寻找"背景刚好被压住、真阳性仍能生长"的窄窗口(见图4-2)。我们建议以 5、10、25、50、100 mM 为梯度,配合稀释点板确定该窗口。
涂板密度是另一容易被忽视的变量。自激活检测与正式筛选均应将菌液稀释至 OD≈0.002,对应约 100–2000 个克隆 / 90 mm 板。过密会造成菌落连片、无法计数与挑取;过稀则低频互作被漏掉。稳妥做法是同时点 1:3 与 1:10 梯度稀释,确保既能量化背景又保留稀有阳性。
当背景无法被 3-AT 压制时,我们明确推荐处置顺序:优先换诱饵片段(2–3 种并设计),其次才考虑换系统。理由是自激活多源于诱饵内部嵌合的强激活序列或重复区,换一段截短诱饵往往立竿见影且成本极低;仅当所有诱饵设计均失败,才升级到双报告、改用 ADE2 报告或切换整合位点。此外需关注 LacZ 背景问题:X-gal 蓝斑本底高、判读主观,建议并行使用 MEL1(α-半乳糖苷酶,X-α-Gal 产色)或 ADE2(红/白菌落)报告,将 LacZ 的定性模糊转化为可量化的正交信号。
4、文库选择与筛选效率
文库选择直接决定"要筛多少、能命中多少"。两类文库各有鲜明的性价比画像。
cDNA文库覆盖全转录组,广度极大,既能发现转录因子也能捕获非 TF 的 DNA 结合蛋白(如结构蛋白、辅因子、染色质修饰子)。但其致命短板是转录因子在总转录本中仅占 5–10%,意味着绝大多数筛到的克隆是"非目标"蛋白,命中 TF 的先验概率低,必须深筛(常需筛选百万级克隆)才能覆盖完整空间。对预算有限、又想"广撒网"的课题组,cDNA文库是合理起点,但务必做好冗余克隆的聚类与剔除。
转录因子文库(ORF 文库)则走向另一极端:人、水稻、拟南芥等物种已有商品化或公共 TF ORF 库,命中率高、筛选规模小,但价格昂贵且物种特异,水稻库不能替代拟南芥库的生物学意义。我们给出经验规则:单子叶植物优先使用水稻 TF 库,双子叶植物优先使用拟南芥 TF 库。虽然跨物种同源性可部分弥补,但必须意识到同源物的 DNA 结合特异性可能存在差异,植物间的移植结论需谨慎。
关于"归一化(Normalized)cDNA文库",其意义在于通过标准化步骤降低高丰度转录本、提升低丰度代表性,从而显著提高稀有 TF 与调控蛋白的命中率,同时减少反复命中看家基因造成的冗余。若经费允许且目标是发现低丰度调控因子,归一化库应是首选;反之若只求快速验证已知候选,普通库或 TF 库更经济。需要强调的是,无论何种文库,独立转化应达到足够的覆盖深度(建议 ≥10× 文库复杂度),并在筛选后统计独立阳性克隆数而非总菌落数。
5、假阳性的多层治理体系
Y1H 的假阳性来源可归结为三类机理,理解机理才能对症治理。
其一,内源酵母转录因子误激活。酵母自身 TF(如 Gcn4、某些应激通路因子)可能与诱饵弱结合,或结合诱饵内非目标序列,从而驱动报告基因。这类背景具有菌株依赖性,处置手段是设置空载/无关诱饵对照,并选用遗传背景更"干净"的宿主(如剔除部分内源调控因子的工程菌株)。
其二,猎物直接结合 GAL4 启动子。某些 AD 融合蛋白并非结合诱饵,而是非特异性地结合报告基因自身的启动子区(例如 HIS3 最小启动子),造成"无诱饵也长"的假阳性。其根因是报告盒未做到完全受诱饵控制,需用不同启动子的报告基因交叉验证,确认信号严格依赖诱饵存在。
其三,AD 融合导致错误折叠或核定位失败。AD 与猎物融合可能改变蛋白折叠、暴露疏水区,引发聚集或非特异黏附(表现为假阳性);反之,错误折叠也可能使蛋白无法入核或丧失结合能力,造成假阳性的另一面,假阴性(漏检真实互作)。这一机理提示我们:应测试 AD 融合的 N 端/ C 端两种方向,并用 Western 或荧光报告质控融合蛋白的表达与定位。
治理要点双报告基因(HIS3/ADE2 + LacZ/MEL1)正交确认是降假阳性的核心闸门:两个独立报告机制同时阳性,才能进入下一轮。单一报告阳性一律视为可疑。
在此之上,必须建立空载体与无关 DNA 元件对照体系:空载 AD 对照排除 AD 自身激活;无关诱饵(随机基因组片段或另一无关基因诱饵)对照排除诱饵非特异背景。只有阳性克隆在"目标诱饵 + 空载/无关对照均阴性"的对比中站稳,才算通过第一层治理。我们建议将对照作为每一块筛选板的固定组分,而非事后补做。
6、阳性克隆验证流水线
从一块筛选板上的生长克隆,到一篇可发表的互作结论,中间需要一条严密的验证流水线。我们将其标准化为七步(见图4-3)。
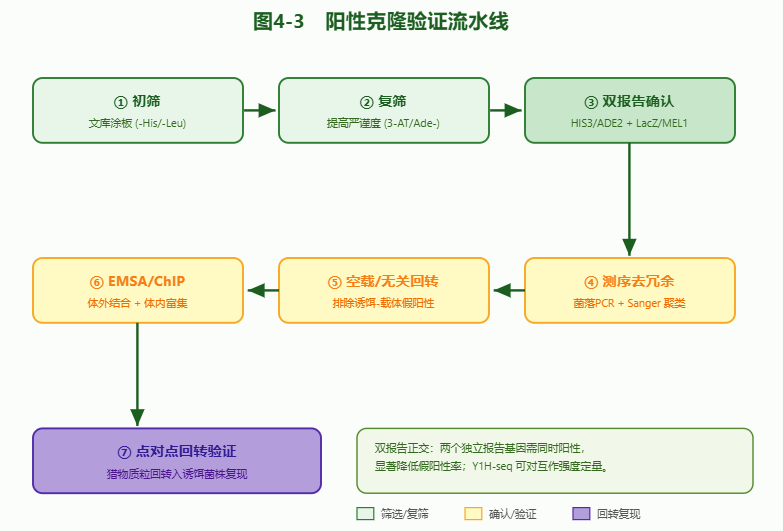
图4-3 阳性克隆验证流水线:初筛 → 复筛 → 双报告基因确认 → 测序去冗余 → 空载/无关 DNA 回转验证 → EMSA/ChIP 体外体内验证 → 点对点回转。颜色区分筛选/复筛(绿)、确认验证(黄)、回转复现(紫)三个阶段。
① 初筛:将文库转化诱饵菌株,涂 -His/-Leu(营养筛选叠加报告筛选),挑取生长克隆。
② 复筛:提高严谨度(补加 3-AT、缺 Ade),以稀释点板方式复现,剔除边缘性与弱生长克隆。
③ 双报告确认:HIS3/ADE2 与 LacZ/MEL1 必须同时阳性,这是正交闸门。
④ 菌落 PCR + 测序:直接对阳性克隆进行菌落 PCR 扩增插入片段,Sanger 测序并与数据库比对。
⑤ 去冗余:按序列聚类,合并相同或重叠 ORF,统计各候选的命中频次,高频命中往往提示强互作或高表达偏倚。
⑥ 空载/无关回转验证:从阳性克隆回收猎物质粒,重新转入诱饵菌株(及阴性对照菌株),确认互作可独立复现、且不依赖原始克隆背景。
流水线后段进入"证据等级跃升"。Y1H-seq 定量:以高通量测序对富集的猎物进行定量,比较不同诱饵或不同处理条件下的互作强度谱,将"有/无"升级为"强/弱"。最终以 EMSA / ChIP 完成体外与体内验证:EMSA 用纯化全长蛋白加标记探针,验证直接结合、测定亲和力,并通过突变基序确认特异性;ChIP 则在植物原生质体或稳定转化株中,在体内验证该蛋白与内源启动子的真实富集。整条链路的收口是点对点回转,将候选猎物逐一重新回转入诱饵菌株,形成"发现—确认—复现—生理验证"的闭环证据。
常见陷阱只做到菌落 PCR 测序就下结论,是新手最易犯的错误。未经验证的"阳性"中,假阳性比例可达三成以上;EMSA/ChIP 这一步虽耗时,却是把筛选结果转化为可信生物学结论的必经关口。
7、双向策略:Gene-centered 与 TF-centered
Y1H 有两种互补的"提问方式",其选择取决于研究问题是以基因为中心还是以因子为中心。
Gene-centered Y1H:以目标基因的启动子/顺式元件为诱饵,从 cDNA 或 TF 文库中筛选其上游调控蛋白。它回答的是"谁在调控我",适合已有明确关注基因、希望解析其调控网络的情形,是植物非生物胁迫、激素信号研究中应用最广的模式。
TF-centered Y1H(反向 Y1H):以转录因子(TF ORF)为诱饵,从随机 DNA 文库(基因组片段文库或合成元件文库)中鉴定其识别的全部顺式元件。它回答的是"我在调控谁",特别适合缺乏 ChIP-seq 数据的非模式物种,无需先验的峰值注释,直接让 TF 在文库中"自报家门",快速绘制其 DNA 识别谱与基序偏好。
两种策略并非互斥,反而高度互补且应联用:Gene-centered 找"谁调控我",TF-centered 找"我调控谁",二者交叉拼接即可构建双向的"转录因子—顺式元件"调控网络,并互相验证(A 被证明结合 B 的元件 ↔ B 的启动子被 A 富集)。我们建议,在构建物种级调控图谱时,以少量核心 TF 开展反向 Y1H 定义基序空间,再以关键靶基因启动子开展正向 Y1H 填充具体边,从而以最小成本获得高覆盖、双向互证的网络。
8、Y1H 的方法学定位
清醒认识 Y1H 的能力边界,才能把它放在正确的方法组合里。它与 luciferase 报告、EMSA、ChIP 是互补而非替代关系。
Y1H 最独特的能力,是能检出不直接激活转录的 DNA 结合蛋白,仅结合 DNA 却不驱动转录的抑制因子、脚手架蛋白或结构结合蛋白,用 luciferase 类激活报告根本无法发现,而 Y1H 基于"结合即激活报告"的逻辑天然兼容。此外,Y1H 具备 isoform 特异性检测优势:将同一基因的不同可变剪接 isoform 分别构建 AD 融合,可清晰区分究竟是哪一个 isoform 负责 DNA 结合,这是群体层面实验难以分辨的。
但其弱点同样来自 AD 融合:AD 可能制造非天然互作(假阳性),也可能因折叠阻碍而漏检(假阴性),因此一切 Y1H 阳性都需体外/体内验证收口。另一个常被忽略的对比是翻译后修饰,Y1H 在活细胞内进行,保留了磷酸化等影响 DNA 结合的修饰背景,而 EMSA 通常使用体外纯化蛋白,容易丢失这一生理维度;当然,也正因为体内环境的复杂,Y1H 对弱/瞬时的修饰依赖互作有时反而噪声更大。ChIP 作为内源生理验证的金标准,与作为互作发现工具的 Y1H 形成"发现—确证"的最佳搭档。
| 方法 | 能回答的问题 | 相对 Y1H 的互补/局限 |
|---|---|---|
| Y1H | 某 DNA 是否结合某蛋白(含非激活型结合) | 基准发现工具;受 AD 融合假象影响 |
| Luciferase 报告 | 该互作是否驱动转录激活 | 仅检激活型,漏掉抑制/支架结合 |
| EMSA | 直接结合与亲和力、基序特异性 | 体外、常缺翻译后修饰背景 |
| ChIP | 体内内源启动子是否被富集 | 金标准验证;依赖抗体与峰值注释 |
就项目周期,我们给出 6–10 周的阶段规划供参考:第1–2周完成诱饵设计与载体构建;第3周构建诱饵整合菌株并行自激活检测与 3-AT 滴定;第3–5周进行文库转化、初筛与复筛;第5–7周完成阳性克隆测序去冗余与双报告确认;第7–8周回转验证并开展 Y1H-seq 定量;第8–10周以 EMSA/ChIP 完成生理验证,并整合数据构建调控网络。该节奏假设诱饵设计一次成型;若需多轮换片段,周期应顺延 2–3 周。
9、案例讨论
植物非生物胁迫响应启动子筛选
以 RD29A、COR15A、DREB 类胁迫诱导启动子为对象时,推荐采用"~300 bp 近端截短 + ABRE/DRE 基序 3× 重复"的诱饵组合,从拟南芥或水稻 TF 库筛 ABA、干旱、低温响应因子。关键经验有三点:其一,胁迫诱导型启动子常含多个协同元件(如 ABRE 与 DRE 并存),单一截短易遗漏,应并行设计不同区域截短诱饵;其二,3-AT 滴定窗口因诱饵而异,重复诱饵普遍需要更高浓度的 3-AT;其三,阳性候选必须经原生质体瞬时表达 + ChIP 或 EMT 验证,否则难以区分体外结合与体内生理相关性。
病毒 EBV Cp 启动子与 ZNF350 调控因子鉴定
在以 EBV Cp 启动子片段为诱饵、从人 cDNA 文库筛选结合蛋白并鉴定 ZNF350 等调控因子的研究中,最突出的挑战是病毒强启动子极易自激活。处置顺序是:先用高浓度 3-AT 压制,若仍失控则换用 Cp 启动子的不同截短片段(避开其最强组成型激活区),最后才考虑切换报告系统。人源筛选应使用商品化 TF/cDNA 库以保证覆盖度,并以空载 AD 与无关病毒启动子片段作为平行对照,排除病毒序列特有的非特异背景。该案例也印证了前文观点,自激活治理中,"换诱饵片段"始终是性价比最高的第一选项。
进阶 Y1H 的核心不是"把平板养出来",而是用整合型系统压背景、用策略性诱饵提发现率、用 3-AT 与双报告治假阳性、用"回转 + EMSA/ChIP"闭环验证。把这四道闸门串成标准流水线,才能把筛选产出转化为可信的调控生物学结论。
最新动态
-
09.28
表面等离子共振(SPR)实验避坑指南:从缓冲液优化到伪影辨别
-
09.28
酵母单杂交(Y1H)筛选:诱饵设计、假阳性治理与阳性结果验证体系
-
09.28
RNA Pull-down实验:探针设计、条件优化与结果深度解读
-
09.28
RNA合成技术:从固相化学到长链修饰RNA的制造路线
-
09.24
重组蛋白表达系统的工程化与纯化路径优化
-
09.24
表面等离子共振(SPR)技术在分子互作分析中的应用
-
09.24
qRT-PCR实验的优化与数据解读
-
09.24
DNA测序技术的进阶应用与临床转化
-
09.24
ELISA试剂盒定制开发与质量控制——从抗体制备到批间差控制,定制化检测方案
-
09.23
DAP-seq技术:从体外蛋白表达到Motif分析,植物转录因子研究的利器
 X